

Claude Fable 5.2のプロンプトの書き方は、Anthropicが公式ガイド「Claude Fable 5.2へのプロンプト」で公開しています。
このガイドは、良いプロンプトの例文集ではありません。前のモデルと動作が異なる箇所を症状ごとに並べ、対処を示した文書です。対象はClaude Fable 5.2とClaude Mythos 5.2です。
この記事は、ガイドの内容を、会社でClaudeを使う人の作業の順序に並べ替えて解説します。数値はすべてガイドに記載されたAnthropicのテストの結果です。
結論を先に書きます。
- エフォートは high から始めます。 能力の向上の大部分は high で得られるとガイドは書いています。思考を減らしたい場合は、プロンプトで頼むのではなくエフォートを下げます
- 新しい文面を追加する前に、以前のモデル向けの指示を削除します。 委任の指示、思考を減らす指示、厳格な文体のルール、蓄積したメモが対象です
- 症状を 1 件ずつ対処し、効果とコストを測定します。 公式の文面には、出力トークンが 20〜80 パーセント増えるものがあります
ガイドの読み方。症状から節を選ぶ
ガイドの冒頭には、観察された状況と対応する節の一覧があります。全部を順に適用する文書ではなく、自社のエージェントで起きた症状に対応する節だけを使う構成です。
一覧にある症状は次の 9 件です。
- どのエフォートで実行するか決められない、または簡単な依頼の開始が遅い
- 作業が完了する前にターンが終了する
- コーディングエージェントが既存のコードを複製する、または問題を報告するだけで放置する
- 長いターンの間、応答がないように見える
- タスクに必要な数を超えるサブエージェントを起動する
- 不要な承認を求める、または日常的な作業を控える
- システムプロンプトやスキルが Claude Fable 5.1 か Claude Opus 5.5 向けに書かれている
- 長いタスクの後の最終レポートや引き継ぎの資料を人が読む
- リクエストが
stop_reason: "refusal"を返す
ガイドの文面の多くは、システムプロンプトへの追加か、ツールの説明の変更です。APIでエージェントを構築する開発者が主な読者です。
ただし、対象はシステムプロンプトだけではありません。ガイドは、スキル、エージェントファイル、メモリファイル、メモも見直しの対象に挙げています。指示のファイルを自社で管理している会社にも関係します。
変更は新しい会話で行う
ガイドは、文面の追加と削除を新しい会話でだけ行うよう求めています。保存済みの会話のシステムプロンプトやツールを変更して再開すると、400 エラーになる場合があるためです。
会話の途中で指示を変更する場合は、最新のターンに指示を入れます。
エフォートは high から始める
Fable 5.2 では、エフォートのレベルが、思考の量、ツール呼び出しの回数、ターンの所要時間、トークンの使用量を決定します。ガイドは、エフォートをプロンプトと合わせて調整するよう書いています。
出発点は、Claude APIでの Fable 5.2 のデフォルトである high です。そこから、自社の評価でテストしながら上下させます。
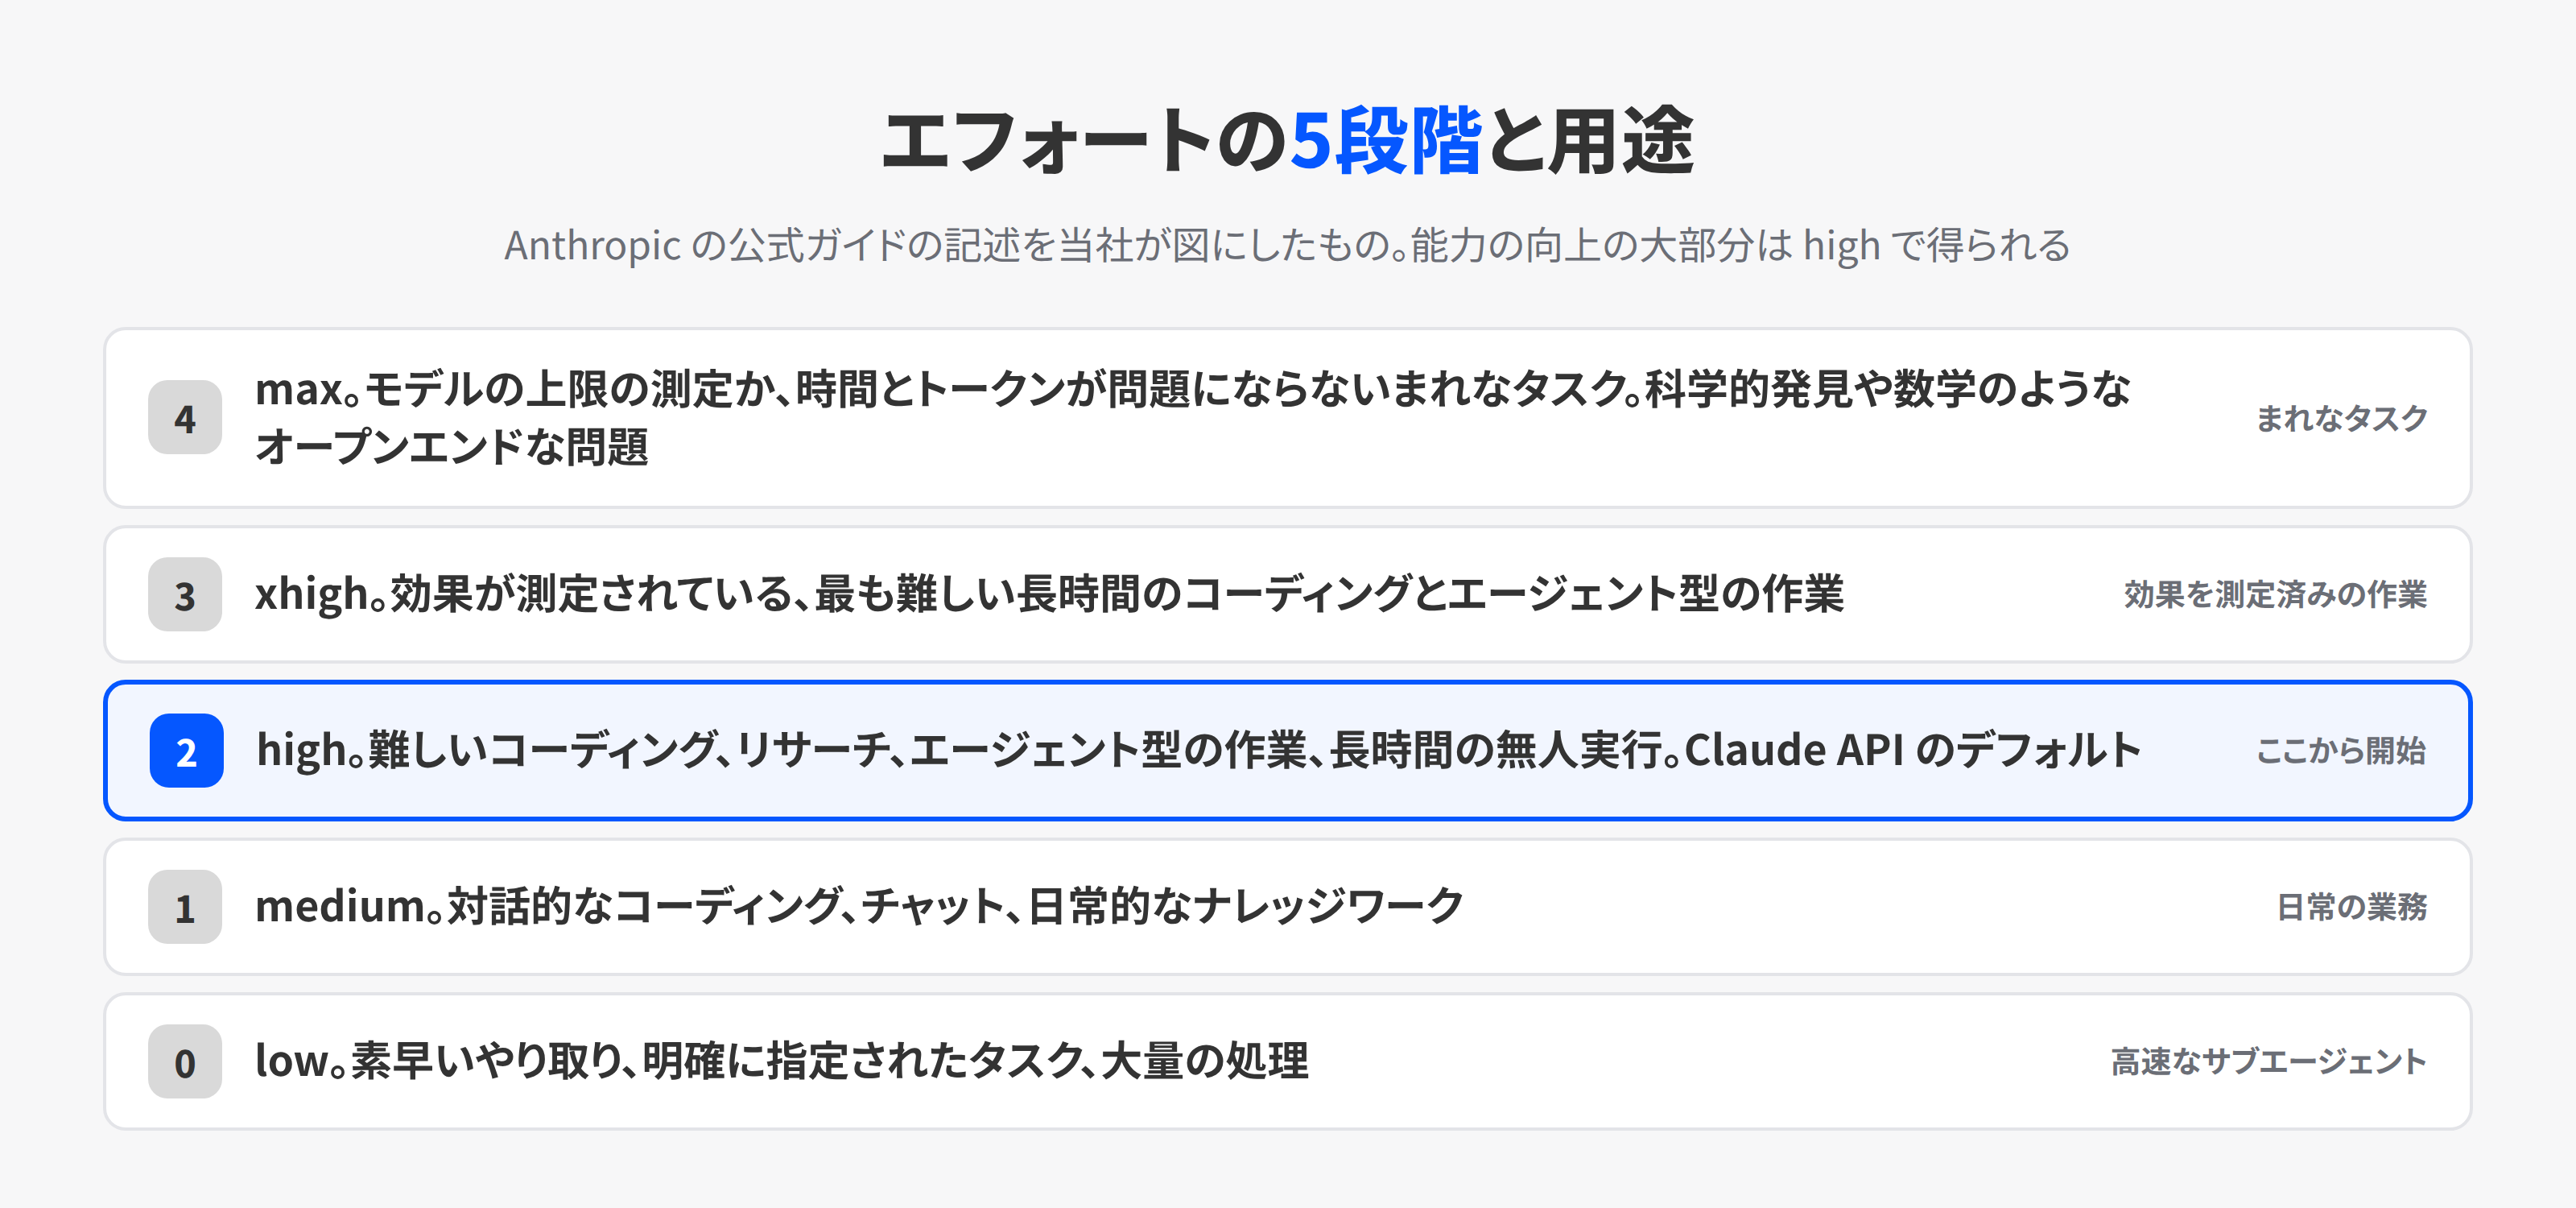
前のモデルで調整した設定は引き継げません。レベルの順序はClaudeのモデル間で同じですが、各レベルでの思考の量は異なる場合があるとガイドは書いています。
Fable 5.1 や Opus 5.5 の設定をそのまま使用せず、比較を再実行します。
能力の向上の大部分は high で得られる
ガイドによると、medium から high への段階で、Anthropicが追跡しているコーディングとナレッジワークの評価のほとんどでスコアが上昇しました。
この段階ではトークンと時間も増えます。自社の評価で品質が維持される場合は medium に下げるよう、ガイドは勧めています。high を超えると、効果はタスクに依存してばらつきます。
low の評価も変わりました。コーディングの評価で、Fable 5.2 は low でも過去のモデルより優れた結果を出し、Fable 5.1 がより高いエフォートで記録したスコアに近い値を達成したとあります。
思考を減らしたい場合はエフォートを下げる
high 以上では、モデルは挨拶への返答を含め、ほぼすべての返答の前に思考します。簡単な依頼に時間やコストがかかる場合は、そのターンに低いエフォートを使用します。
プロンプトでは解決しません。Anthropicのテストでは、熟考せずに直接答えるよう指示しても、medium 以上ではモデルの思考は止まりませんでした。
もう 1 点、エフォートは応答の長さにほとんど影響しません。返答の長さやトーンを変更する手段は、プロンプトです。
1 つのワークフローの中でレベルを組み合わせることもできます。ガイドの例は、medium で計画と反復を行い、長い無人の部分でエフォートを上げる方法です。
会話の中でレベルを変更し、プロンプトキャッシュも維持する場合は、メッセージごとのエフォートの機能を使用します。この機能はベータです。
以前のモデル向けの指示を、追加の前に削除する
ガイドの「どこから始めるか」は、エフォートの設定の次に、引き継ぐ指示を読む作業を置いています。新しい文面の追加は、その後です。
Anthropicのテストでは、以前のモデル向けに設計された指示や介入の一部が、コストを増加させるか、副作用を発生させるか、効果を失いました。ガイドが再検討の対象に挙げた項目は 7 件です。
| 項目 | Fable 5.2 での動作 | ガイドが示す対処 |
|---|---|---|
| 常設の委任の指示 | 委任が多すぎる場合がある | 移行の前にファイルを読み、不要になった行を削除 |
| モデルに表示するトークン予算 | 予算の大きさが消費量を変える | 予算の表示なしでタスクをテスト |
| 以前のターンを編集するハーネス | 編集した箇所より後の思考ブロックが無効になる | 履歴は追記だけにする。短縮はコンテキスト編集かコンパクションで行う |
| 「以前の回答は完了として扱う」の行 | 思考は減るが、自分の誤りを指摘しにくくなる | 再検討を続けてほしい場合は省略 |
| 思考を減らす指示 | medium 以上では思考が止まらない |
行を削除し、エフォートを下げる |
| 厳格な文体のルール | 忠実に従うため、文章がぎこちなくなる | 不要になったルールを削除 |
| 蓄積したルール、メモ、記憶 | 忠実に従うため、不要な承認が増える | 理由が当てはまらない注意事項を削除 |
表の中から、会社で発生しやすい 3 件を説明します。
トークン予算の表示
一部のハーネスは、タスクのトークン予算と残量をモデルに表示します。ガイドによると、その予算の大きさが、Fable 5.2 の消費量を変えます。
high と xhigh でのコーディングタスクのテストでは、大きな予算の表示を削除するとコストが下がり、性能は同等でした。
この結果はプロンプトの中のテキストについてのものです。APIのタスクバジェットというベータの機能は、テストの対象外だったとガイドは明記しています。
以前のターンを編集するハーネス
Fable 5.2 は、保持された思考という機能を使用します。ハーネスがリクエストの間でシステムプロンプト、ツール、以前のメッセージを変更すると、変更した箇所より後の思考ブロックは無効になります。
デフォルトでは、その場合に Messages API はリクエストを拒否します。Message Batches API は該当のブロックを除外します。
履歴を短縮する場合は、コンテキスト編集か、要約の後に以前のターンを保持しないコンパクションを使用します。それ以外では、履歴を追記専用に保つようガイドは求めています。キャッシュのヒット率が高く保たれ、思考も除外されません。
厳格な文体のルール
Fable 5.2 は、文体のルールに忠実に従います。ガイドの例は「1 文につき 1 つの指示、20 語以内」です。このような厳格な制限があると、文章がぎこちなくなる場合があります。
前のモデルが従わなかった分を補うために強く書いたルールは、Fable 5.2 では強すぎる結果になります。後述のレポート用の文面を追加する前に、不要になったルールを削除します。
途中で停止する場合。完了まで進める文面と承認の返し方
長い複数ステップのタスクで、Fable 5.2 は作業が完了する前にターンを終了することがあります。残りの作業を一覧にする、続行を申し出る、タイムアウトのような通常の障害で停止する、という終わり方です。
この停止は low と medium で多く発生します。ガイドは、システムプロンプトに追加する「Finishing work」という見出しの文面を掲載しています。文面の要点は次の 3 つです。
- 依頼された作業が残っている間は停止しない。利用者の回答に依存しない部分は進める
- エラー、タイムアウト、ロックされたファイル、失敗するツールのような通常の障害は、原因を診断して別の手段で進める
- 変更禁止と明示されたファイルや、意図的に与えられていないアクセスは、そのままにして報告する
通常の障害と、人が意図して設定した制限を区別している点が、この文面の中心です。前者は自力で解決し、後者には手を付けません。
効果の数値も記載されています。Anthropicは、エージェント型コーディング製品の記録済みのセッションを medium で再生しました。
この文面のあるバージョンでは、続行できたのに未完了で終了したセッションが約半分になりました。
限界も書かれています。許可を求める終わり方と続行を申し出る終わり方の大部分はなくなりましたが、残りの作業を一覧にして停止する終わり方は残りました。出力トークンは約 30 パーセント増加しました。
確認のステップは自社で維持する
この文面は、モデルが確認を求める頻度を下げます。ガイドは、リスクのある操作と元に戻せない操作について、独自の確認のステップを維持するよう書いています。文面を追加する前に、確認が必要な操作を一覧にしておきます。
承認は「continue」ではなく、操作を具体的に書く
作業の続行を依頼する場合、ガイドは、単に「continue」と送らず、求める内容を正確に伝えるよう書いています。
ガイドの例では、「go」や親指を立てた絵文字の代わりに、「はい、ステージングデータベースでマイグレーションを実行してください」と返答します。
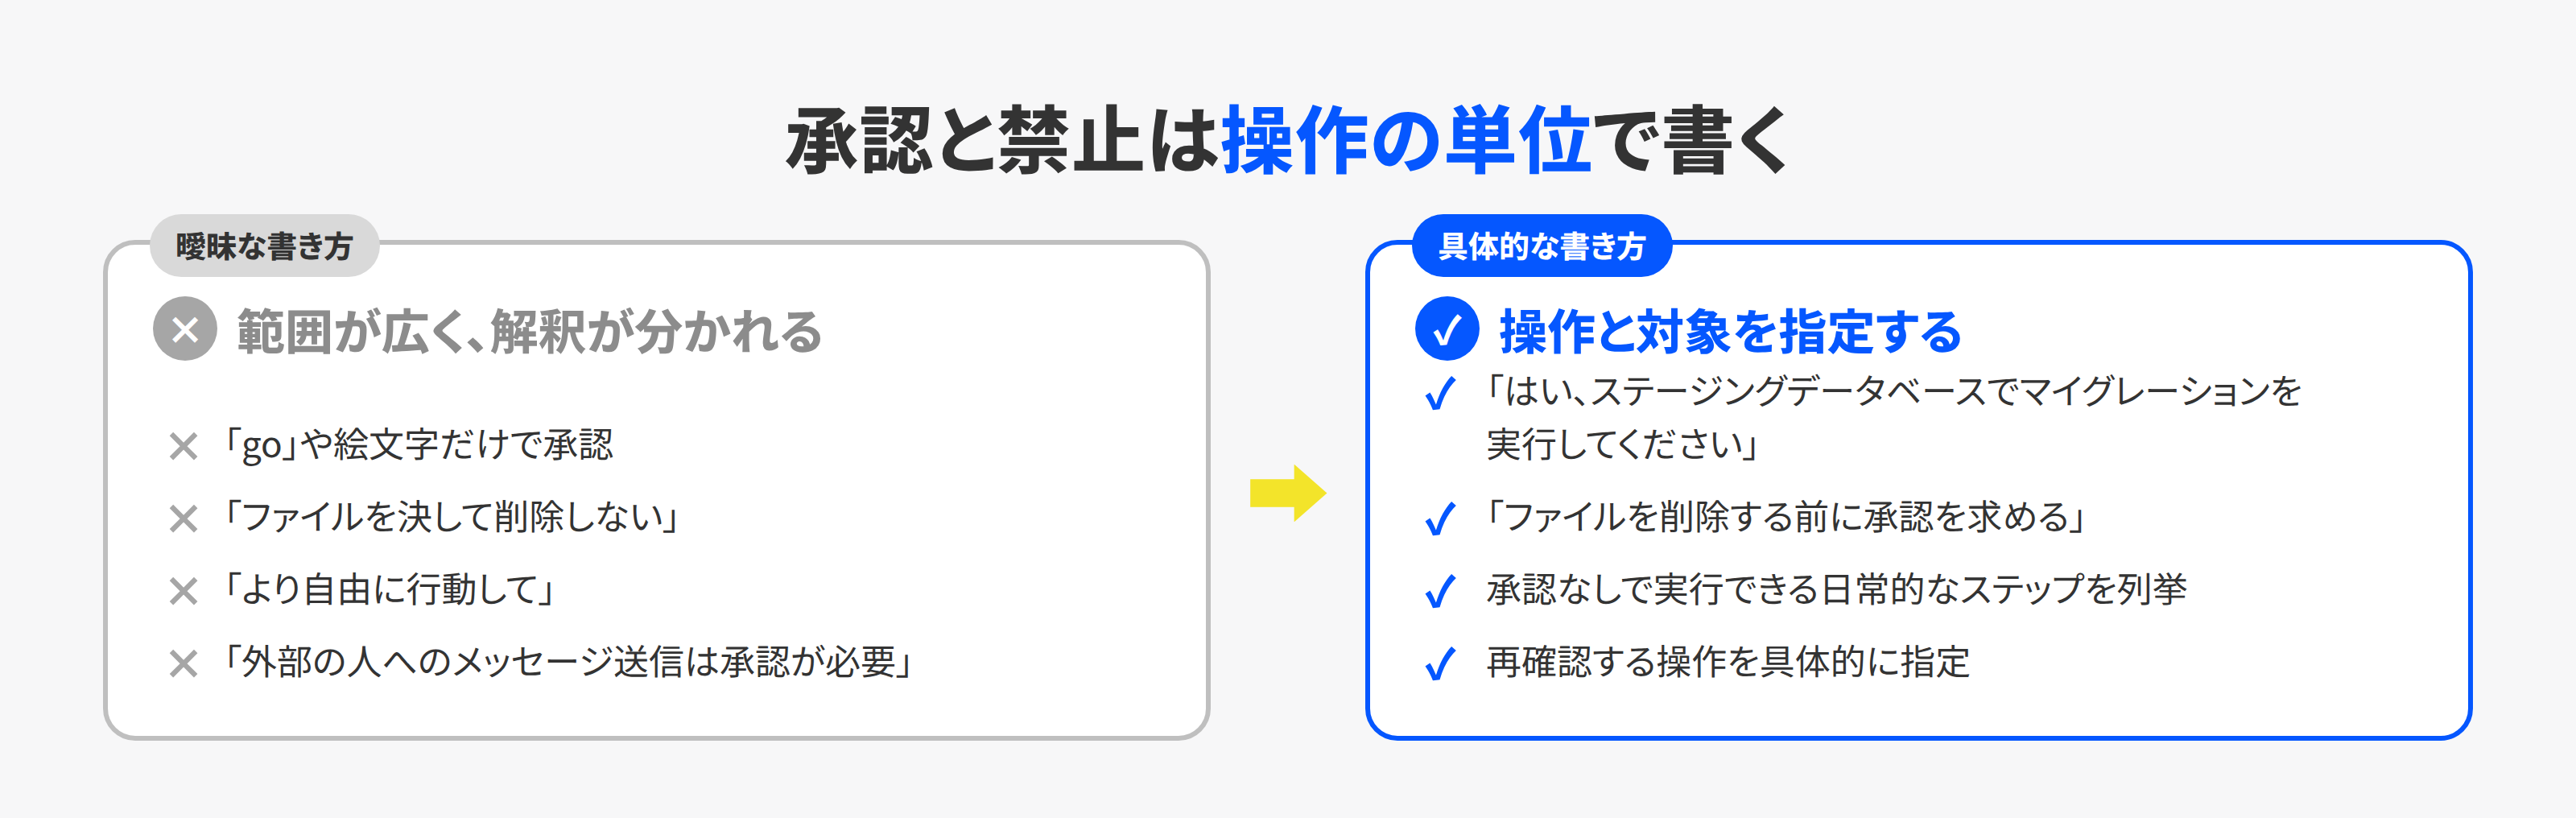
システムプロンプトに承認のルールを書く場合も同じです。再確認してほしい操作を具体的に示します。
範囲の広いルールは、日常の業務を停止させます。Anthropicは、承認が必要なステップに「この会話の外部の人にメッセージを送信すること」を挙げたルールをテストしました。
このルールによって、モデルは同僚や他のチームへの日常的な依頼の約半分を控えました。
承認を求めすぎる場合。蓄積した注意事項を整理する
慎重な指示は、メモリ、メモ、指示のファイルを通じて、過去のセッションから蓄積します。Fable 5.2 はこれらの指示に忠実に従うため、不要な承認を求める結果になる場合があります。
Anthropicは初期のテストで、この現象を主に複数のエージェントが連携する環境で確認したと書いています。対処は 4 つです。
- 不要になったメモを削除する。 メモリには「決して再試行しない」のような古い指示が残っている場合がある
- 承認が不要なステップを明記する。 「より自由に行動して」は曖昧なので、モデルが自分で実行できる日常的なステップを列挙する
- 検証のステップを確認する。 「最初のエラーで停止してレビューする」のような条件は、不要なら削除するか範囲を限定する
- 例外を明示する。 モデルは「never」を含む指示を絶対的なものとして扱う
4 つ目の例は実務で使用できます。ある操作の責任をモデルに持たせる場合、ガイドは「ファイルを決して削除しない」ではなく「ファイルを削除する前に承認を求める」と書くよう示しています。
蓄積したメモの一部は、モデル自身が書いた可能性もあるとガイドは指摘しています。絶対的なルールは、範囲と理由を含めて書き換えます。
システムがすでに行き詰まっている場合の対処も書かれています。メモリとメモを整理したうえで再起動することを検討します。
コードを複製する場合。所有者を 1 文で伝える
Fable 5.2 は、作業の対象のコードの所有者が誰かに注意を払います。
Anthropicの小規模なコーディングタスクのテストでは、プロンプトが所有権に触れていない場合と、コードベースを他者のものとして提示した場合に、モデルは既存の構造に追加する傾向がありました。既存のコードと重複する場合でも同じです。
作業と同時に構造を改善してほしい場合は、コードがモデル自身のものだと伝えます。ガイドの文面は次の 1 文です。
You are the owner and long-term maintainer of this codebase, and its design is up to you.
テストでは、この文がない場合、モデルが重複したコードを 1 つの共有関数に統合した実行は 10 パーセント未満でした。この文がある場合は約 75 パーセントでした。
コストも大きく変わります。出力トークンは約 70〜80 パーセント増加し、モデルは誰も求めていない変更を行いました。多くは新しいテストとドキュメントで、一部の実行では既存の機能の動作も変更しました。
最後のPRの要約では、小さな変更が省略されることが多かったとガイドは書いています。差分と要約の両方を確認します。
利用者がコードを所有していて、変更を最小限にしたい場合は、この文を使用しません。範囲を制限するルールでは打ち消せないためです。
同じプロンプトの前方に「No drive-by refactors, renames or cleanups」と書いても、モデルは実行の半分以上で重複したコードを統合しました。
進捗が見えない場合。表示の設定を先に確認する
Fable 5.2 は、長いツール呼び出しの連続の間、利用者向けのテキストをほとんど書かないことがあります。何をするかを伝えずに最初のツール呼び出しを行うこともあります。
最初に確認する対象は、プロンプトではなくクライアントです。Fable 5.2 では、モデルがツール呼び出しの間に書く更新は、進捗更新の thinking ブロックとして返されます。
thinking.display のデフォルトは "omitted" で、この設定ではテキストが空になります。text ブロックだけを表示するクライアントは、長いターンの間、応答がないように見えます。
各更新の短い要約を受信する設定は display: "updates" です。この設定はベータです。要約された推論と更新の両方を受信する設定は "summarized" です。
そのうえで、頻繁な更新が重要な対話型の環境向けに、ガイドは 3 つの方法を示しています。
| 方法 | 文面と方法 | Anthropicのテストの結果 |
|---|---|---|
| ハーネスの変更 | 読める出力のないツール呼び出しが数回続いた後に、短いリマインダーをシステムメッセージとして追加 | 最長の無言の区間が約半分。トークンと時間の目立った増加なし |
| 意図の表示 | 開始の前に 1 行で予定を述べ、最後に単体で読める要約を書くよう、システムプロンプトに追加 | すべての実行で最初のツール呼び出しの前にメッセージ。出力トークンは約 20 パーセント増加 |
| システムプロンプトの 1 文 | 「Every few tool calls, give the user a one-line update on where things stand.」 | ワークフロー自動化のタスクで、長い無言の区間の大部分が解消 |
1 つ目の方法は、会話の途中のシステムメッセージに対応したプラットフォームで使用できます。
追加したリマインダーは、以降のリクエストでも履歴に残します。削除や言い換えは以前のターンの編集になり、その後の思考ブロックが無効になります。
3 つを併用しても、更新の間に数回のツール呼び出しが続くことは想定するよう書かれています。Anthropicは、頻繁な更新を誰も必要としない長時間の非同期タスクに、このモデルを推奨しています。
サブエージェントが多すぎる場合。ツールの説明にコストを書く
Fable 5.2 がどれだけ委任するかは、ハーネスとタスクによって変わります。
最小限のサブエージェントのツールを使用した短いタスクのテストでは、起動はほとんどありませんでした。プロンプトが委任を促すエージェント型コーディング製品では、積極的に委任しました。
初期のテスターは、Fable 5.2 を他のモデルのプランナーとオーケストレーターとして使用し、良好な結果を得たとあります。並列で実行できる作業は、委任で高速になります。
注意点はコストです。サブエージェントはセッションのコストの大部分を占める可能性があります。ガイドは、サブエージェントがデフォルトで使用するモデルを確認するよう書いています。
委任が多すぎる場合の対処は、次の順序です。
- システムプロンプト、スキル、エージェントファイルにある委任の指示を先に見直す
- それでも多い場合に、サブエージェントのツールの説明を変更する
- 説明には、サブエージェントがセッションのコストに加える量、委任する価値がある場合とない場合、サブエージェントへの指示の与え方を書く
high でのAnthropicのテストでは、コストに焦点を当てた長めの説明によって、短いバージョンと比べてサブエージェントの数が約半分になりました。
ツールの説明が簡素で、プロンプトのほかの部分でも委任を求めていない場合は、新しい説明はおそらく不要だとガイドは書いています。
最終レポートを、作業を見ていない人が読める文章にする
初期のテスターは、Fable 5.2 の文章を Fable 5.1 より高く評価し、明瞭さは Opus 5.5 と同程度と評価しました。
それでも、長いエージェント型の作業の後のレポートには固有の問題があります。読む人は、背後のツール呼び出しやファイルを見ていません。レポートは単体で意味が通じる必要があります。
ガイドは、「Communicating clearly」という見出しの文面を掲載しています。要点は次のとおりです。
- 知的だが文脈を持っていない読者に向けて書く
- 要点を最初の数文に置く
- 作業の中で自分が作成した用語や略語を使用しない
- 短い文、1 文に 1 つの内容、能動態、同じ対象には同じ語
- 関連する内容は文章で書き、箇条書きは独立した項目の一覧に使用する
Anthropicのエージェント型タスクのテストでは、この文面によって最終レポートの密度が下がり、セミコロンの数が減りました。ワークフロー自動化のタスクでは、文も短くなりました。
長さの指示や、特定の詳細を含める依頼を追加することもできます。読者と製品に合わせて調整する前提の文面です。
拒否が返る場合。カテゴリを読む
Fable 5.2 は、リクエストを拒否する可能性のある安全性の分類器を実行します。
拒否されたリクエストは stop_reason: "refusal" を返し、stop_details.category がカテゴリを示します。
カテゴリは、cyber、bio、frontier_llm、reasoning_extraction、general_harms、名前付きのカテゴリに対応しない null です。
プロンプトの書き方に関係するカテゴリは reasoning_extraction です。モデルの内部の推論を応答のテキストに再現するよう求めるリクエストが該当します。
プロンプト、スキル、ツールの説明が、応答の中に推論を書き出すよう求めている場合は、その指示を削除します。推論を確認する手段は、display: "summarized" を設定して思考ブロックを読む方法です。
無害なサイバーセキュリティやライフサイエンスの作業でも、cyber と bio の分類器が作動する場合があります。正当な作業が停止する組織向けに、Anthropicは検証のプログラムを案内しています。
始める順序。公式の 4 ステップ
ガイドの最後の節は、移行でこの内容を適用する順序を示しています。
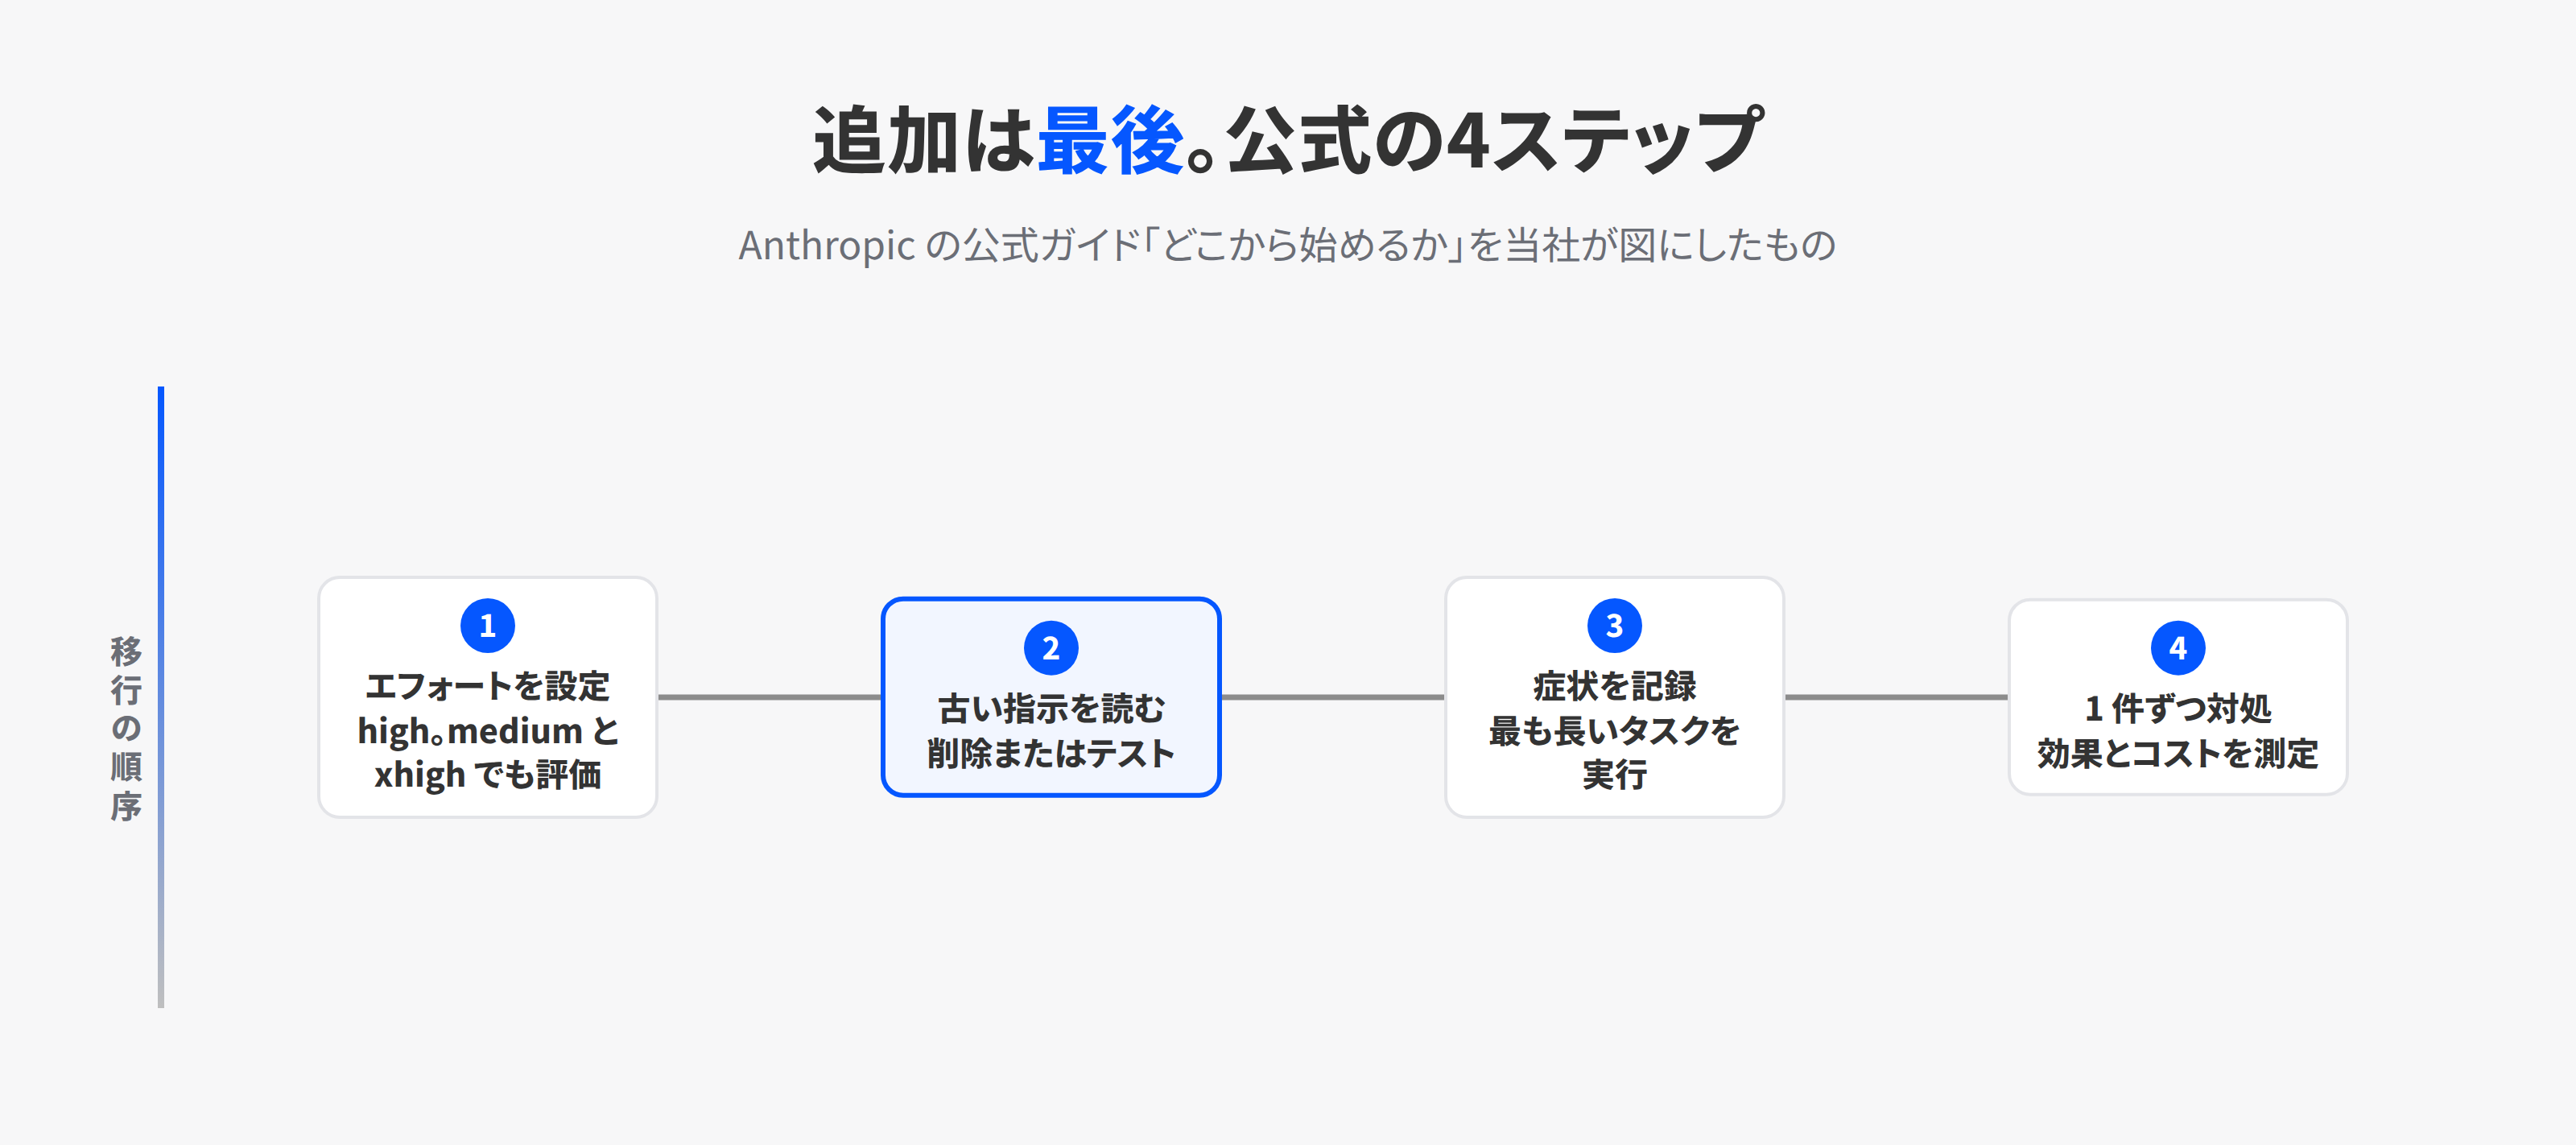
4 ステップの内容は次のとおりです。
effortを明示的にhighに設定し、mediumとxhighでも評価を実行する- 引き継ぐシステムプロンプト、スキル、エージェントファイル、メモリファイル、メモ、ハーネスのテキストを読み、以前のモデル向けの内容を削除またはテストする
- 最も長いエージェント型タスクを実行し、症状が出た箇所を記録する。早期の停止、不要な承認、無言、過剰な委任、再構成してほしかったコードへの追加
- 観察した動作ごとに 1 件ずつ対処し、自社のタスクで効果とトークンコストを測定する
追加は最後です。先にエフォートを決定し、古い指示を削除し、実際のタスクで症状を観察します。その後に、症状に対応する文面だけを追加します。
1 件ずつ対処する理由は、ここまでの数値を見ると明確です。完了まで進める文面で約 30 パーセント、意図の表示で約 20 パーセント、所有者の文で約 70〜80 パーセント、出力トークンが増加します。
全部を同時に追加すると、どの文面が効果とコストを生んだか判別できません。
会社の運用に置き換える。指示のファイルの棚卸し
ここからは当社の見解です。
このガイドは開発者向けですが、APIを直接使用しない会社にも関係する箇所があります。指示のファイルの棚卸しです。
AIエージェントを業務で使用している会社には、指示のファイルが蓄積しています。プロジェクトのルール、スキル、メモリです。事故のたびに「必ず確認する」「決して実行しない」を追加した結果、ルールが増えた会社は多いはずです。
ガイドの内容を運用に置き換えると、確認する項目は 3 つになります。
- 「決して」「絶対に」と書いたルールに、範囲と理由があるか。 範囲のない禁止は、関係のない作業まで停止させる
- 承認が必要な操作と、承認なしで実行できる操作が、両方とも列挙されているか。 片方だけでは、モデルは慎重な側に判断する
- 理由が当てはまらなくなった注意事項が残っていないか。 前のモデルの弱点を補うために書いた行が対象
当社は、スキルを、下位のモデルでも実行できる手順書として書いています。手順とチェックリストを明示する書き方です。
この書き方は、Fable 5.2 でも維持しています。手順の明示と、範囲のない禁止は別のものだからです。手順は「何をどの順序で行うか」を伝えます。削除する対象は、理由を失った禁止と、文体の過剰な制限です。
当社のメモリのファイルも、同じ主題のメモを定期的に 1 件に統合しています。件数が増えると、古い指示と新しい指示が矛盾するためです。
モデルは今後も変わります。そのたびに外部の例文を探すより、自社の指示を自社で棚卸しできる状態のほうが、移行のコストは小さくなります。
まとめ
Claude Fable 5.2 のプロンプトの書き方について、公式ガイドの要点は次のとおりです。
- エフォートは
highから。思考を減らす場合は、プロンプトではなくエフォートを下げる - 以前のモデル向けの指示を、追加の前に削除する。委任、トークン予算、思考を減らす指示、厳格な文体、蓄積したメモ
- 途中で停止する場合は、完了まで進める文面を追加する。確認のステップは自社で維持する
- 承認は操作を具体的に書く。「never」は「承認を求める」に書き換える
- 所有者の文、意図の表示、完了まで進める文面は、出力トークンを増やす。1 件ずつ測定する
指示のファイルを自社で管理している会社は、モデルを切り替える前に、ファイルを一度通読してください。作業はそこから始まります。