
2026年9月15日に公開されたJevは、文章を書かずに判断と確率だけを返すAIです。何ができるモデルかは前の記事にまとめました。この記事はその続きで、当社が自社の運用にJevを組み込んだ手順と、最初の結果を書きます。
鍵を受け取ったのは9月17日の夜で、その日のうちに既存の仕組みへ並走させるところまで動かしました。導入そのものは半日です。時間がかかったのはコードではなく、質問をどう書くかを決める部分でした。
扱う内容は、何を置き換える対象に選んだか、質問の設計、Pythonからの呼び出し方、確信度で分ける設計、最初の8件の結果、設計の学び、次に移す判断と移さない判断、そして自社で始めるときの手順です(確認日: 2026年9月19日。早期アクセス段階で仕様も価格も変わり得るため、公式ドキュメントで最新の状態をご確認ください)。
先に結論を3つ書きます。
- 導入は半日で済みます。APIは1本、Pythonの標準ライブラリだけで動きます。難しいのは、判断の基準を選択肢ごとの説明として言葉にする作業です
- 最初の8件は、1件あたり0.45〜0.75秒、約1,100トークン、費用は1件約0.007円でした。人の確定判定と比べると、7件が一致し、1件が食い違いました。食い違った1件は、質問の書き方に原因があると見ています
- 置き換えの可否は感覚で決めず、既存の判定と並走させて一致率を測ってから決めます。当社は一致率が1週間90%を超えたら一次判定をJevに移す、と先に決めました
何を置き換えたか
当社は、MicrosoftとGoogleの公式ブログを週に1回自動で集め、1本ずつ4つに分けています。自社の仕組みにすぐ反映するもの、研修の題材にするもの、ブログやSNSで発信するもの、見送るもの、の4択です。この判定は、これまで高性能な生成AIに要約を読ませて行っていました。
この工程を最初の対象に選んだ理由は3つあります。答えが4つに決まっていること。毎週同じ形で繰り返すこと。そして、判定の正解があることです。週次のレビューで本人が判定を確定するので、Jevの答えと突き合わせれば一致率が出ます。
もう1つ、間違えても損失が小さいことも大事です。仮に分類を誤っても、週次のレビューで人が目を通すので、そこで直ります。取り返しのつかない判断から始めるべきではありません。
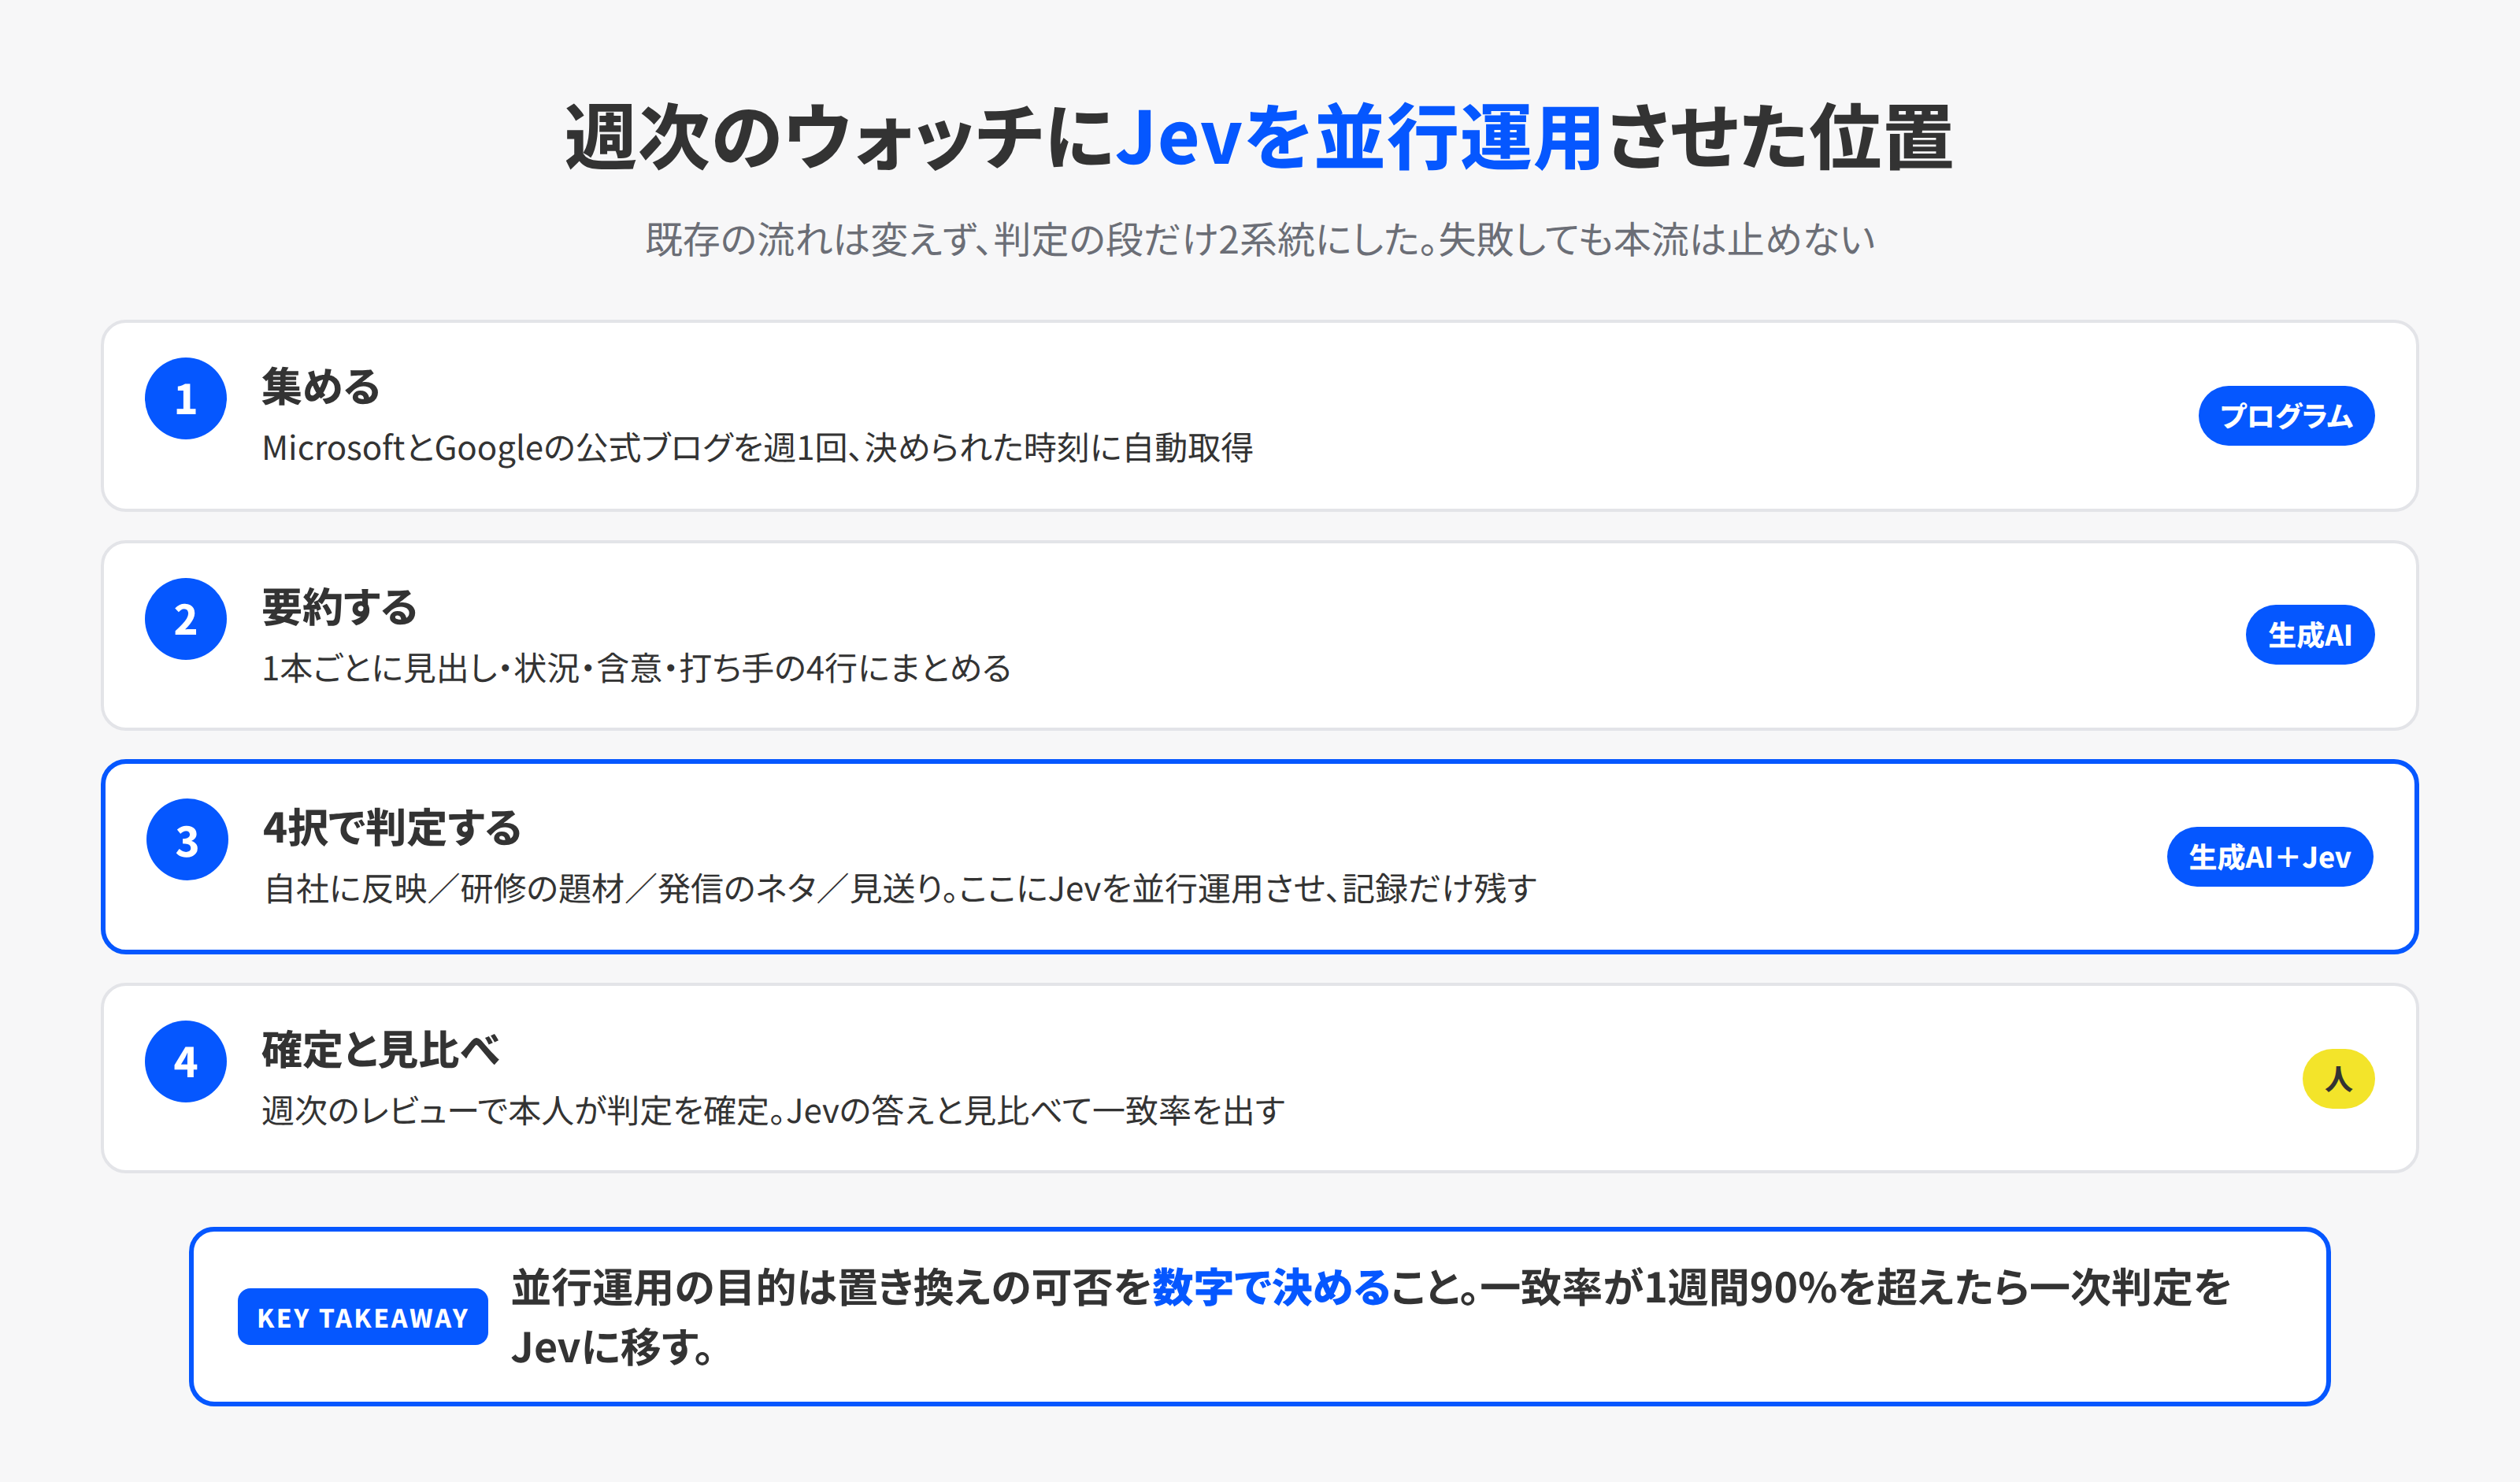
置き換えではなく並走にしたのは、置き換えの可否を数字で決めるためです。既存の判定はそのまま動かし、Jevには同じ入力を渡して答えを記録だけします。Jevの呼び出しが失敗しても本流は止めません。鍵が無ければ何もせずに終わり、APIがエラーを返しても記録に残して次へ進みます。
質問の設計。3つを1回で聞く
Jevに渡すのは、状況(state)と質問(questions)です。状況には、1本の記事につき見出しと、状況・含意・打ち手の3行の要約を渡します。記事の全文は渡しません。公式ドキュメントに、判断と関係のない内容が多いほど精度が落ちると明記されているためで、費用の面でも要約だけで十分でした。
質問は3つを1回のリクエストにまとめました。Jevは全部の質問を同じ状況に対して並列に評価するので、質問を増やしても応答時間はほとんど変わりません。
{
  "verdict": {
    "type": "choice",
    "instructions": {
      "task": "この記事を、法人向けAI・DX支援を行う小さな会社がどう使うかを1つ選ぶ",
      "rule": "複数に当てはまるときは、より具体的な行動につながる方を選ぶ。読んでも行動が変わらない記事は skip"
    },
    "criteria": {
      "self": "自社の仕組み・運用・営業にすぐ効く(設定変更や方針変更につながる)",
      "training": "研修・セミナー・顧客向け説明の題材になる(製品の機能変更、経営者向けの事例、統制や権限の話)",
      "sns": "ブログ・X・noteのネタになる(読者の困りごとに直結するが、自社にも研修にも直接は効かない)",
      "skip": "どれにも当たらない、または既知の内容の焼き直し"
    }
  },
  "enterprise_relevance": {
    "type": "noul",
    "instructions": "大企業の稟議・投資判断・統制の担当者が読む価値がある内容か",
    "criteria": { "true": "権限・監査・調達・全社展開・コスト判断に関わる", "false": "個人利用や小さなTipsに留まる" }
  },
  "urgency": {
    "type": "score",
    "instructions": "この内容に反応すべき早さ",
    "criteria": ["急がない。いつ読んでも同じ", "今月中に触れておくとよい", "今週中に動くべき(提供終了・仕様変更・価格変更の期限がある)"]
  }
}
質問の書き方で気をつけた点が3つあります。
選択肢ごとに、当てはまる条件を書く。 選択肢の名前だけでは判断できません。trainingなら何が題材になるのか、snsなら何が違うのか、を条件として書きます。ここが、人が頭の中でやっていた判断の定義そのものになります。
迷ったときの規則を書く。 複数に当てはまる記事は必ずあります。そのときどちらを選ぶかを、instructionsのruleに書きました。書かないと、モデルは毎回自分で決めることになり、答えが揺れます。
見送りの選択肢を明示する。 どれにも当てはまらない記事の逃げ場がないと、確率はどれかの選択肢に無理やり乗ります。公式ドキュメントも、日付の抽出を例に、記載なしに当たる選択肢を明示して無いものを推測させないよう勧めています。
3つの質問は、それぞれ別の用途に使います。verdictが本題の4択、enterprise_relevanceは大企業向けの記事を選ぶときの目印、urgencyは週次のレビューで先に見る順番を決める材料です。
ラッパーの作り方
呼び出しはHTTPのPOST1本です。当社は外部ライブラリを使わず、Pythonの標準ライブラリだけで小さなコマンドを作りました。要点だけ抜き出すと次の形です。
import json, os, urllib.request

API = "https://api.typesafe.ai/v1/systemone"
key = os.environ["TYPESAFE_API_KEY"]  # 値はコードにもファイルにも書かない

payload = {"state": state_text, "model": "jev-1.13.0", "questions": questions}
req = urllib.request.Request(
    API, data=json.dumps(payload, ensure_ascii=False).encode("utf-8"), method="POST",
    headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
)
with urllib.request.urlopen(req, timeout=20) as res:
    data = json.load(res)

verdict = data["answers"]["verdict"]          # {"choice": "training", "confidence": 0.82, "probabilities": {...}}
route = "auto" if verdict["confidence"] >= 0.6 else "human"
コマンドの仕様は次のとおりにしました。
- 入力は標準入力かファイル。状況が長すぎるときは先頭2万字で切る
- 出力はJSONを1行。答え、確信度、確率分布、自動か人かの振り分け、使ったトークン数、応答時間を含める
- 終了コードは、成功が0、鍵が無いときが2、APIの失敗が3。呼び出す側はこれで分岐する
- 記録用の追記先を指定できる。1件1行で書き足し、後から一致率を数える
- 鍵は環境変数から読む。値は秘密情報の保管庫に置き、実行時にだけ渡す。コードにも設定ファイルにも書かない
振り分けの規則は、Choiceなら確信度、Noulなら0.5からの距離で決めています。しきい値は0.6から始めました。この数字に根拠はまだありません。一致率を見ながら動かす前提の初期値です。
Cloudflare Workersで仕組みを動かしている場合は、Workers AIから同じモデルを呼べます。当社のように別の鍵を管理しなくても、既存のWorkerの中からenv.AI.runで呼び出せるので、Workers上の仕組みに組み込むならこちらが簡単です。
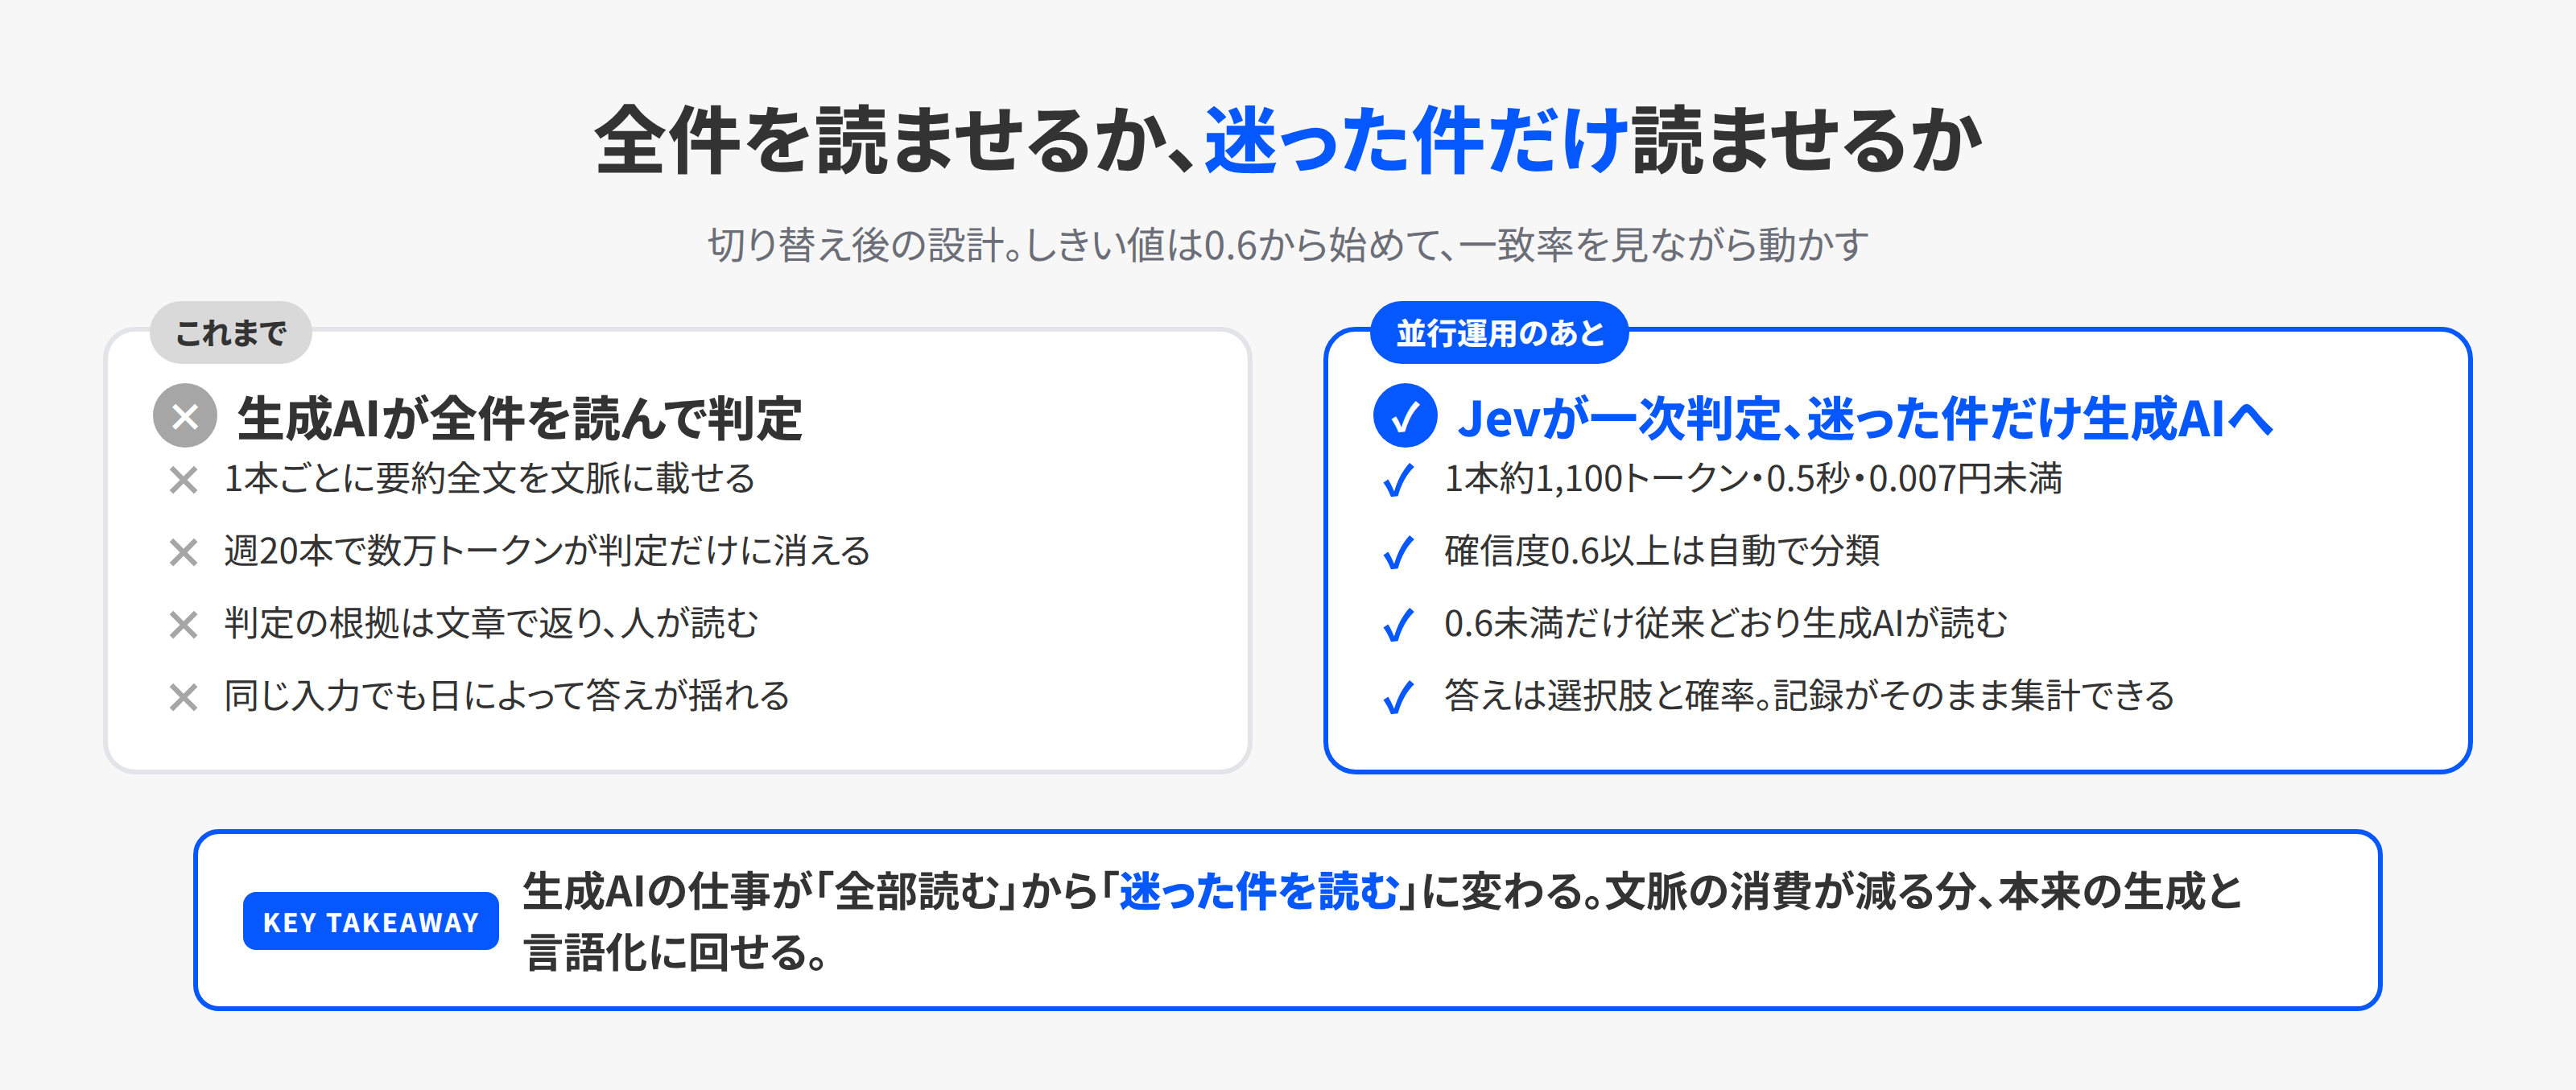
並走の配線は、週次の収集処理の後段に1行足しただけです。要約ファイルができたら、そのファイルを見出し単位に分けてJevに順番に渡し、結果を日付つきの記録に書き足します。ここで失敗しても収集処理の終了コードには影響させません。
最初の8件で分かったこと
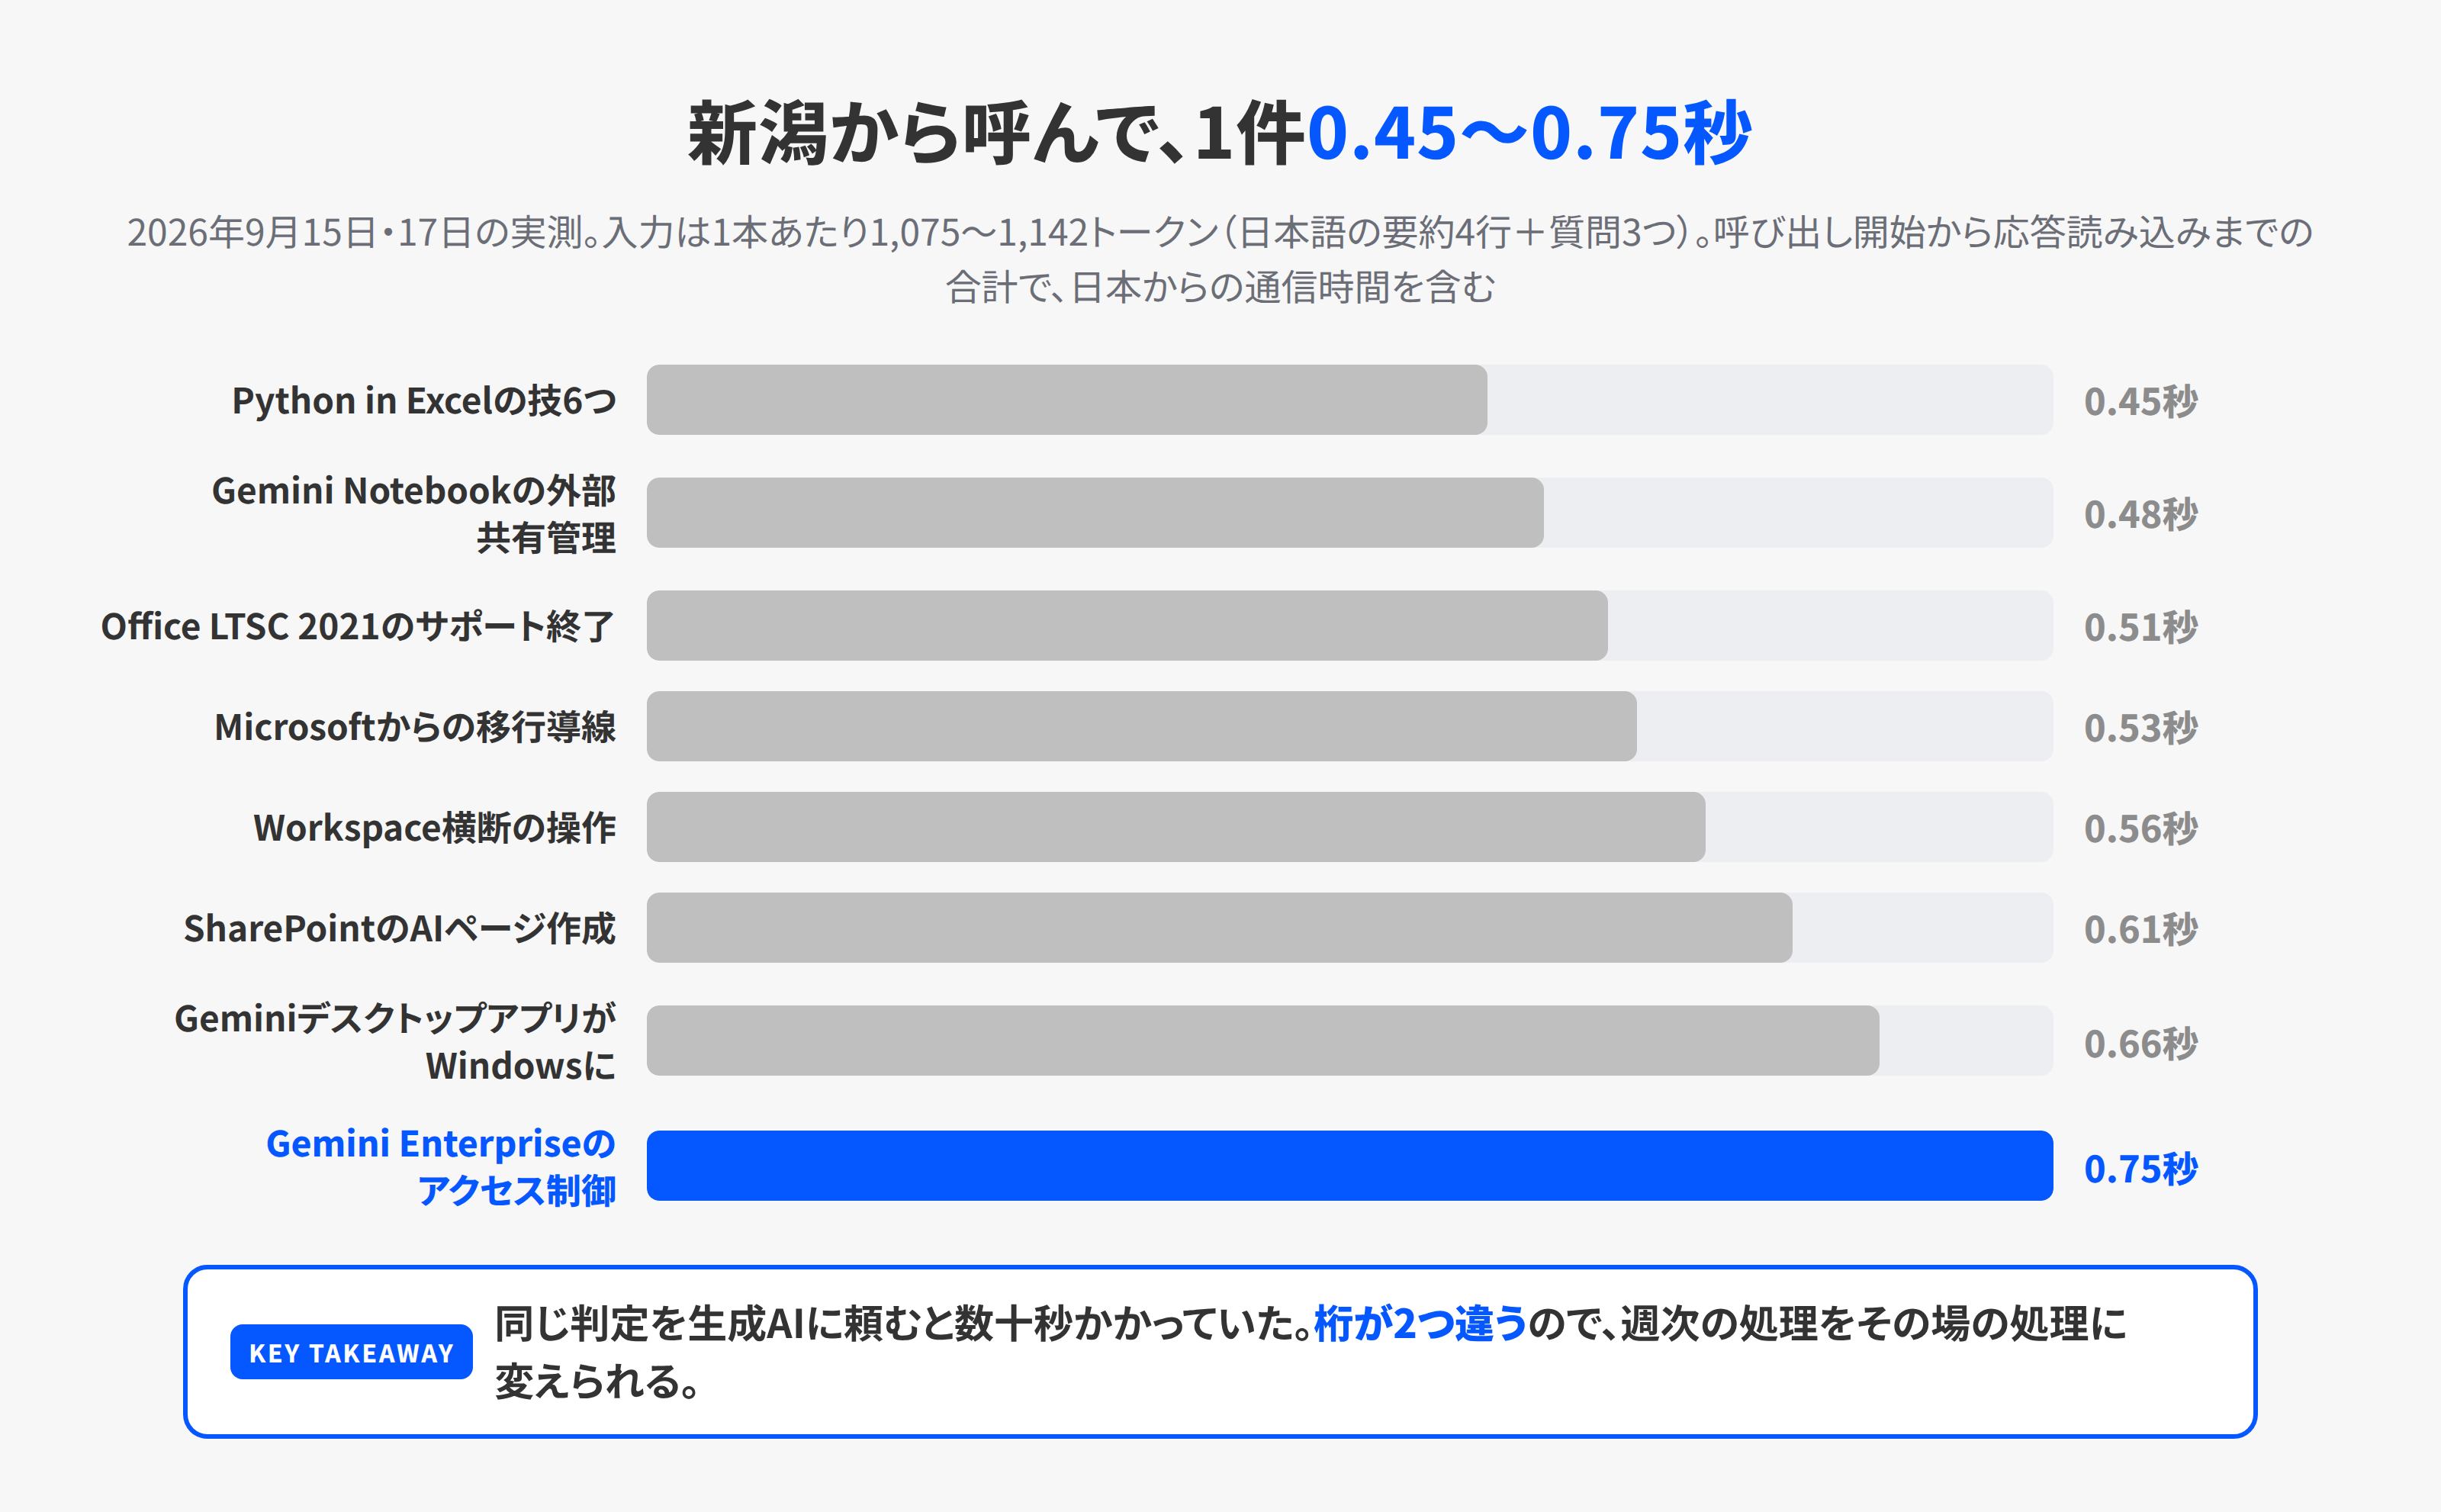
9月15日のGoogleの更新5本と、9月17日のMicrosoftの更新3本、計8本を判定しました。結果は次のとおりです。
| 記事 | Jevの判定 | 確信度 | 大企業向け | 急ぎ度 | 本人の確定判定 |
|---|---|---|---|---|---|
| GeminiデスクトップアプリがWindowsに登場 | 研修の題材 | 1.00 | 0.61 | 1.12 | 研修反映。一致 |
| どのアプリからでもWorkspace横断で操作 | 研修の題材 | 0.99 | 0.51 | 0.94 | 研修反映。一致 |
| 初期設定時にMicrosoftから移行 | 発信のネタ | 0.84 | 0.63 | 0.88 | 発信。一致 |
| Gemini Enterpriseに条件付きアクセス制御 | 研修の題材 | 0.99 | 0.83 | 0.83 | 研修反映。一致 |
| Gemini Notebookの外部共有を管理 | 研修の題材 | 0.99 | 0.77 | 0.92 | 提案ネタ(研修と同系)。一致 |
| Office LTSC 2021のサポート終了まで1か月 | 研修の題材 | 0.82 | 0.81 | 1.56 | 研修反映+発信。一致 |
| SharePointのAIページ作成 | 研修の題材 | 1.00 | 0.38 | 0.81 | 研修反映。一致 |
| Python in Excelの技6つ | 研修の題材 | 0.95 | 0.23 | 0.32 | 保留(見送り)。不一致 |
急ぎ度は0が急がない、1が今月中、2が今週中の3段階で、期待値が返ってきます。
読み取れることを順に書きます。
判定は7件一致、1件不一致。 自動の照合で対応づけられた6件はすべて一致し、見出しの表記が違って自動照合から漏れた2件を手で対応づけると、7件一致、1件不一致でした。件数が少ないので、一致率の数字を出す段階ではありません。
不一致の1件は、質問の書き方に原因があると見ています。 Python in Excelの記事を、本人は保留にしました。理由は、初級者向けの研修には重く、中級コースの候補として記録だけしておく、というものです。Jevは研修の題材と答え、確信度は0.95でした。質問のcriteriaには、研修の題材になるかとしか書いていません。中級向けの話は研修の題材です。つまりJevは書いてあるとおりに答えており、書いていなかったのは当社のほうです。今のコースの受講者に合うか、という条件を足すか、後で使うという選択肢を増やすか。どちらにしても直すのは質問で、直した質問で同じ8件を再判定して確かめます。
急ぎ度は、期限のある記事を正しく拾いました。 8件で最も高かったのはOffice LTSC 2021のサポート終了で1.56、つまり今週中に動くべき寄りです。この記事だけが2026年10月13日という期限を持っています。他は0.32〜1.12に収まりました。
大企業向けの目印も、感覚と合っています。 Gemini Enterpriseのアクセス制御が0.83、Office LTSCの終了が0.81と高く、Python in Excelの技が0.23、SharePointのページ作成が0.38と低い。権限や期限に関わる話が高く、操作のコツは低い、という分かれ方です。
費用と時間は、想定どおり小さい。 入力は1件1,075〜1,142トークン、出力は80トークン前後で無料。入力100万トークン0.042ドルなので、1,100トークンで0.0000462ドル、1ドル150円なら1件約0.007円です。応答は0.45〜0.75秒でした。この数字は呼び出しの開始から応答の読み込みまでの合計で、公表値の70〜500ミリ秒より長い分は日本からの通信時間が含まれるためと見ています(内訳は測っていません)。同じ判定を生成AIに頼むと数十秒かかっていたので、桁が2つ違います。
日本語の入力でも、確信度は高い側に集まりました。 状況も質問もすべて日本語です。公式ドキュメントは英語が主で他の言語は同等ではないと書いていますが、少なくともこの8件では確信度が0.82〜1.00の範囲でした。ただし件数が少なく、確信度が高いことと正しいことは別です。日本語での信頼度は、一致率を数十件ためてから判断します。
設計の学び
8件と少ない実績ですが、公式ドキュメントの注意点と照らして、設計の型として残しておく価値があるものを書きます。
基準は業務の言葉で、選択肢ごとに書く。 Jevは書いたとおりにしか読みません。外れた答えを見て「本当はこういう意味だった」と言いたくなったら、その説明を質問に足します。今回の不一致がまさにそれでした。
NoulとChoiceは別の質問として扱う。 同じ内容をはい/いいえで聞いた場合と、選択肢の1つとして聞いた場合で、返る数字は一致しません。公式ドキュメントに実例が載っています。当社は、どれを選ぶかはChoice、ある性質があるかはNoul、と用途を分けています。しきい値は今は共通の0.6ですが、一致率が出てきたら質問ごとに別々の値を持たせます。
状況は絞って渡す。 記事の全文ではなく4行の要約だけを渡したのは、精度と費用の両方のためです。判断に必要な部分をプログラムで先に絞ることは、Jevに限らず、AIに判断を渡すときの基本です。
計算はプログラムに残す。 Jevは数を数えたり、日付の前後を比べたりするのが苦手だと公式が明記しています。急ぎ度の判定で期限を拾えたのは、要約の中に期限が文として書いてあったからで、日付の計算をさせたわけではありません。
版を固定する。 最初の8件は別名(jev-latest)で呼びましたが、その後、既定のモデル名を版の番号(jev-1.13.0)に変えました。別名は新版が出ると自動で移り、確信度の分布が変わればしきい値の意味も変わります。新版への切り替えは、並走で一致率を確かめてから自分の予定で行います。
記録を残し、正解と突き合わせる仕組みを先に作る。 並走の価値は記録にあります。1件1行の記録と、人の確定判定を見出しで対応づける小さなスクリプトを最初に作りました。見出しの表記が揺れて2件が自動照合から漏れたので、次は記事のURLで対応づけるように直します。
失敗しても本流を止めない。 早期アクセス段階のサービスで、レート制限も予告なく変わると公式が書いています。呼び出しが失敗したら記録に残して先へ進む。この一行があるかどうかで、夜中に止まる仕組みになるかどうかが決まります。
次に置き換える判断と、置き換えない判断
並走で一致率が確かめられたら、同じ型で移せる判断が他にもあります。逆に、移さないと決めている判断もあります。
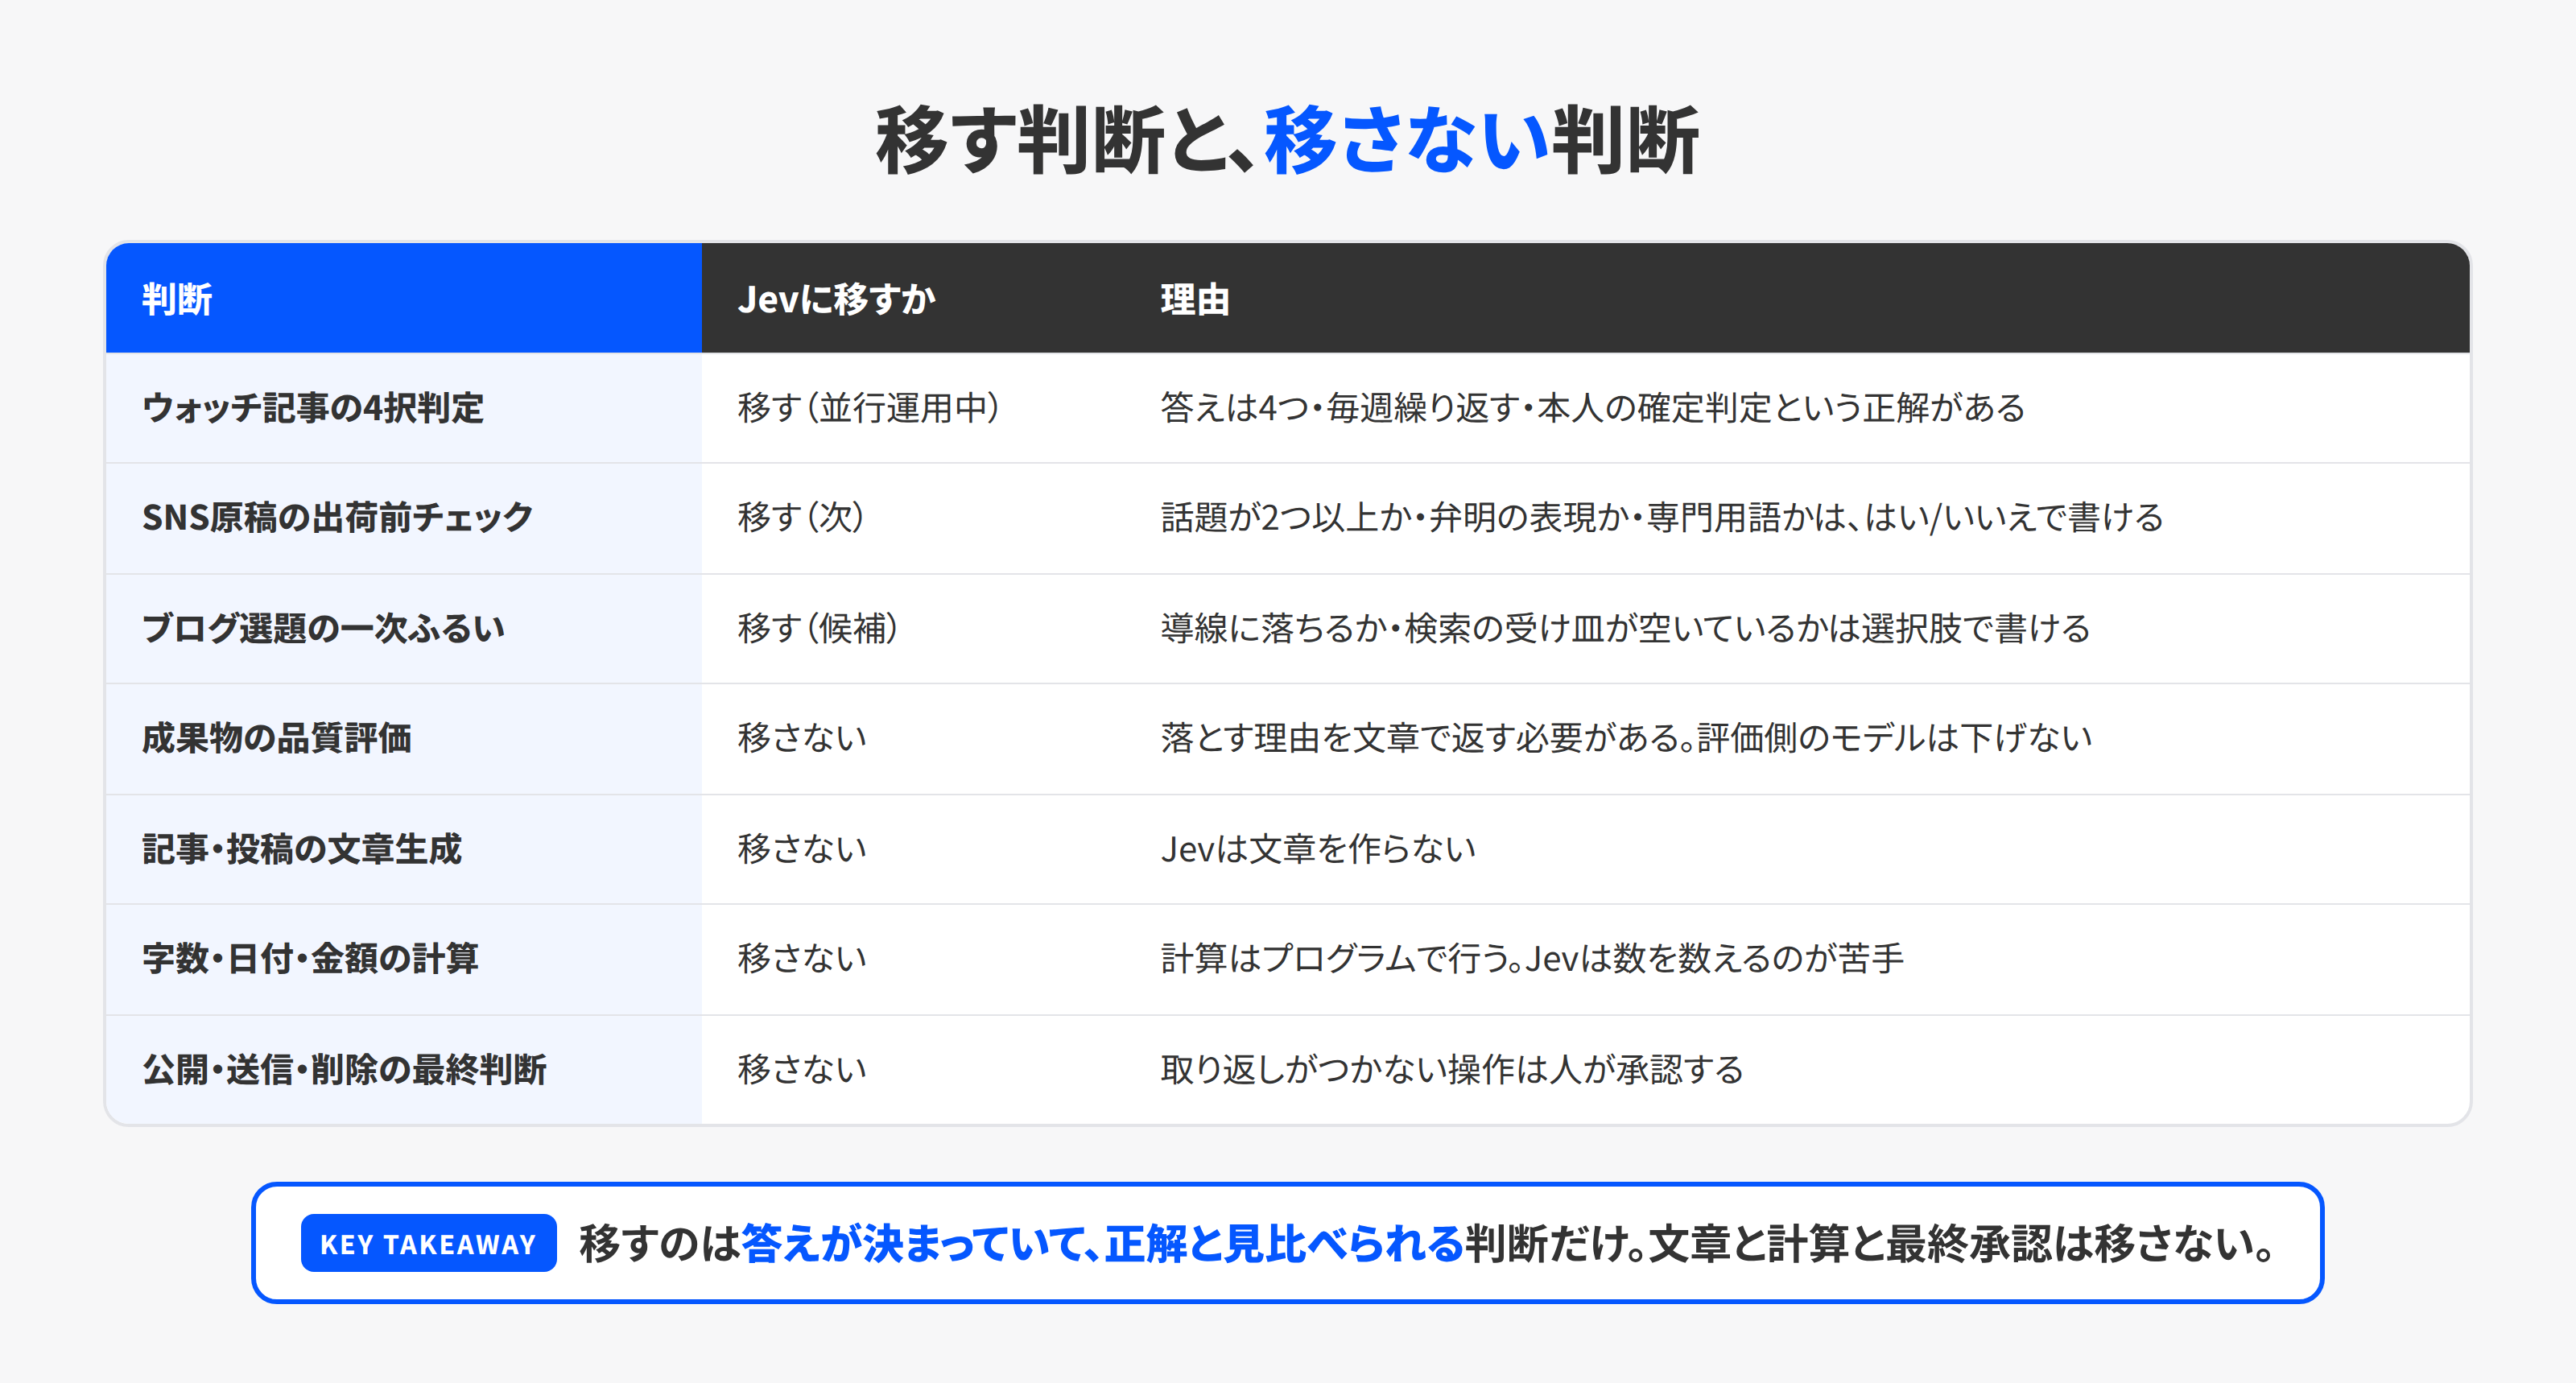
次に移すのは、SNS原稿の出荷前チェックです。当社は投稿前に、話題が2つ以上混ざっていないか、弁明や保険の表現が入っていないか、普通の人が使わない言葉がないか、を確認しています。どれもはい/いいえで書ける質問なので、Noulを4つ並べて一次チェックにし、引っかかった原稿だけを人が見る形にします。すでに質問は書いてあり、次の投稿バッチから並走させます。
移さないのは、成果物の品質評価、文章の生成、計算、そして公開や送信の最終判断です。品質評価は、落とす理由を文章で返してもらう必要があり、そこで評価側のモデルの性能を下げると仕組み全体が劣化します。文章はJevには書けません。計算はプログラムの仕事です。公開・送信・削除のような取り返しのつかない操作は、確信度がいくつでも人が承認します。
自社で始めるときの手順
当社の手順を、そのまま使える形に一般化します。
- 判断しかしていない箇所を書き出す。 問い合わせの振り分け、書類の分類、申請の一次確認。答えが数個の選択肢に収まる仕事を、業務の流れに沿って10個ほど挙げます
- 正解がある判断を1つ選ぶ。 過去の処理記録に人の判定が残っているもの、または今後の週次レビューで人が確定するものを選びます。正解がないと一致率が測れず、置き換えの判断ができません
- 質問と基準を書く。 選択肢ごとに当てはまる条件、迷ったときの規則、見送りの選択肢。この文章が業務の定義になるので、担当者に読んでもらって直します
- 並走して記録する。 既存の流れは変えず、同じ入力をJevに渡して答えだけ記録します。しきい値は仮に0.6で置き、確信度が高い件と低い件で正答率がどれだけ違うかを見ます
- 線を引いて切り替える。 一致率と確信度の分布を見て、自動で進める範囲と人が見る範囲を決めます。決めたら版を固定し、新版は再び並走してから移ります
4の段階で、一致率が上がらないことはあります。そのときに直すのはモデルではなく質問です。人の判断に含まれていて質問に書かれていない条件を探し、足します。今回の不一致がその例で、この作業は、AIを使わなくても業務の引き継ぎ資料として残ります。
KOIYALの見解
当社は自社の仕組みを、決められたとおりに処理する部分はプログラム、判断や生成や言葉にする部分は生成AI、という原則で作ってきました。Jevはこの間に、判断だけを返す第3の部品を足すものです。生成AIが読んでいた文脈のうち、判断だけで済む部分をJevに渡すと、生成AIには本来の生成と言語化に集中させられます。
ただし順番があります。まず生成AIを制限が来るまで使い倒すこと。使い倒して、判定に文脈を食われていると分かってから、判定だけを切り出す。最初から細かく最適化すると、何が判定で何が生成なのかを見極める前に設計が固まってしまいます。当社が並走を始めたのも、週次のウォッチの判定に文脈を使いすぎていると分かった後です。
もう1つ。今回の8件で分かったいちばん大きなことは、Jevの精度ではなく、当社の判断基準が言葉になっていなかった箇所が1つ見つかったことです。判断をAIに渡す作業は、判断を言葉にする作業と同じです。言葉にできた判断は、AIにも、新しい担当者にも渡せます。
次の行動
- 自社の仕組みの中で、生成AIに判断だけをさせている箇所を探す。 分類、振り分け、優先付け。答えが選択肢で書けるものが候補です
- その判断の正解が、どこに残っているかを確かめる。 残っていなければ、人の判定を記録する場所を先に作ります
- 質問を書いて、並走させる。 コードは上に書いた形で足ります。時間をかけるのは質問の文章です
当社では、こうした判断の棚卸しから、質問の設計、並走の配線、しきい値の決定までを、FDE型支援(社外の推進チームとして中に入る形)で一緒に進めています。自社の仕組みのどこから手を付けるか迷ったら、ご相談ください。