

2026年9月15日、TypeSafe AIという会社がJevというAIモデルを公開しました。発表から数日で海外の開発者コミュニティの話題の中心になり、日本でもエンジニア向けの解説記事が相次いでいます。
ただ、話題の中心は開発者です。経営者やDX担当の方が記事を読んでも、文章を書かないAIと言われて何に使うものなのか、ChatGPTやCopilotと何が違うのか、つかみにくいはずです。
この記事では、Jevが何をするモデルなのかを業務の言葉で説明します。あわせて、速くて安い理由、ハルシネーションしないという触れ込みの正しい読み方、海外の開発者がどう評価しているか、そして会社の業務のどこに当てはまるかまでまとめます(確認日: 2026年9月19日。早期アクセス段階のサービスで仕様も価格も変わり得るため、導入判断の際は公式ドキュメントで最新の状態をご確認ください)。
先に結論を3つ書きます。
- Jevは文章を作りません。あらかじめ決めた選択肢・尺度・はい/いいえの答えを、確率つきで返すだけのモデルです。返事を人が読むのではなく、プログラムがそのまま分岐に使います
- 速くて安いのは、文章を1文字ずつ生成しないからです。公表値で応答は70〜500ミリ秒、料金は入力100万トークンあたり0.042ドルで出力は無料です
- ハルシネーションしないという言葉は、決めた選択肢の外に答えが出ないという意味です。選択肢の中で間違った答えを選ぶことはあります。本当の売りは、間違えそうなときに確信度が下がる点にあります
Jevは何をするモデルか
ChatGPTやCopilotのような生成AIは、質問を受けて文章を1語ずつ組み立てて返します。答えが文章なので、プログラムがそれを使うには、文章を読み取って必要な値を取り出す処理が要ります。値が取り出せなかったり、頼んでいない形式で返ってきたりすることも起きます。
Jevは最初から、文章を返しません。渡すものは2つです。1つは判断の材料になる状況(state)で、問い合わせの本文や申請書の内容など、文章でも構造化データでも構いません。もう1つは質問(questions)で、答えの形をあらかじめ決めて渡します。
質問の形は3種類あります。
| 質問の形 | 何を返すか | 業務での例 |
|---|---|---|
| Choice(選択) | 用意した選択肢から1つ。全選択肢の確率と確信度つき | この問い合わせは請求・技術・営業のどの担当か |
| Score(尺度) | 順序のある段階のどこに当たるか。段階ごとの確率と確信度つき | この顧客の不満の度合いは、冷静・不満・激怒のどこか |
| Noul(真偽) | ある命題が真である確率(0〜1) | この文面は返金を求めているか |
たとえば、支払いが3日間失敗しているという顧客のメッセージを渡し、緊急か・どの担当か・どれくらい怒っているかを聞くと、次のような答えが返ってきます(Cloudflareの公式ドキュメントに載っている実行例です)。
- 緊急か: 0.95
- 担当: 請求(確率0.87)、技術(0.13)、営業(0)。確信度0.8
- 怒りの度合い: 3段階のうち1.04(不満)。確信度0.94
答えは全部、数字と決められた語です。プログラム側は、緊急の確率が0.9を超えたら優先キューへ、担当の確信度が0.6を下回ったら人が振り分ける、という分岐をそのまま書けます。文章を読み取る処理は要りません。
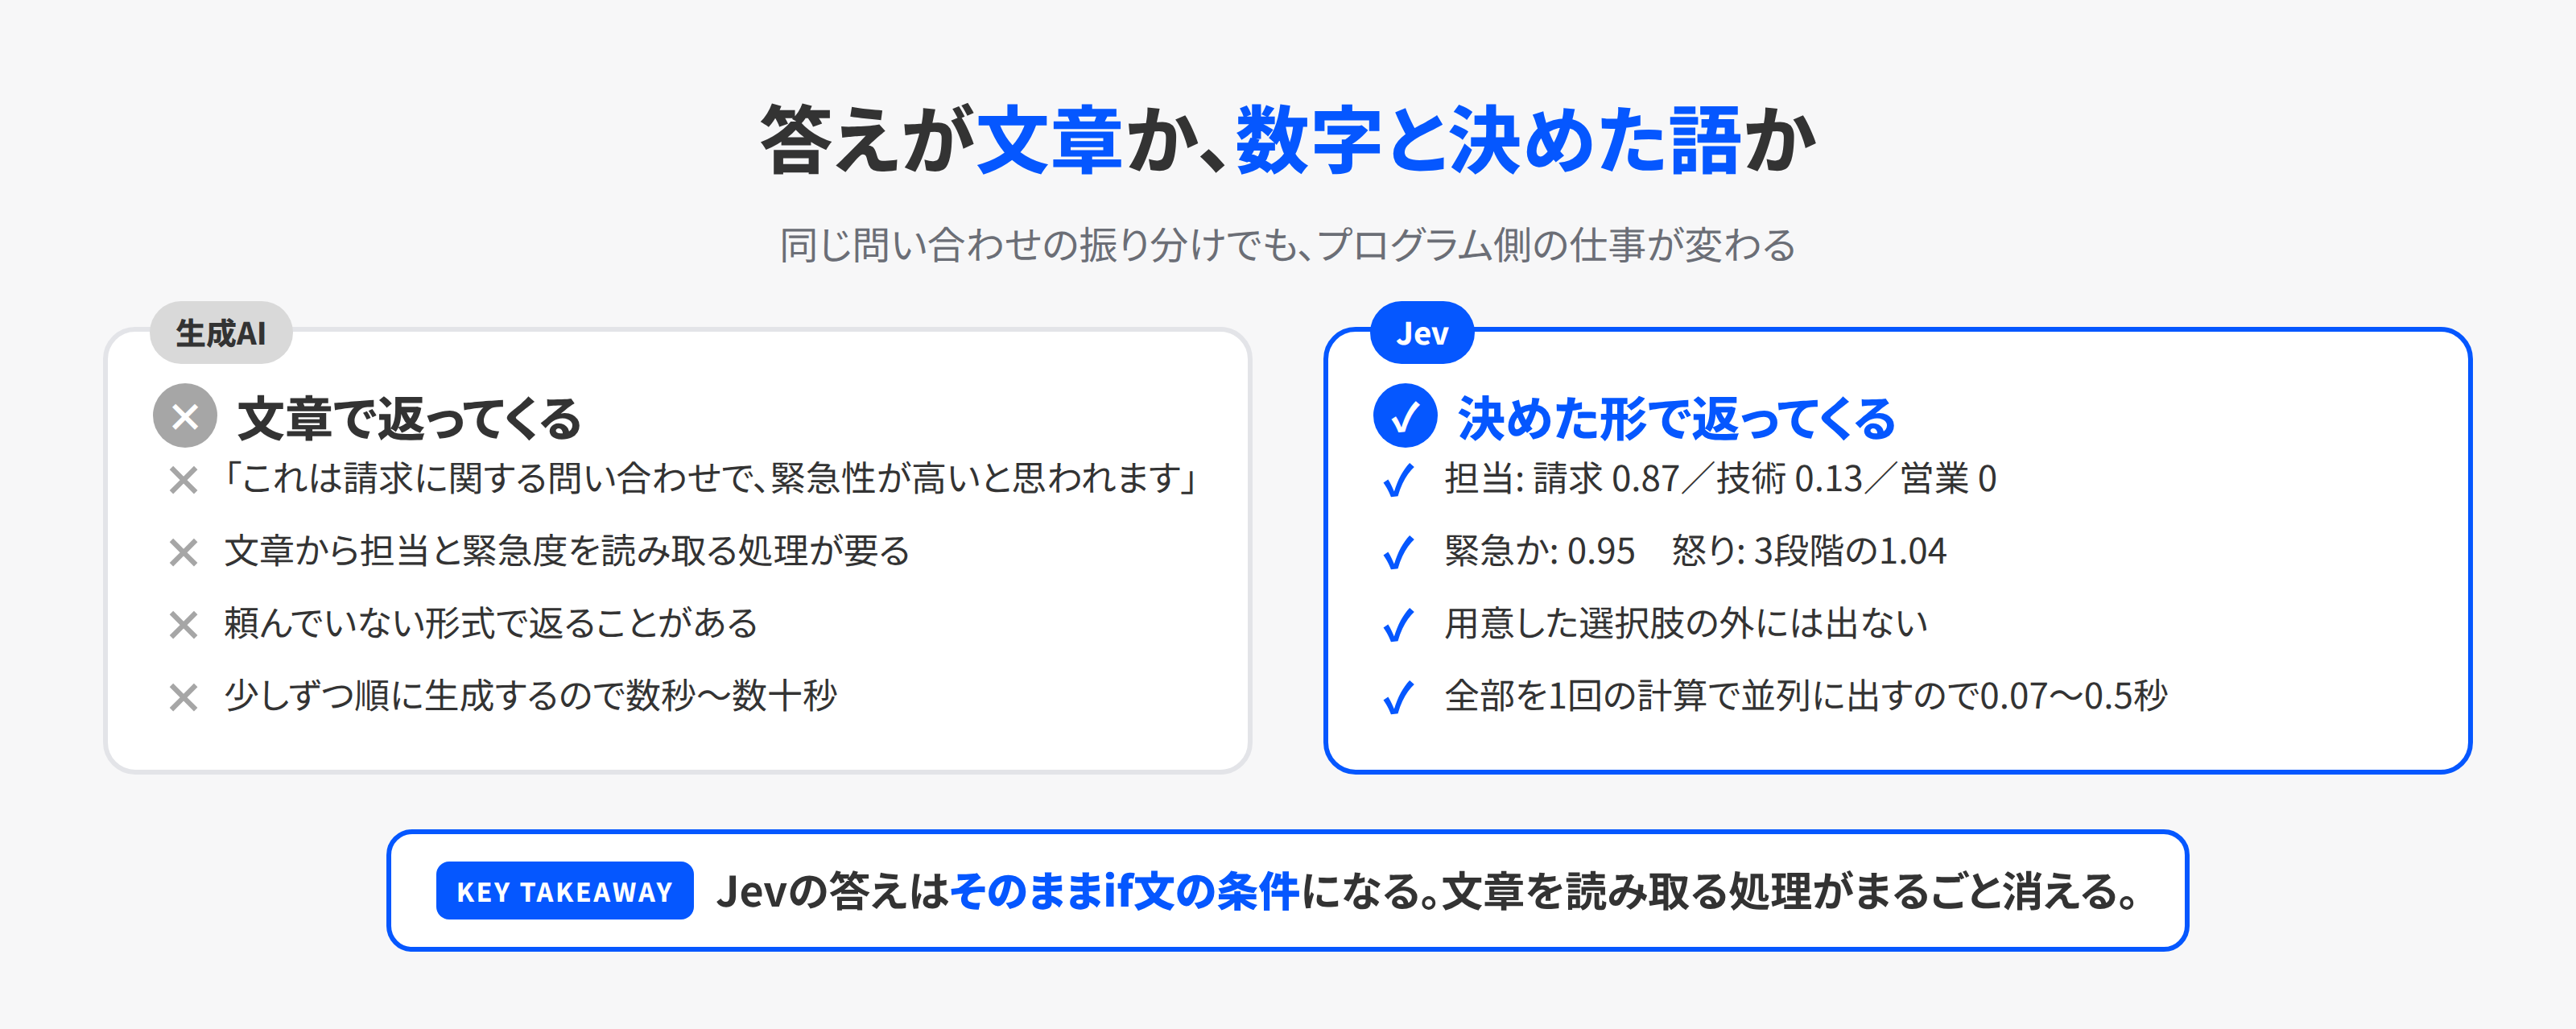
TypeSafe AIはこれをSystem One Modelと呼んでいます。名前の由来は心理学者ダニエル・カーネマンの、速くて直感的なシステム1と、遅くて熟考するシステム2の区別です。Jevは熟考しません。状況を見て、決めた形で即答することに特化しています。
開発者向けの説明では、smart if-statement(賢いif文)という言い方もされています。プログラムのif文は条件が厳密に書けるときしか使えません。文面が返金を求めているかどうかのような、言葉の意味を読まないと決まらない条件を、Jevがif文の条件式として引き受けるという意味です。
速くて安い理由
生成AIの応答が遅いのは、トークン(文字の断片)を1つずつ順番に生成するからです。100トークンの答えを返すには100回の計算が要り、それぞれが前のトークンに依存します。
Jevは答えを1語ずつ作りません。渡された質問すべてに対する確率を、1回の計算で並列に出します。TypeSafe AIはこの仕組みをparallel samplerと呼び、モデルの構造と学習方法(RLCD、Reinforcement Learning for Calibrated Decisions)もこの出力の形に合わせて新しく作ったとしています。
結果として、公表されている数字は次のとおりです。
| 項目 | 公表値 |
|---|---|
| 応答時間 | 70〜500ミリ秒(米国西海岸からの計測) |
| 料金 | 入力100万トークンあたり0.042ドル。出力は無料 |
| 1回に渡せる量 | 状況と質問をあわせて64,000トークン。状況と最長の質問で32,000トークン |
| 1つのChoiceの選択肢数 | 最大255 |
| 現在の版 | jev-1.13.0 |
料金を業務の規模で考えてみます。問い合わせ1件を1,000トークンとすると、1件の判断は0.000042ドルです。1ドル150円なら0.0063円で、10万件を判断しても630円です。出力が無料なのは、出力側の計算がごく小さく、計測して課金する意味がないからだと創業者は説明しています。
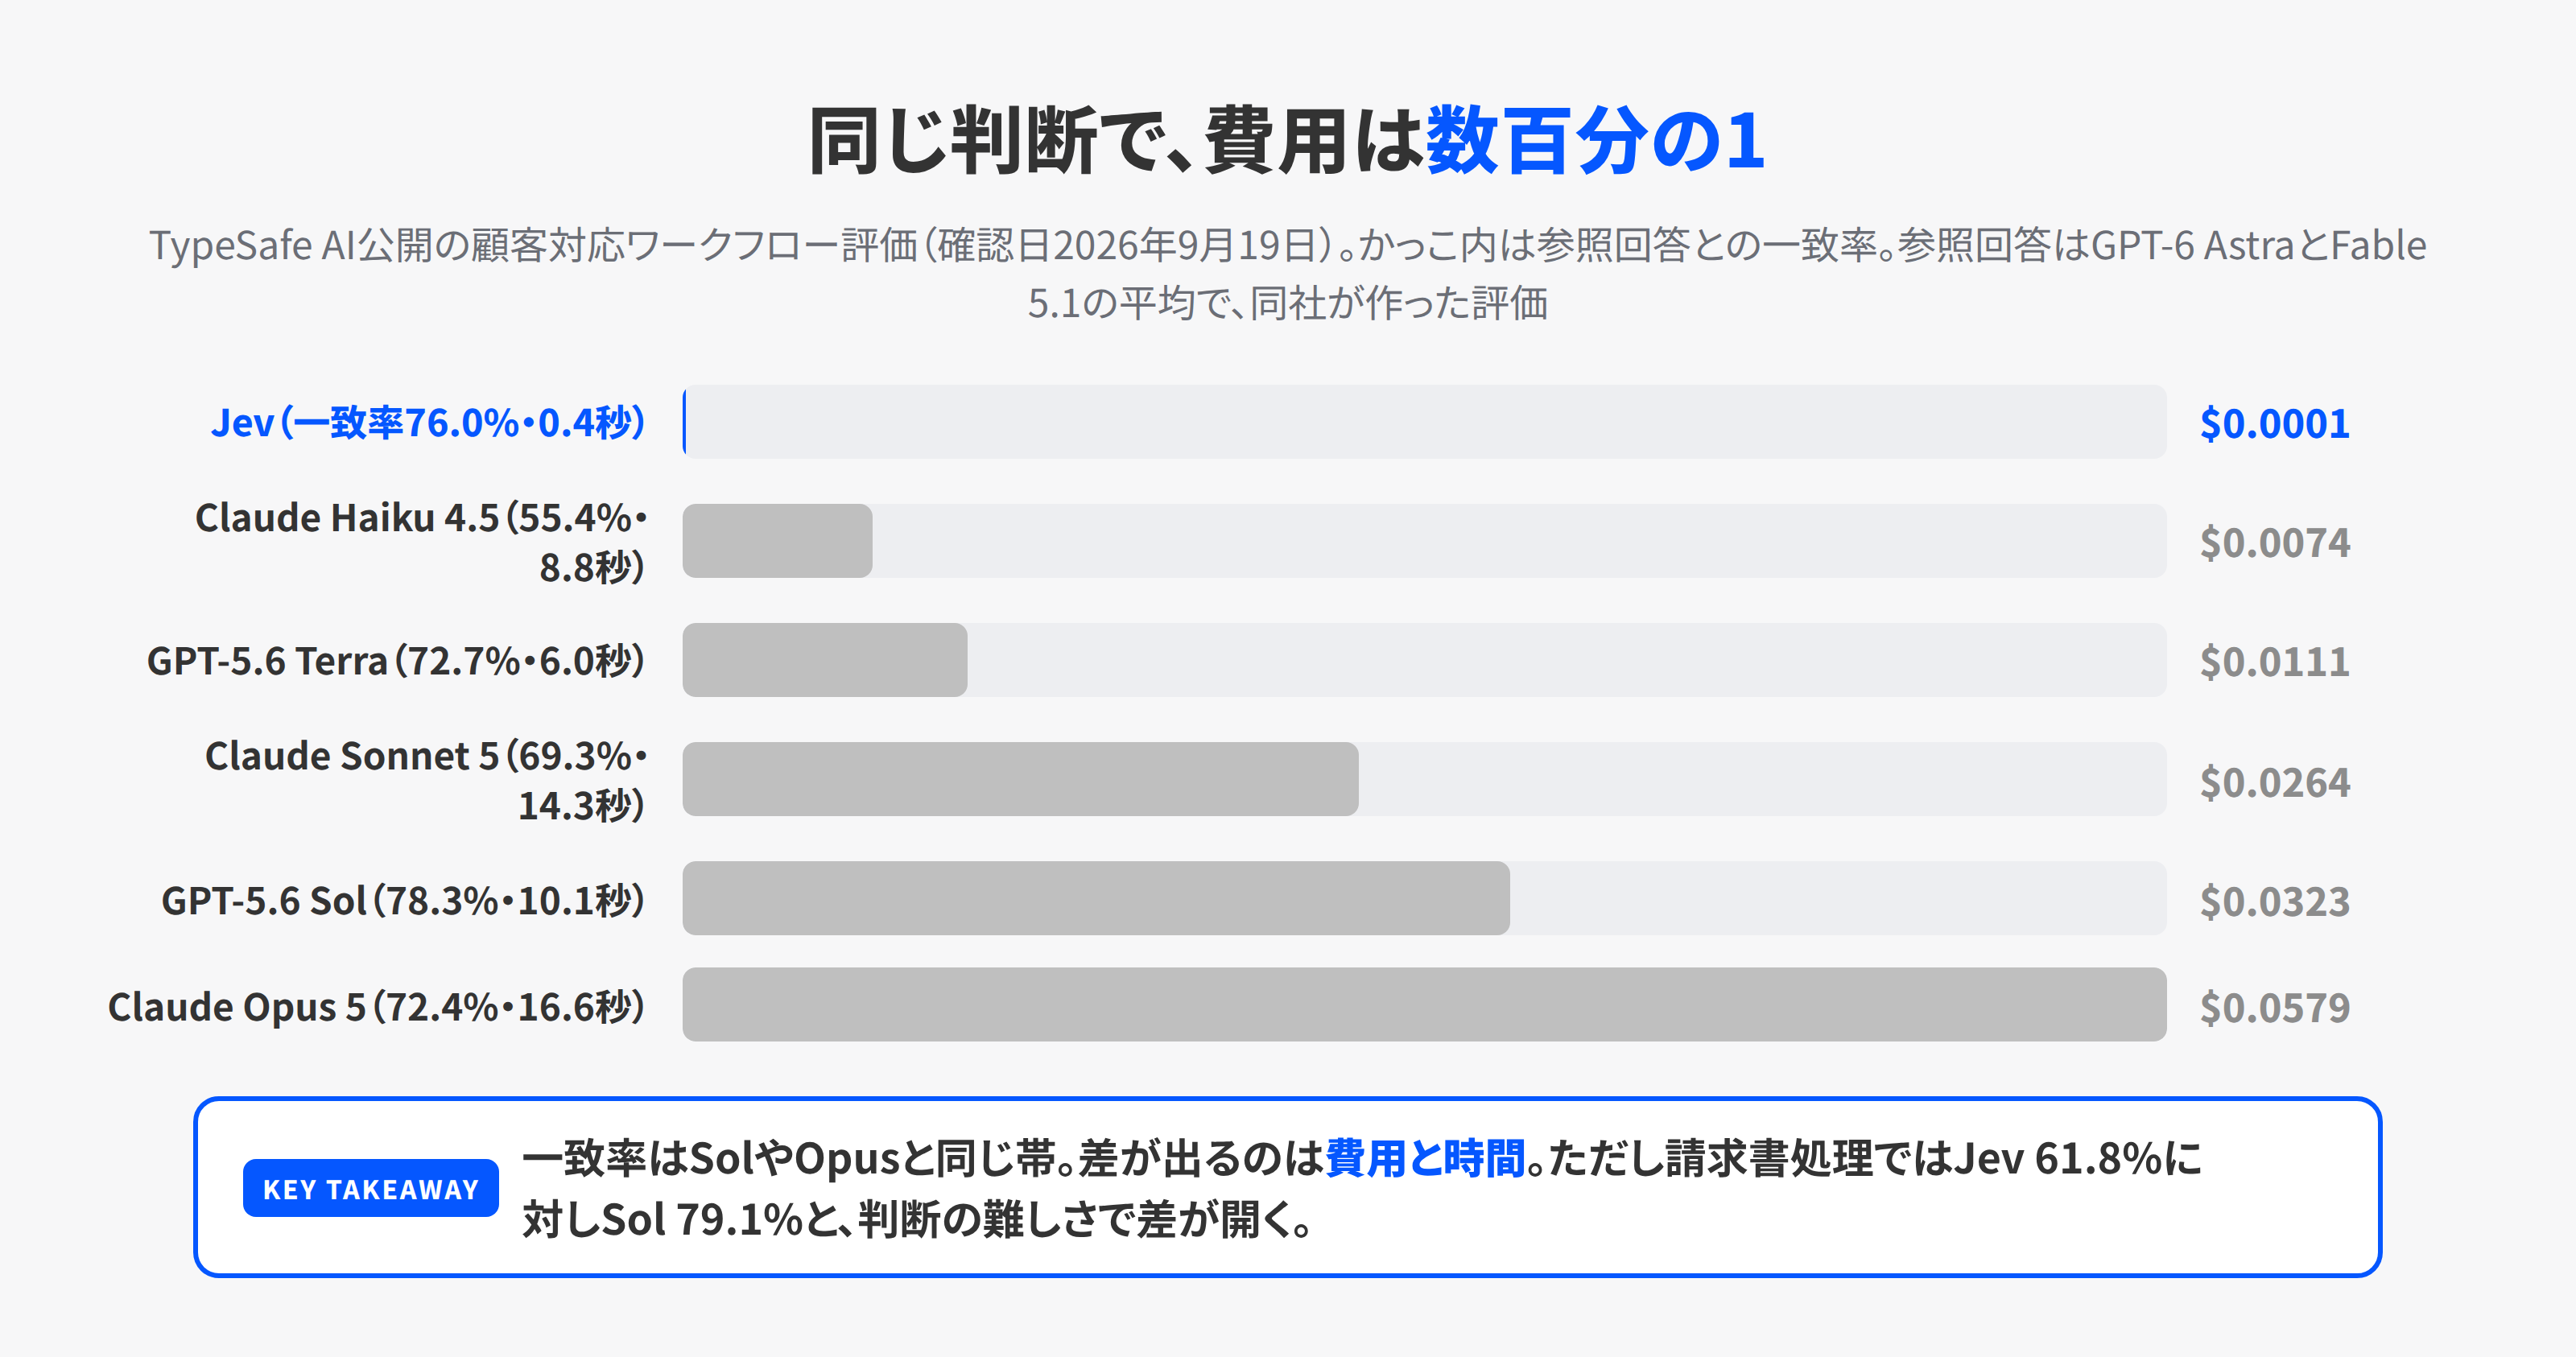
日本から使う場合は、通信の遅れが乗ります。当社の環境(新潟)から実際に呼び出したところ、約1,100トークンの日本語の状況に3つの質問を付けて、1回あたり0.45〜0.75秒でした(8件の実測。詳細は導入手順の記事に載せています)。それでも、同じ判断を生成AIに頼んで数秒から数十秒待つのとは桁が違います。
速さの意味が伝わりやすいのが、TypeSafe AIが公開したDOOMのデモです。ゲームの状況を文字データにして1秒に約10回Jevへ渡し、次の行動を決めさせています。1秒に10回呼んで、費用は1時間あたり約7ドルです。数秒かかる生成AIでは、この速さで判断を返し続ける使い方は現実的ではありませんでした。
もう1つの例が、ブラウザ操作エージェントを作っているbrowser-use社の実験です。Google Flightsでチューリッヒからロンドンへの航空券を探すという指示を1文だけ渡し、どのボタンを押すか、どの欄に入力するかの判断をJevに任せました。文字の入力内容だけ小さな生成AIが書きます。結果は7.1秒で完了、6回の比較では中央値が9.450秒から7.092秒へ25%短縮、ブラウザへの呼び出し回数は1,092回から101回に減りました。同社は、1つのタスクを3回繰り返しただけで一般的なベンチマークではないと注記しています。
「ハルシネーションしない」の正しい読み方
Jevの発表で最も議論を呼んだのが、can't hallucinate(ハルシネーションしない)という表現です。
TypeSafe AIが言っているのは、次の意味です。答えの形は事前に決まっているので、用意していない選択肢や、壊れた形式の出力は数学的に出ない。発表ブログのグラフではJevのハルシネーション率が0%と描かれていますが、同じブログの補足で、この0%は実測ではなくスキーマが保証されることから置いた数字だと明記されています。
つまり、型が正しいことと、判断が正しいことは別です。請求担当と技術担当の2択で、本当は技術の案件を請求と答えることはあります。創業者のDiogo Almeida氏もHacker Newsのスレッドで、確率的なモデルである以上、確信を持って間違えることはあり得ると認めています。
では何が新しいのか。それが確信度(confidence)の扱いです。
生成AIに自信の度合いを答えさせても、その数字はあまり当てになりません。人が好む答えを出すように学習されているので、自信ありげに間違えます。Jevは、確率が実際の正答率に合うように学習されている(calibrated)としています。0.9と言った答えの10回に9回は当たっている、という状態を目指した学習です。
この主張を独立に検証した例はまだ少ないのですが、示唆的な報告が1つあります。ドイツの産業サプライヤーの業務メール1,565通を10分類する比較で、精度そのものはGeminiのほうが上でした。ただ、Jevの答えは確信度が高いものはほぼ正解で、確信度が低いものは実際に間違っていた。投稿者は精度で負けたのに、それでも本番に入れたいと書いています。
この性質があると、設計が変わります。TypeSafe AIの公式ドキュメントは、確信度を3つの範囲に分けることを勧めています。
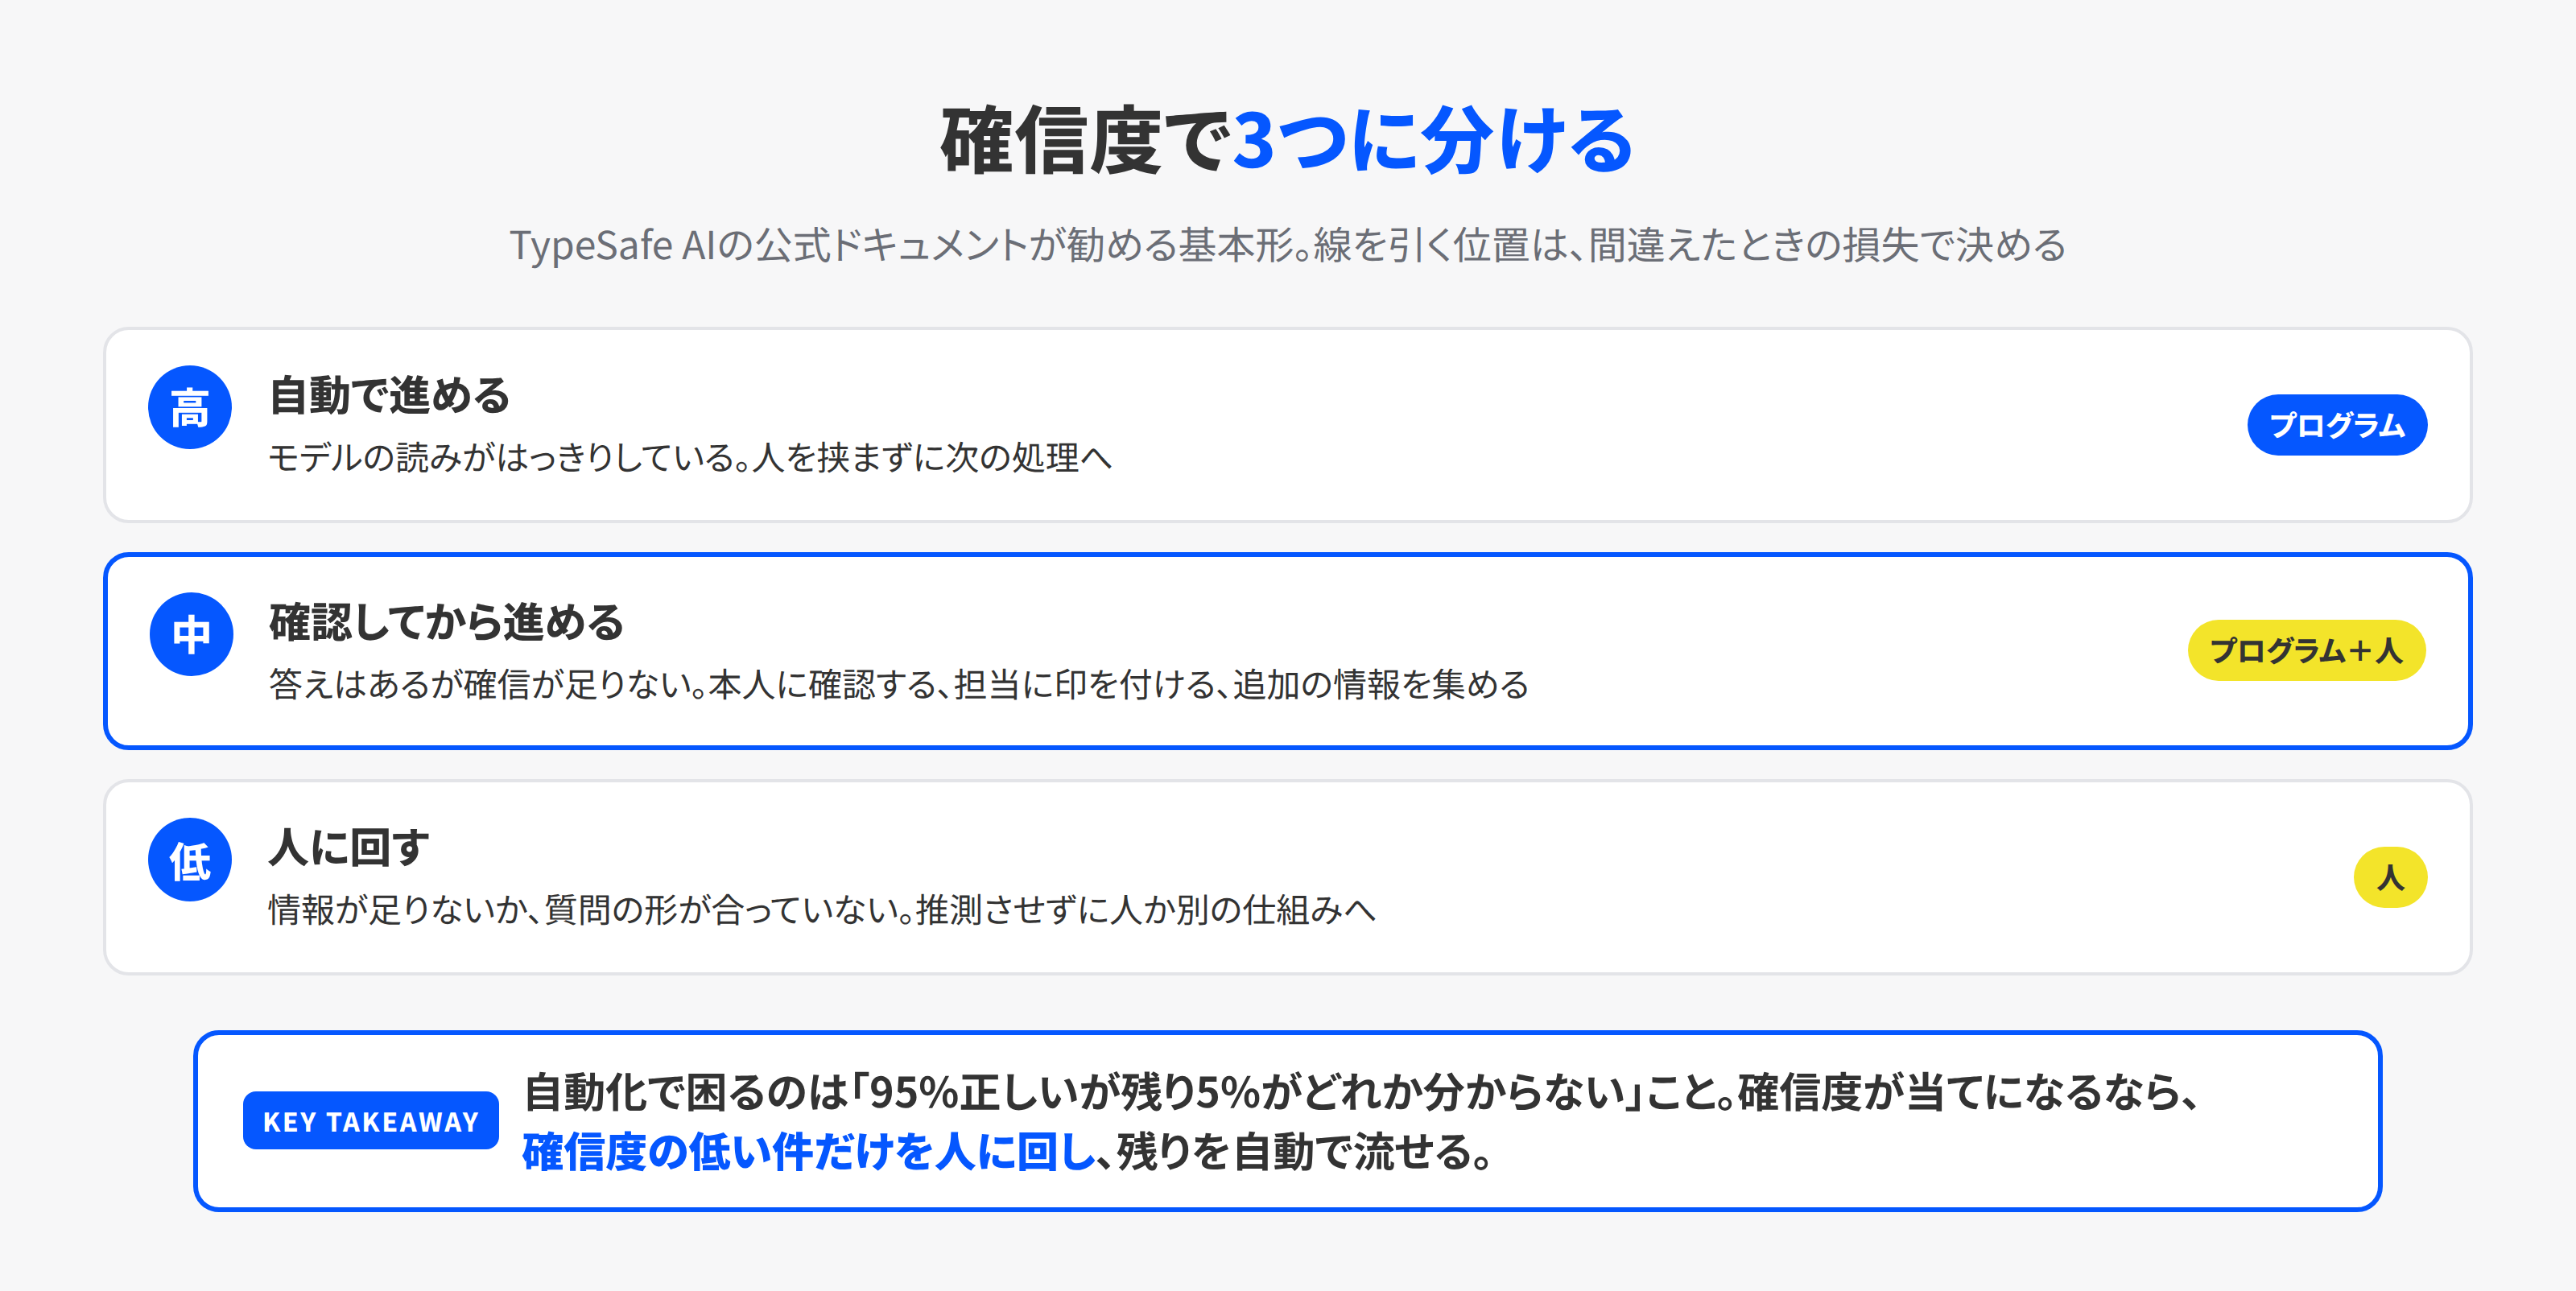
しきい値は1つではありません。同じ仕組みの中でも、残高照会のように間違えても取り返しがつく操作は低めに、送金承認のように取り返しのつかない操作は0.9以上のように高めに設定する、と公式は書いています。どこで線を引くかは、間違えたときの損失の大きさで決めます。
生成AIを業務に入れるとき、いちばん困るのは「95%は正しいが、残り5%がどれか分からない」ことです。全件を人が確認するなら自動化の意味が薄れます。確信度が信用できるなら、確信度の低い案件だけを人に回し、残りを自動で流せます。間違いをすべて拾えるわけではありませんが、人が見る件数を減らしながら全体の正答率を保つ設計ができます。Jevが売っているのは速さや安さより、この分け方ができる点だと考えたほうが本質に近いです。
海外の開発者はどう見ているか
AI業界のニュースレターLatent Spaceによると、発表は当日Hacker Newsのトップに居座り、創業者の発表投稿は翌日までに400万回以上表示されました。称賛一色ではなく、懐疑的な指摘が多いのが特徴です。主なものを挙げます。
型安全は正しさではない。 上で書いたとおり、最も多かった指摘です。発表当初の見出しに「新しいフロンティアモデル」とあった点も、会話もできないモデルにその呼称は借り物だとして批判されました。
似たことは既にできる。 生成AIにも、出力を決めた形式に制限する仕組み(制約付きデコード)は数年前からあります。答えの先頭だけを1語生成して確率を読めば、速さもかなり出せます。実際、発表から数時間後には、公開されている小さなモデルを2時間で改造して同じ形の出力を出す実験がXに投稿され、5,000件を超えるいいねを集めました。エンジニアのSean Goedecke氏は、Jevの技術的な堀は大きくなく、他の研究所も追随できるだろうと書いています。同時に、判断専用に学習したモデルのほうが間に合わせより良い結果を出す可能性も認めています。
本当に新しいのは較正。 制約付きデコードで形を縛ることはできても、確率が正答率に合うように学習することは別です。もしRLCDが独立した検証に耐えるなら、それがお金を払う理由になる、という見方が複数ありました。
自動化率という物差しが要る。 精度だけでは足りず、確信度でしきい値を引いたときに、精度90%を保ちながら何%の案件を自動処理できるか、を示すベンチマークが欲しいという要望です。会社が知りたい数字はまさにこれです。
Redditでも同じ温度でした。r/singularityでは、業界が分類モデルを再発見しているのは面白いが歓迎だ、という声と、問題ごとに学習しなくても言葉の意味を理解した分類ができるなら話が違う、という声が並びました。何のベンチマークに載るのかを示せ、という懐疑もあります。r/accelerateでは、Minecraftのボットにつないで2秒ごとに判断させた動画が投稿され、テストで50万トークン使って約2セントだったと報告されています。推論はしないが、虫のように機械的な判断がうまい、という感想が印象的でした。
実装例も急速に増えています。有志がまとめている一覧(awesome-jev)には、発表から4日で、問い合わせの振り分け、コードレビューの危険度判定、エージェントの安全確認、求人応募のスクリーニング、コミュニティの投稿監視など80件を超えるプロジェクトが集まっています。同じ一覧によると、Cloudflare Workers AIのほか、OpenRouterやVercel AI Gatewayといった開発者が既に使っている基盤からも呼べるようになっています。
日本ではLayerX社が、社内で50人超のエンジニアを集めて30分の勉強会を開き、50件を超える組み込みのアイデアが出たと報告しています。既存の生成AI呼び出しをJevに置き換えるだけだと少し安くなったで終わる、これまでAIを使うと考えもしなかった場所に差し込む頭に切り替えないと本領が出ない、という指摘は、この記事の次の節にそのままつながります。
会社の業務のどこに当てはまるか
Jevが向いているのは、答えの候補があらかじめ分かっていて、同じ判断を何度も繰り返す仕事です。TypeSafe AIの用途マップから、中小企業の業務に近いものを選んで言い換えます。
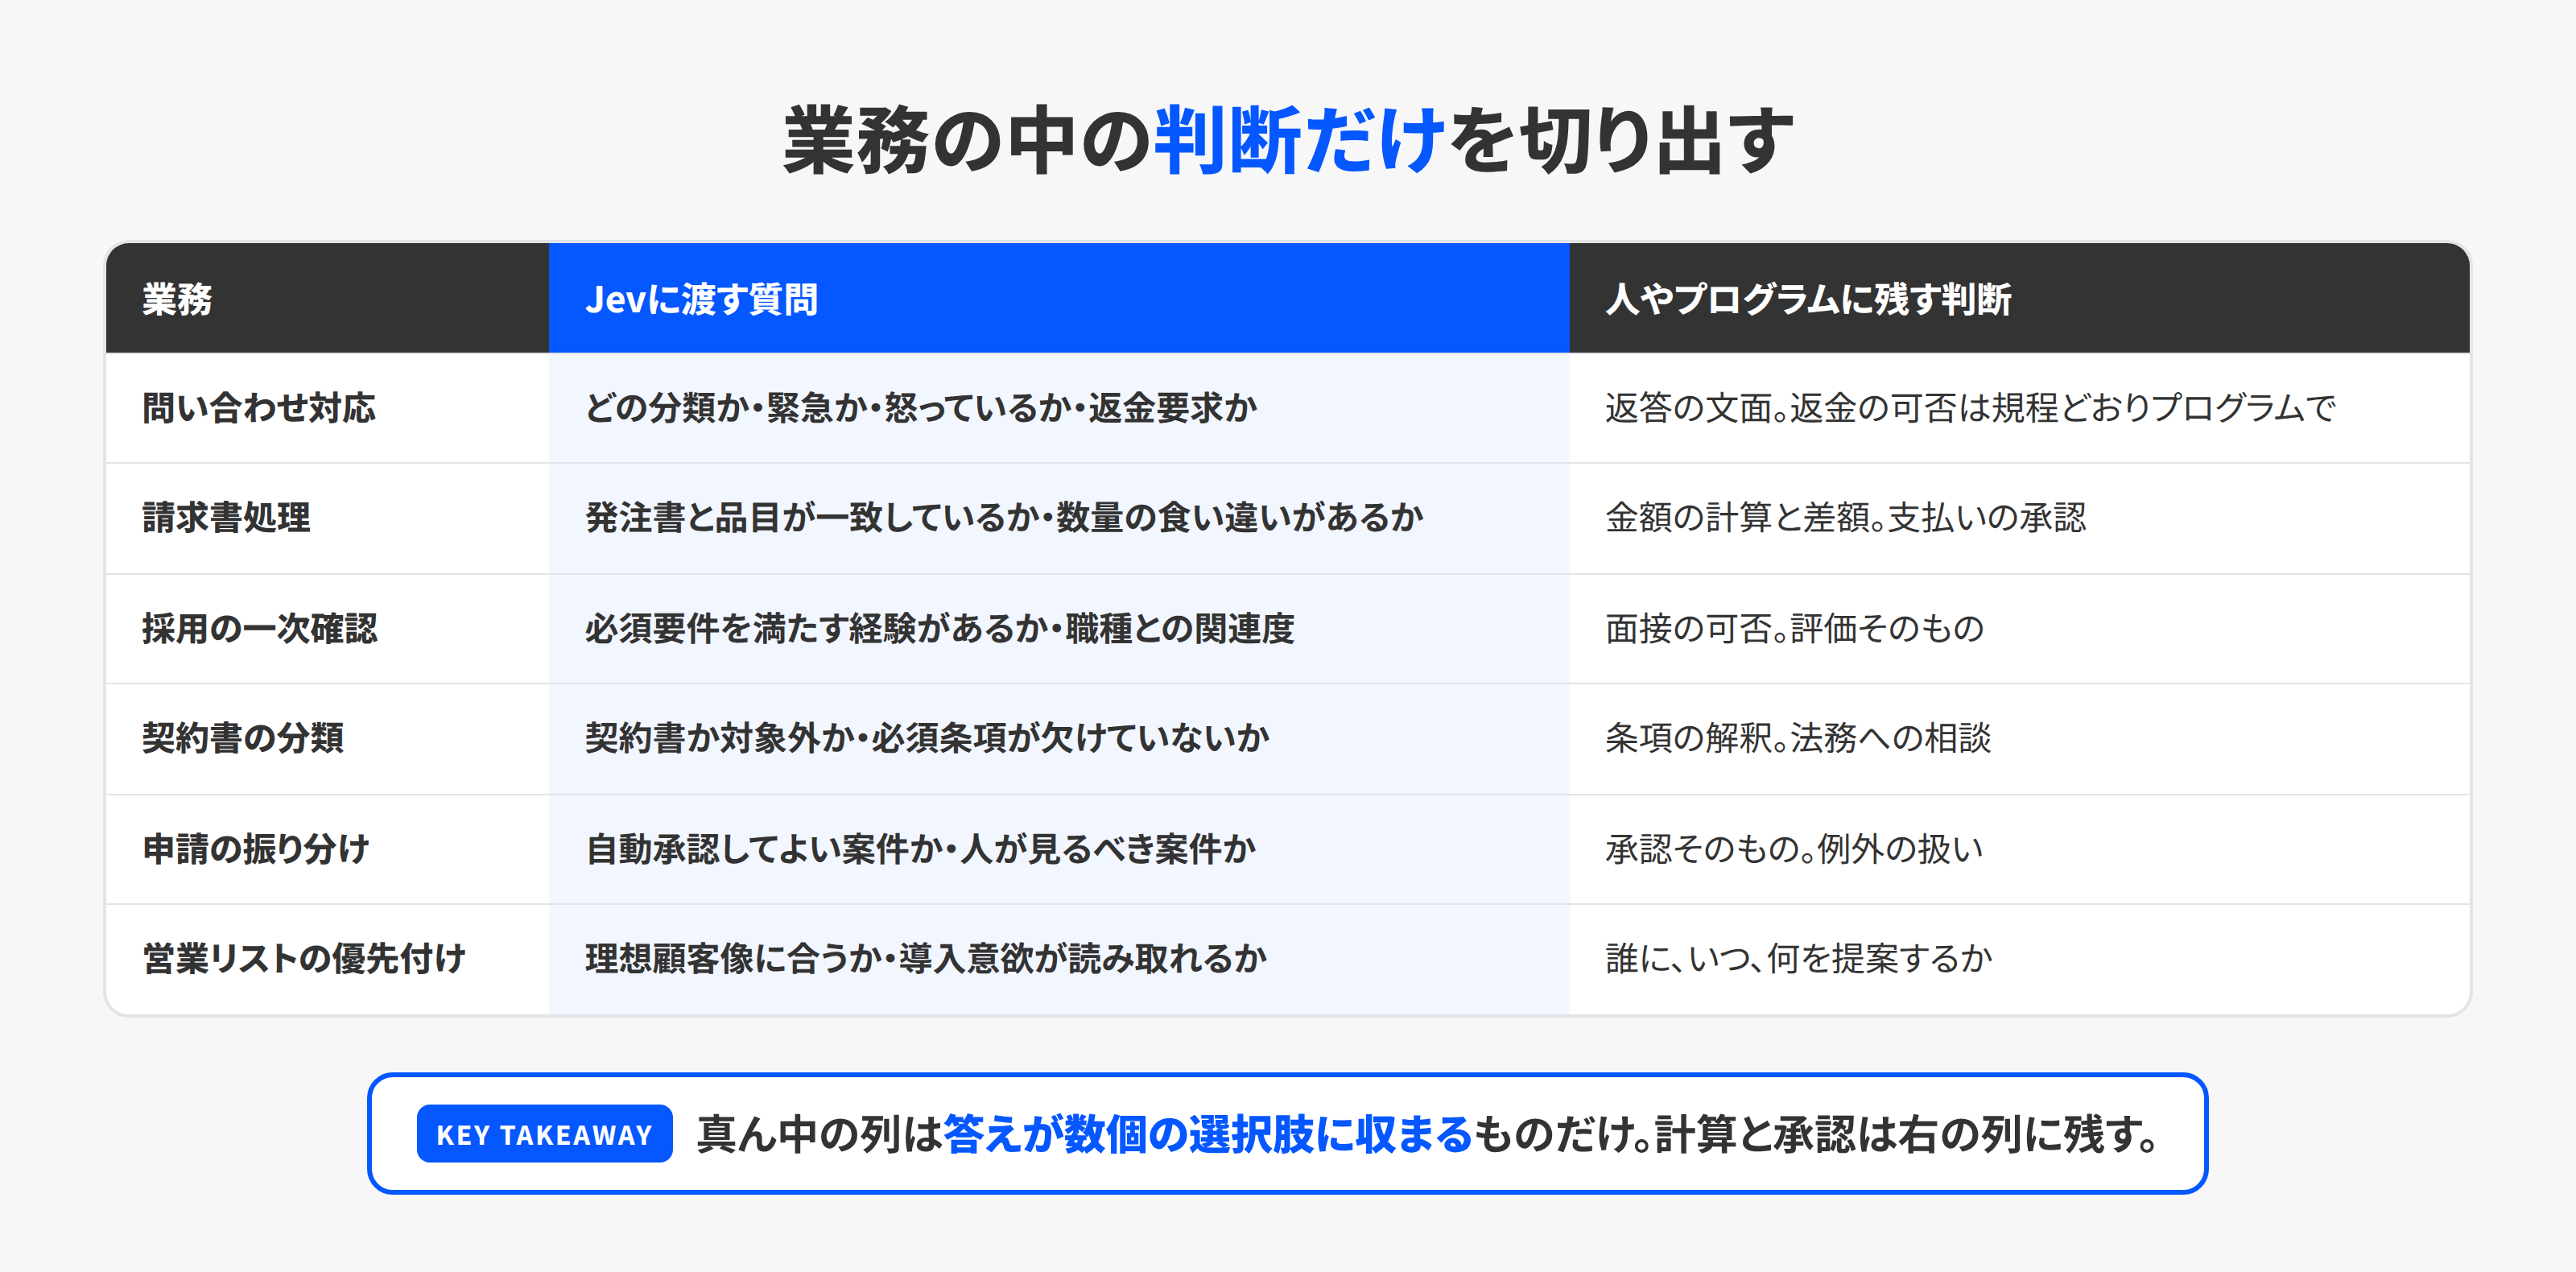
| 業務 | Jevに渡す質問 | 人やプログラムに残す判断 |
|---|---|---|
| 問い合わせ対応 | 内容はどの分類か。緊急か。怒っているか。返金要求か | 返答の文面。返金の可否は規程どおりプログラムで |
| 請求書処理 | 発注書と品目が一致しているか。数量の食い違いがあるか | 金額の計算と差額。支払いの承認 |
| 採用の一次確認 | 必須要件を満たす経験があるか。募集職種との関連度 | 面接の可否。評価そのもの |
| 契約書の分類 | 契約書か対象外の書類か。必須条項が欠けていないか | 条項の解釈。法務への相談 |
| 申請の振り分け | 自動承認してよい案件か、人が見るべき案件か | 承認そのもの。例外の扱い |
| 営業リストの優先付け | 自社の理想顧客像に合うか。導入意欲が読み取れるか | 誰に、いつ、何を提案するか |
LayerXの勉強会で出た問いが、この棚卸しの型としてよくできています。
- この書類は契約書ですか、それとも対象外の書類ですか
- この申請は自動承認してよいですか、人が見るべきですか
- この問い合わせは過去のエスカレーション事例と似ていますか
- この取引先名は、検索でヒットしたこのマスタと同一ですか
どれも、答えははい/いいえか数個の選択肢です。業務システムの中を眺めると、判断しかしていない箇所がやたらと多いことに気づく、と同社のエンジニアは書いています。これまではこうした箇所に生成AIを持ち込むと遅くて高かった。だから人がやっていた。ここが変わります。
もう1つの変化は、呼ぶ回数の感覚です。1件0.006円なら、全レコードを毎晩走査しても、入力のたびに判定しても、費用は問題になりません。これまで諦めていた、人の操作に合わせてAIが頻繁に反応する画面が現実の選択肢になります。
向かない仕事と、導入前に知っておくこと
TypeSafe AI自身が、現在の版(jev-1.13)の苦手な点を公開しています。導入判断に直結するものを挙げます。
書いたとおりにしか読まない。 質問の意図を汲みません。否定や範囲の指定は字義どおりに受け取られます。答えが外れたときに「本当はこういう意味だった」と説明したくなったら、その説明が質問に足りなかった部分です。
計算と日付は苦手。 数を数える、金額を比べる、日付の前後を判断する、といった処理は信頼できません。公式は、抽出だけをJevに任せ、計算はプログラムで行うよう勧めています。
関係ない情報を渡すと精度が落ちる。 状況に判断と無関係な内容が多いほど、答えが外れやすくなります。先にプログラムで絞り込み、質問に必要な部分だけを渡す設計が前提です。
敵対的な文面に弱い。 渡した状況は素直に読まれるので、自分をこう分類しろと書いてある文面には引きずられます。外部からの入力を扱うなら、境界の事例で試してから広げる必要があります。
日本語は英語と同等ではない。 主な学習言語は英語で、日本語を含む他言語も扱えるが同じ精度ではない、と公式ドキュメントにあります。日本語の業務で使うなら、自社の実データで試し、確信度の分布を見てから任せる範囲を決めることになります。当社の試行では、日本語の記事を渡した判定でも確信度は0.8〜1.0の範囲に集まりましたが、件数はまだ少なく、結論を出す段階ではありません。
版が変わると確信度の分布も変わり得る。 モデル名の別名(jev-latest)は新版が出ると自動で移ります。しきい値を決めたら版の番号を固定して呼び、新版への切り替えは自分の予定で行うよう公式が勧めています。
運用面では、現時点で早期アクセスの申込制であること、レート制限が需要に応じて予告なく変わること、米国でホストされたAPIで自社の環境には置けないことも押さえておく点です。顧客のデータで学習はしない、企業向けにはデータを保持しない契約がある、と公式は説明していますが、渡す情報の範囲は自社の規程に照らして決める必要があります。
KOIYALの見解
当社は自社の運用の中で、Jevをすでに1つの判断に使い始めています。海外のMicrosoftとGoogleの公式更新情報を毎週集め、1本ずつ「自社の仕組みに反映するか、研修の題材にするか、発信のネタにするか、見送るか」を4択で判定する工程です。これまで高性能な生成AIに記事を読ませて判定させていましたが、Jevに同じ4択を並走させています。導入の手順と最初の結果は、別の記事にまとめました。
この経験から言えるのは、Jevは買ってくる製品というより、業務の見方を変える道具だということです。生成AIを入れると考えると、何を書かせるか、何を要約させるかという発想になります。Jevを入れると考えると、この業務のどこが判断で、どこが計算で、どこが人にしかできないか、を分けることになります。この分け方は、Jevを使うかどうかに関係なく、AIを業務に組み込むときの基本です。
もう1つ。海外の議論で繰り返し出てくる、生成AIより速くて安い、という比較は、会社の判断としてはあまり重要ではありません。重要なのは、間違えそうな案件を自分で申告してくれるかどうかです。それができるなら、自動化する範囲と人が見る範囲を数字で決められます。できないなら、どんなに安くても全件を人が見ることになります。導入を検討するときは、精度の数字より先に、確信度が高い案件と低い案件で正答率がどれだけ違うかを、自社の実データで確かめることをお勧めします。
次の行動
Jevを試すかどうかに関わらず、次の3つはすぐにできます。
- 判断しかしていない箇所を10個書き出す。 問い合わせの振り分け、書類の分類、申請の一次確認。答えが数個の選択肢に収まるものを選びます
- 1つ選んで、判断の基準を言葉にする。 何を見て、どう分けているか。ベテランの頭の中にある基準を、選択肢ごとの説明として書きます。この作業自体が、AIを使わなくても業務の引き継ぎに効きます
- 間違えたときの損失で、自動化の線を引く。 間違えても取り返しがつく判断は自動で、つかない判断は人が確認する。この線を先に決めてから、道具を選びます
当社では、この棚卸しから設計、実装、運用の仕組みづくりまでを、AI・DXコンサルティングとFDE型支援(社外の推進チームとして中に入る形)で支援しています。自社の業務でどこから手を付けるべきか迷ったら、まずご相談ください。
参考
- Introducing System One Models & Jev(TypeSafe AI 公式ブログ)
- Models(公式ドキュメント。版・料金・制限)
- Confidence(公式ドキュメント。確信度の扱い)
- Jev 1.13 jaggedness(公式ドキュメント。苦手な点)
- Example use cases(公式ドキュメント。用途マップ)
- Jev on Cloudflare Workers AI
- Workflow evals(公式の評価サイト)
- browser-use/jev-ultrafast(GitHub)
- Skill suggestion(公式クックブック)
- 緊急で社内Jev勉強会を開催したらアイデアがバンバン出て頭が柔らかくなった(LayerX エンジニアブログ)
- Hacker News のスレッド
- Reddit r/singularity のスレッド
- Reddit r/accelerate のスレッド
- Jev means structured output is interesting again(Sean Goedecke)