
AIに頼んで、社内の小さなアプリを作る。日報の集計、在庫の確認、問い合わせの受付。作る費用は下がり、作れる人も増えました。次に出てくる問いはこれです。できたアプリを社員や取引先に使わせる前に、誰が、何を点検するのか。
2026年10月7日にITmedia NEWSが、Microsoftやシンガポール国立大学などに所属する研究者による調査を紹介しました。バイブコーディングで作られ、公開中のWebアプリ200件を監査したところ、91%に少なくとも1つの脆弱性があった、という内容です。この記事は、その数字が何を数えたものかを分けたうえで、原因の分け方と対策の実験結果を読み、自社で作ったアプリを公開する前に自社でできる点検を書きます。読者は、AIで社内の道具を作り始めた担当者と、それを許した経営者です。論文の確認日は2026年10月13日です。
結論を先に書きます。
- 91%は、オープンソースとして公開され、かつ実際に動いている200件の数字です。 1,186件の脆弱性のうち65.77%が深刻度の高い2段階に入りました。社内で閉じて使うアプリの数字ではありませんが、同じ種類の問題が入る可能性はあるので、原因の分け方を自社の点検の参考にします
- 原因の63.4%は知識の欠陥に分類され、そのうち全体の55.5%は、頼んだ人が言葉にしなかった安全の決まりをAIが見落としたものです。 入力を確かめる、保存する前に暗号化する、ログインした人の権限を確かめる。人間の開発者なら言われなくてもやることを、AIは言われなければやらないことがあります
- 公開する前の点検は、自社でできます。 本番運用に耐えるものを求める一言、自己確認の依頼、アクセス制御と入力の扱いと認証を人が重点的に見ること、秘密情報とデータの保存先、公開範囲の決定。この5つを社内の点検表にして残します
何を数えた数字か
調査は、arXivに2026年6月に投稿され、9月に第4版に改訂された論文「Understanding the (In)Security of Vibe-Coded Applications」です。研究チームは、Claude CodeとLovableが残した履歴をGitHubで探し、初回のコミットがAIによるもので、AIが書いたコミットと行がともに90%以上のものを、バイブコーディングで作られたアプリと定義しました。この条件で9,041件が集まり、うち8,695件がWebアプリ、公開稼働しているものが984件でした。そこから無作為に200件を選び、監査しています。
監査には2つのAIエージェントとセキュリティ用のスキルを組み合わせて使い、見つかった候補は実際に攻撃が成立するかを試したうえで、著者2人が独立に判定し、両者が成立すると判定したものだけを脆弱性として数えています。その結果が1,186件で、200件のうち182件、91.0%に少なくとも1件が見つかりました。深刻度は、致命的が18.47%、高が47.30%で、合わせて65.77%です。種類の分類はOWASP Top 10(2025)で、アクセス制御の不備が28.58%、インジェクションが16.78%、認証の不備が14.84%で、3つで全体の60.20%を占めています。
ここで数字の範囲を押さえておきます。この200件は、コードが公開され、かつインターネットから誰でも触れる状態のアプリです。社内だけで使う非公開のアプリは含まれていません。また、AIが90%以上書いたという定義は、人がまったく見ていないことを意味しません。この記事で91%を自社に当てはめるときは、自社のアプリにも同じ種類の問題が入りうる、という読み方にとどめます。
原因は3つに分かれる
論文は1,186件の原因を8つの型に分け、それをAIエージェントの3つの限界にまとめています。記憶の欠陥、目的の欠陥、知識の欠陥です。
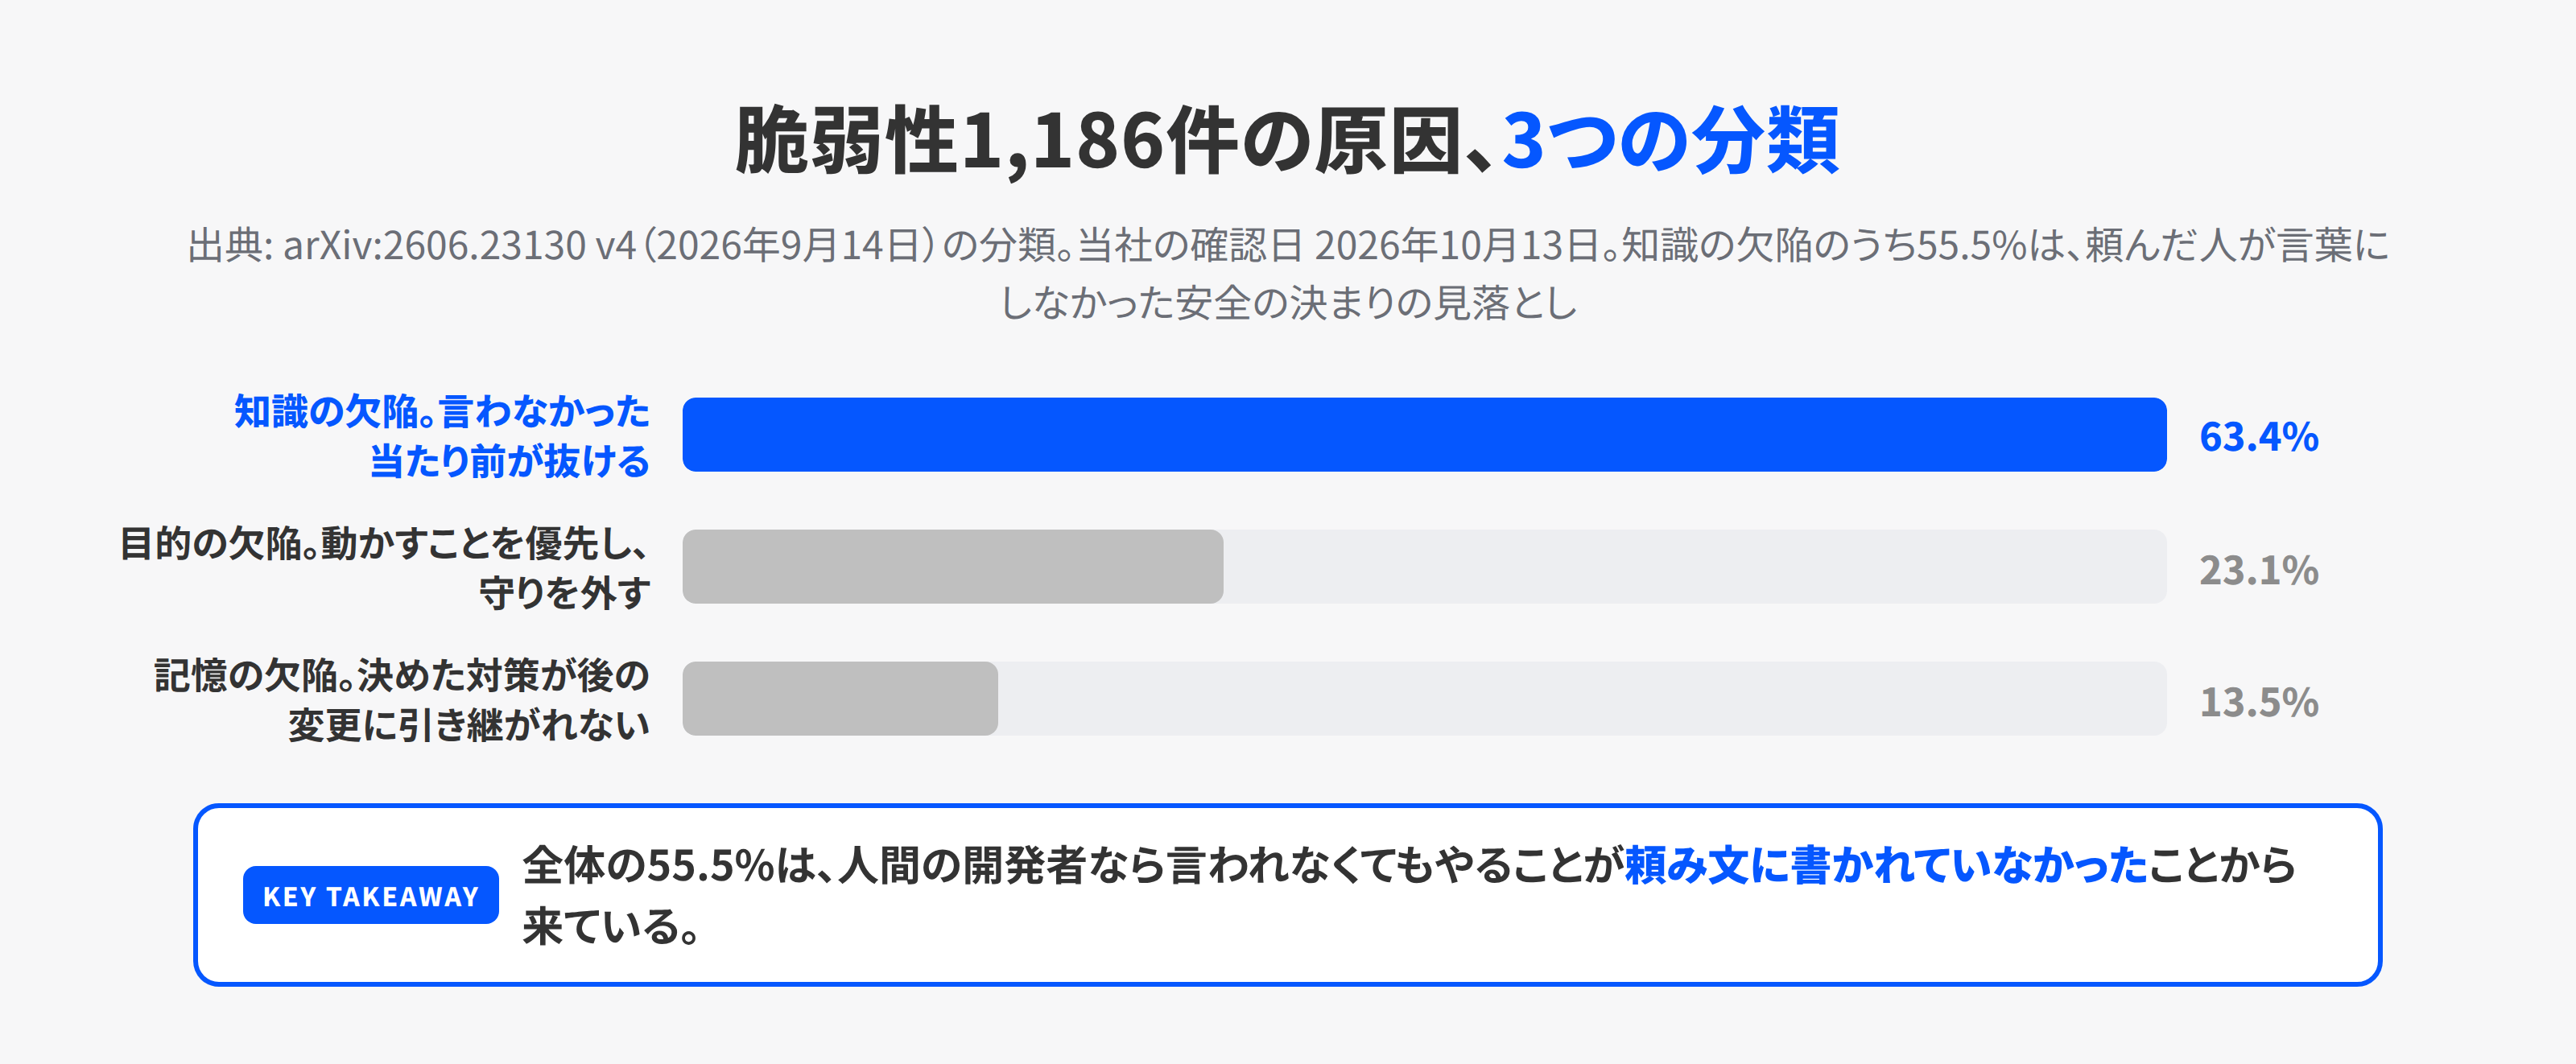
記憶の欠陥(13.5%)。 開発の途中で決めた安全対策が、後の変更に引き継がれない型です。論文の例では、APIキーを確かめる処理を新しいルーターに足したのに、既存の11個の処理には適用されていませんでした。ログインの処理でパスワードの確認をTODOのまま残し、そのまま公開されていた例もあります。
目的の欠陥(23.1%)。 安全より、まず動かすことを優先した型です。デモ向きの設計として、OAuthのトークンをbase64で変換しただけでブラウザのlocalStorageに保存していた例があります。もう1つは、見えているエラーを消すために守りを弱める型で、Supabaseの認証エラーを回避するために、固定の資格情報でログインを飛ばす経路が足された例が挙がっています。
知識の欠陥(63.4%)。 最も多い型です。その大半、全体の55.5%は、頼んだ人が言葉にしなかった安全の決まりをAIが見落としたものです。サーバーからの応答をエスケープせずに画面へ書き出す、入力を確かめずに危険な処理へ渡す、保存する前にパスワードをハッシュ化しない。人間の開発者が言われなくてもやることが、頼み文に書かれていないと抜けます。この型には、AIが使う人の作業を暗黙に当てにしていた問題も含まれます。アプリがデータベースの内容を書き出したファイルを、使う人がGitから除外することを前提にしていたのに、その前提はどこにも書かれておらず、ファイルが公開リポジトリにコミットされていた例がそれです。
会社の言葉に置き換えると、次の表になります。
| 論文の分類 | 会社で起きること | 誰が気づけるか |
|---|---|---|
| 記憶の欠陥 | 最初に決めたルールが、機能を足すたびに抜ける。「後でやる」が公開まで残る | 変更のたびに一覧と照らす人 |
| 目的の欠陥 | 動かすことを急いで、仮の設定のまま公開する。エラーを消すために守りを外す | 公開の可否を決める人 |
| 知識の欠陥 | 言わなかった当たり前が抜ける。使う人の側の作業が抜ける | 頼み文を書く人と、公開前に見る人 |
一言で下がり、細かい指示で悪化する
論文の後半は、同じ作業を条件を変えてやり直させる実験です。再現できる脆弱性の中から、幻覚の型を除く7つの型にまたがる70件を選び、8つの条件でそれぞれ3回ずつ、合計1,680回やり直させて、同じ脆弱性をまた入れてしまう割合を測りました。各条件の割合は210回を分母にしています。
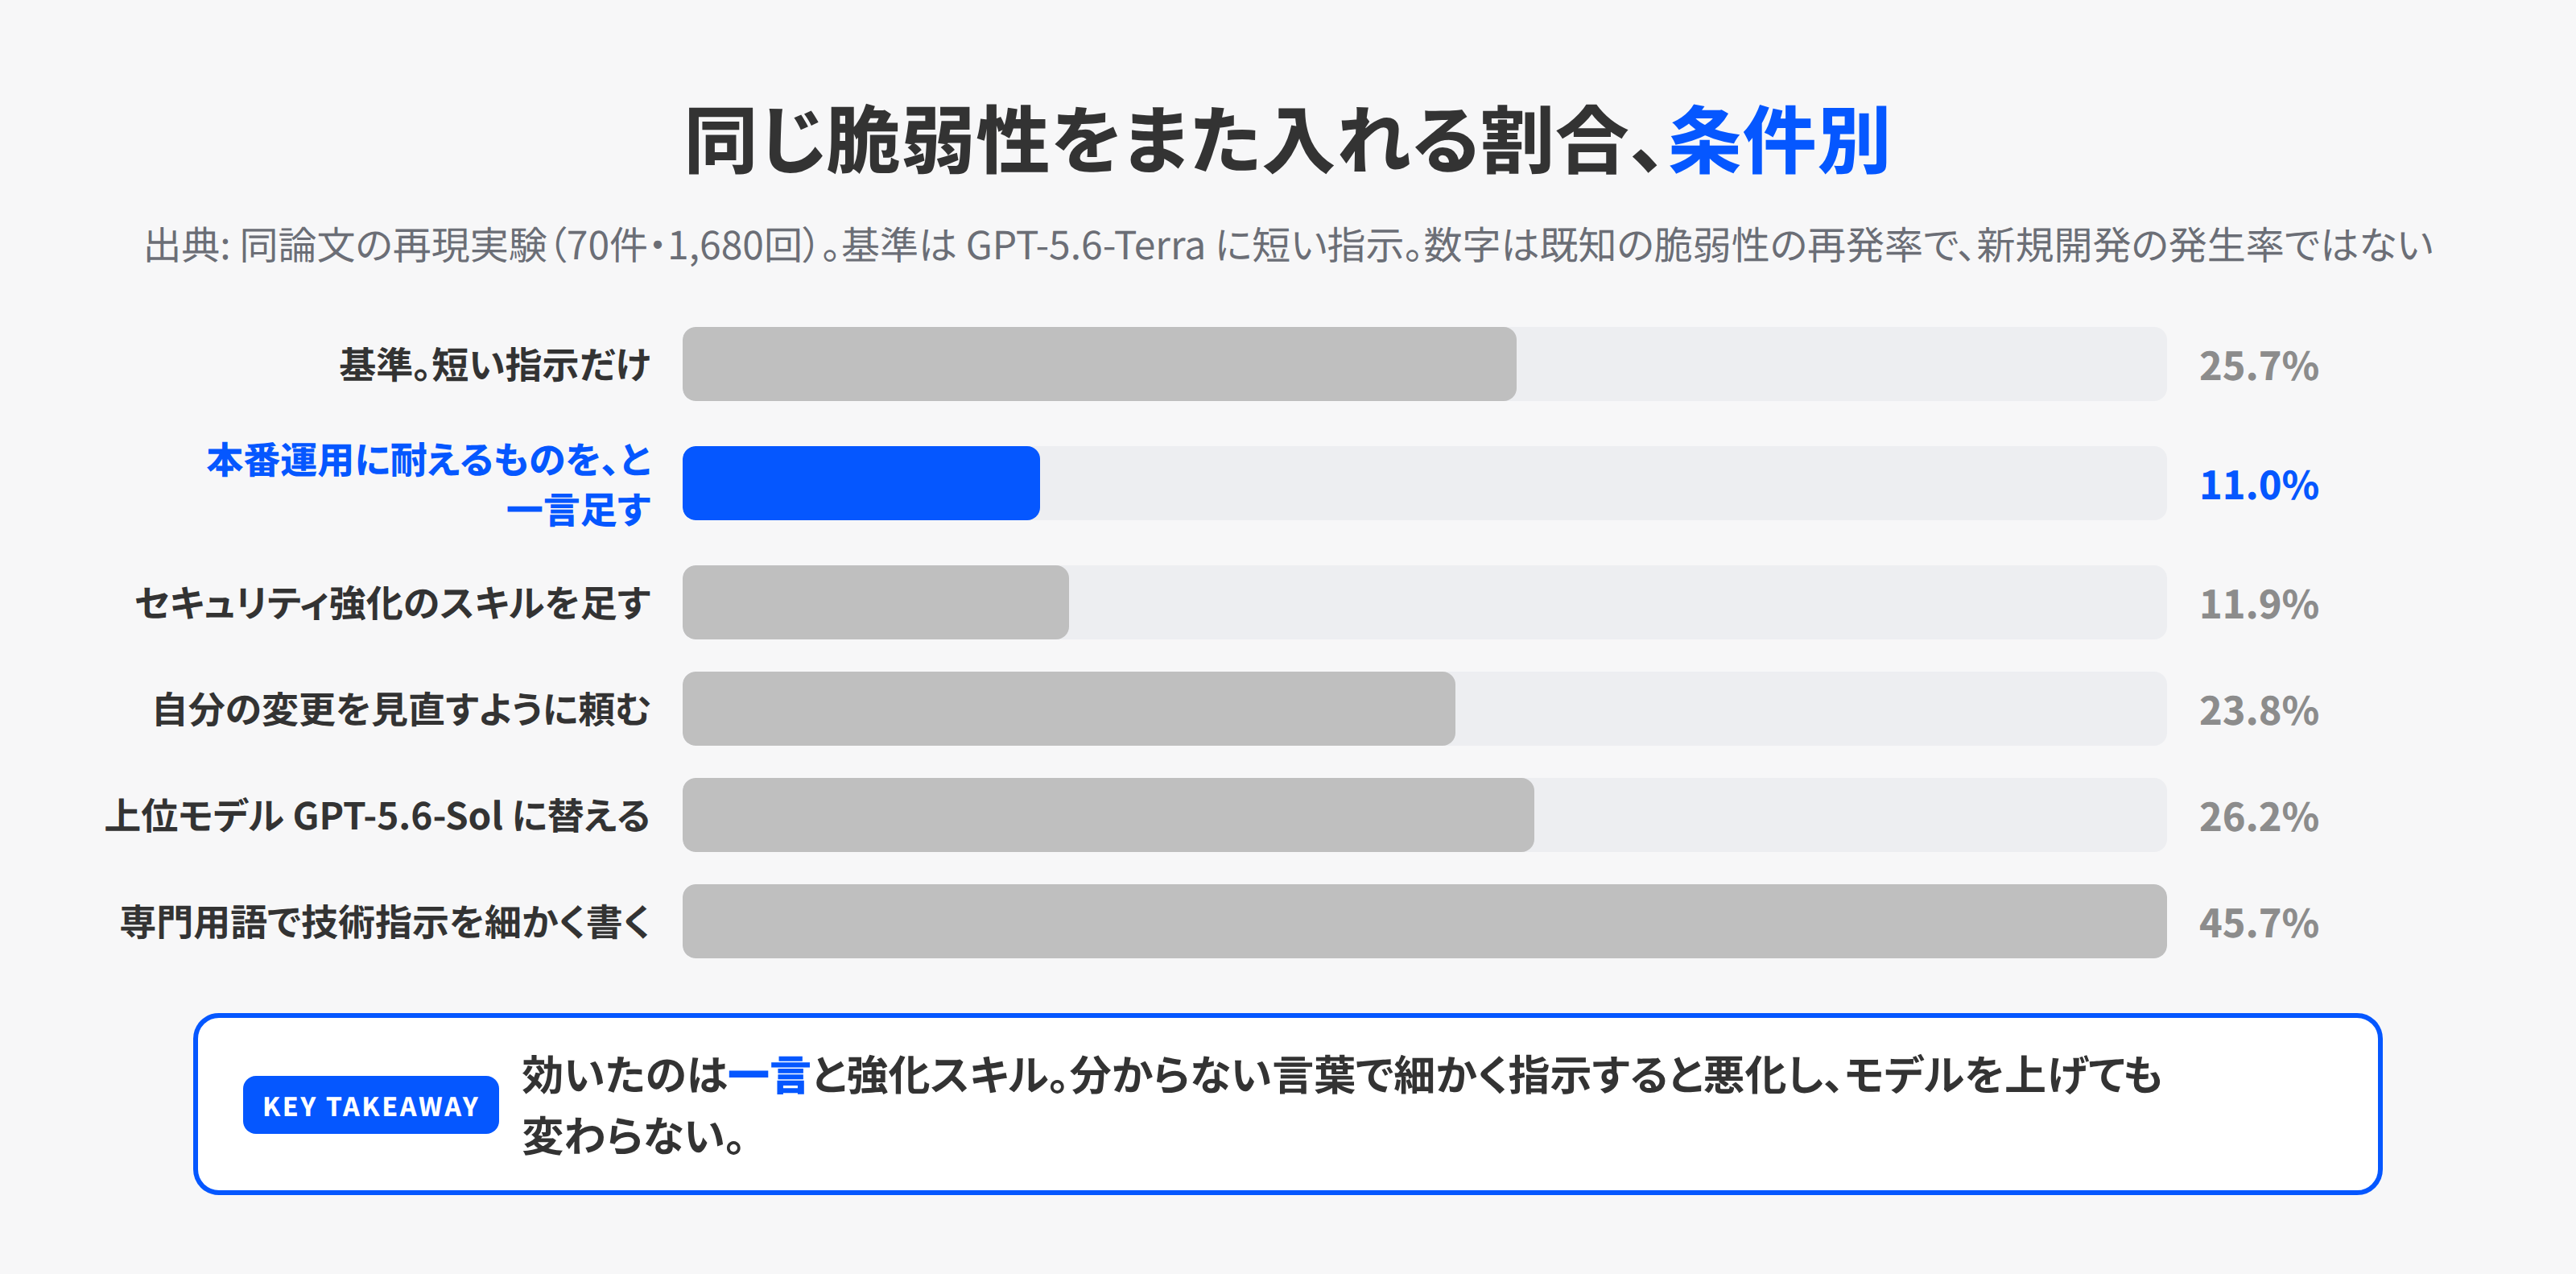
基準の条件は、GPT-5.6-Terraに短い指示を渡す形で、再発率は25.7%でした。頼み文に ready for production、本番運用に耐えるものを、と一言足すと11.0%に下がりました。実験の中では最も大きな改善です。セキュリティ強化のスキルを足した条件は11.9%で、ほぼ同じ効果でした。自分の変更を見直すように頼む自己確認は23.8%、構造の整ったコードを書くように求めた条件は22.9%で、どちらも小さな改善にとどまっています。
意外なのは2つです。1つは、専門用語で技術的な指示を細かく書いた条件が45.7%に悪化したことです。論文は、エージェントが指示をそのまま忠実に実装した結果だと見ています。細かい技術指示には、安全の決まりを押し出してしまう面があるということです。もう1つは、上位のモデルに替えても改善を保証できなかったことです。弱いモデルのGPT-5.6-Lunaは39.5%で基準より悪く、強いGPT-5.6-Solは26.2%で、基準の25.7%とほぼ同じでした。論文は、モデルの規模を上げるだけでは安全性の改善は当てにできない、という趣旨を書いています。さらに、危険を認識していながら実装した回が、再発した回の20.7%あったことも書かれています。
この実験の数字は、既知の脆弱性を再び入れるかどうかを測ったもので、新しく開発するときの発生率ではありません。それでも、頼み文の一言と、専門用語の多い指示の逆効果は、自社で頼むときにそのまま使える知見です。
自社で作ったアプリを公開する前の5つの点検
ここからが自社の話です。論文は末尾で、生成したアプリは試作品として扱い、実際の利用者に軽々しく触れさせないように、と勧めています。それを、社内で作ったアプリを社員や取引先に使わせる前の点検に置き換えます。
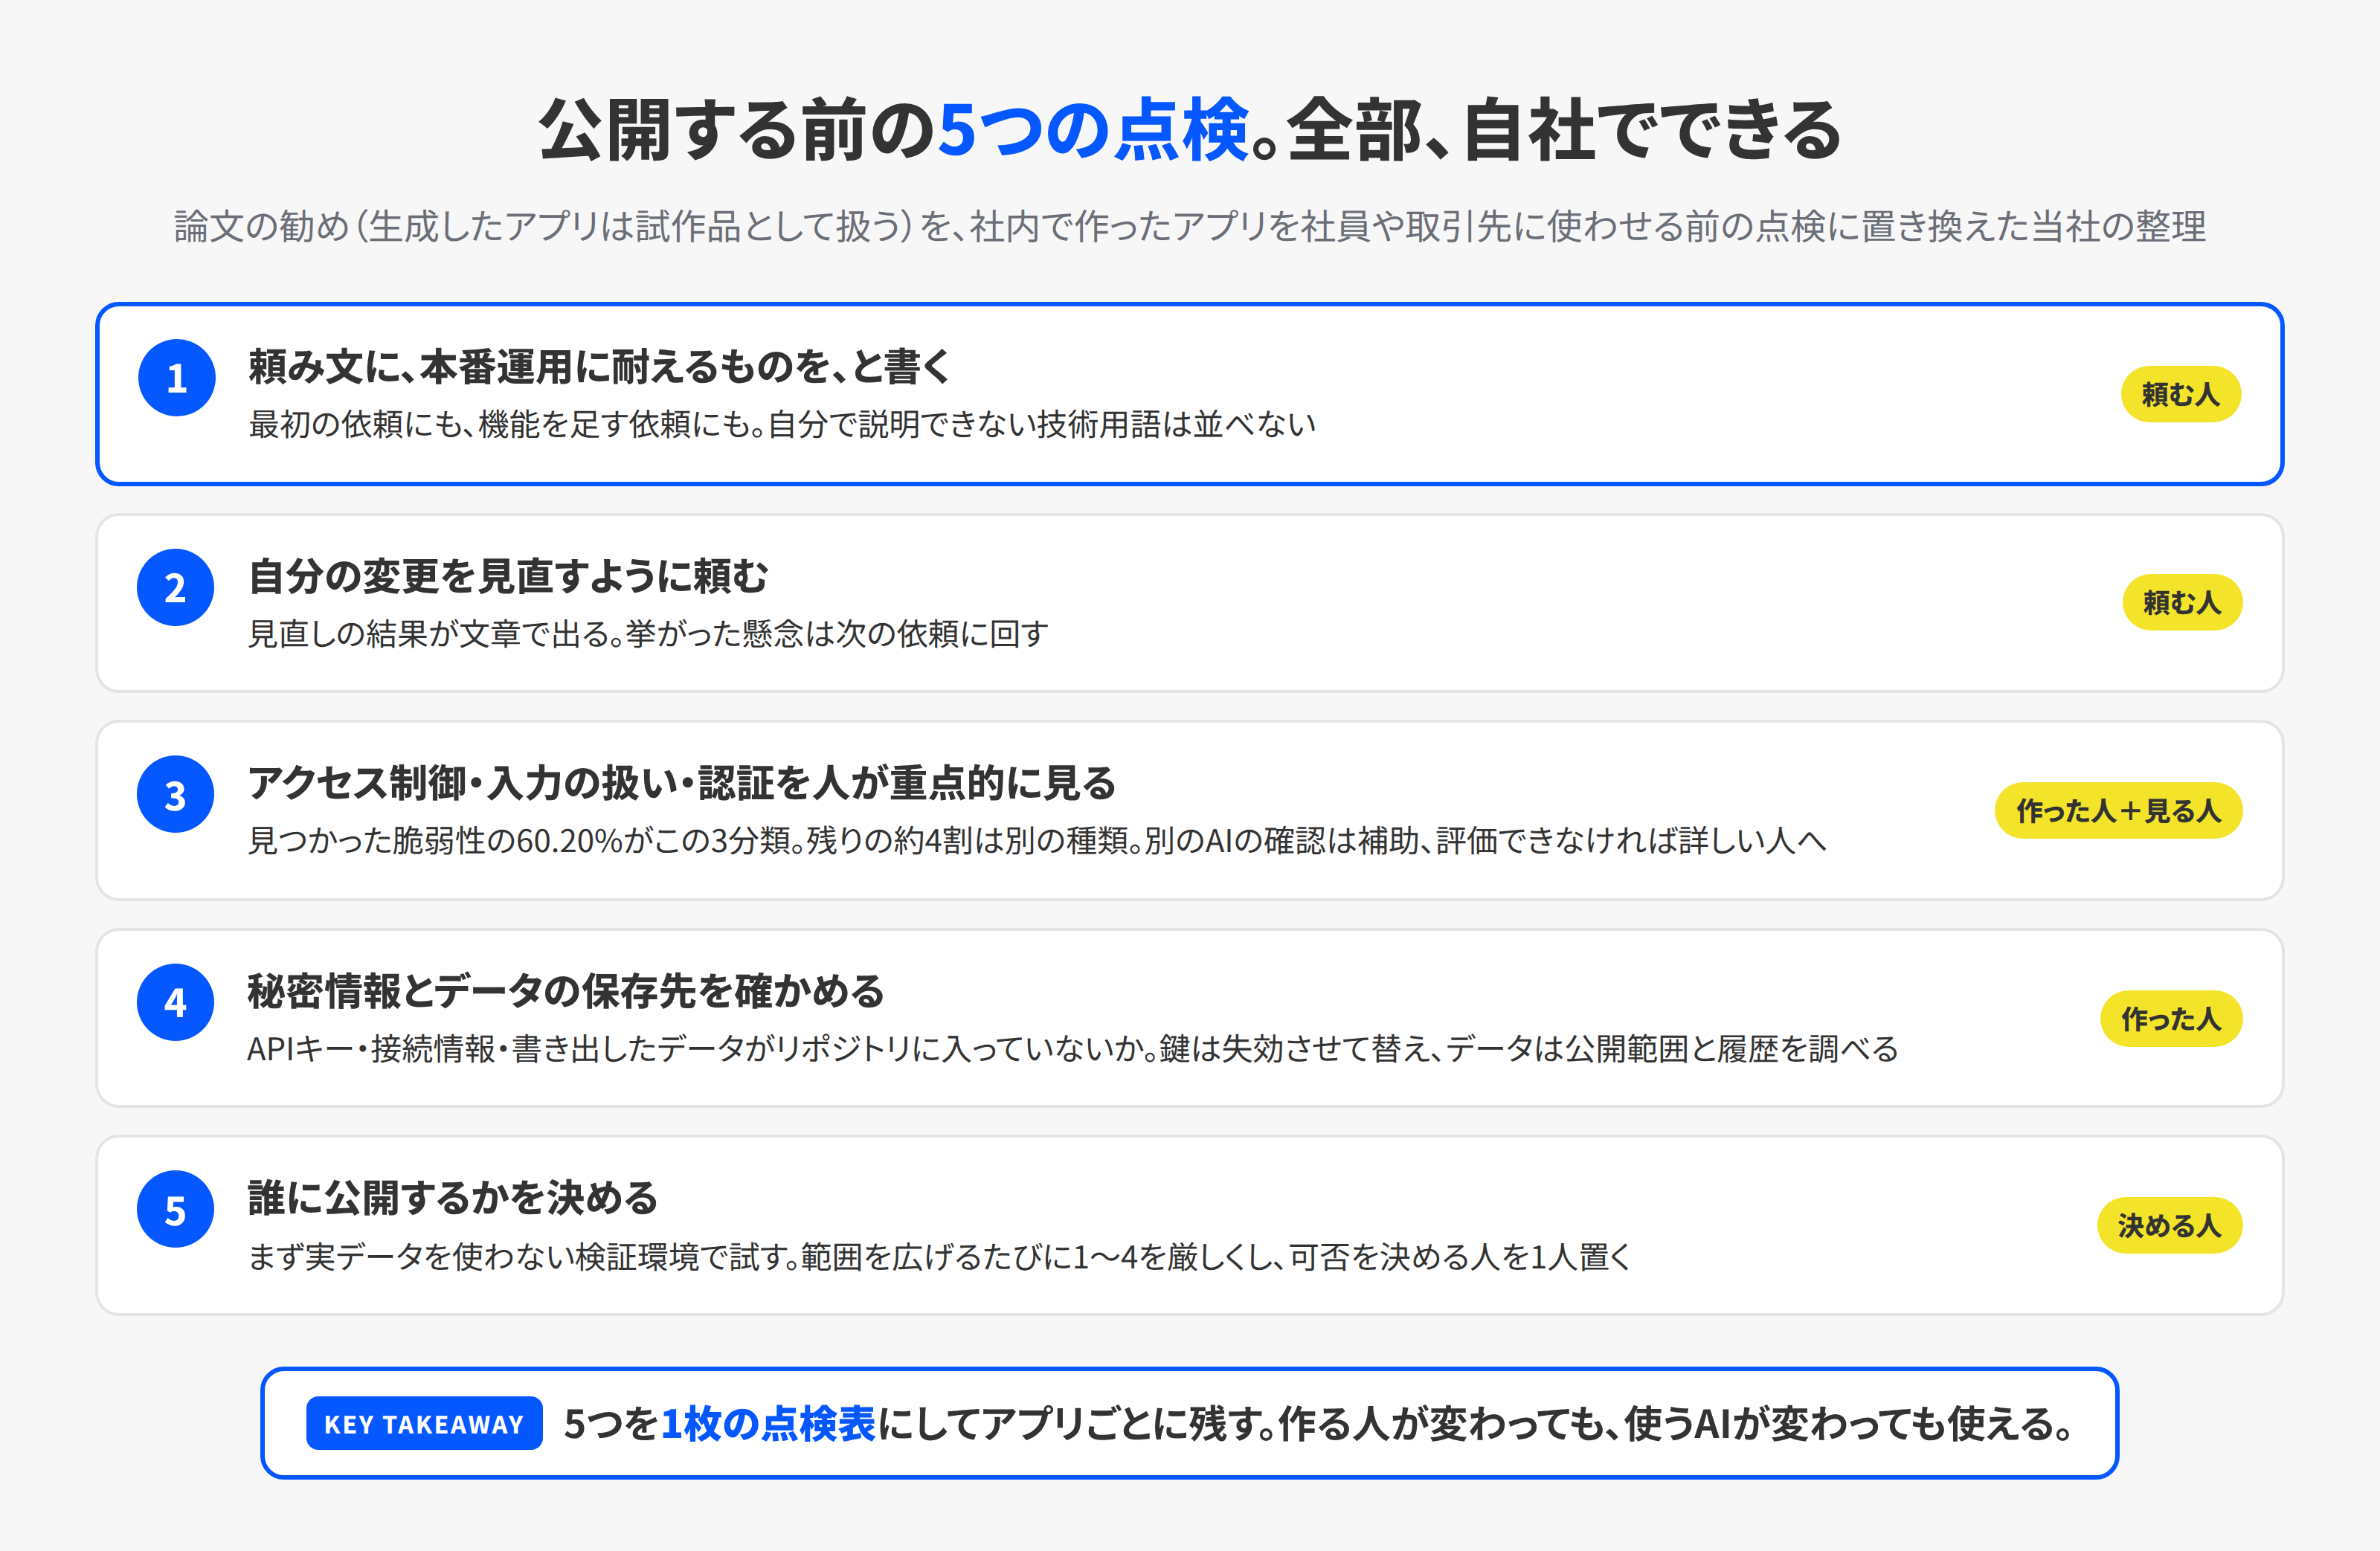
1. 頼み文に、本番運用に耐えるものを、と書く。 最初の依頼にも、機能を足す依頼にも書きます。費用はかからず、論文の実験では最も効果があった対策です。逆に、自分で説明できない実装方法を頼み文で指定しません。技術的な指示を詳しくした実験の条件では再発率が45.7%でした。指定するのは実装方法ではなく、守ってほしい安全の決まりのほうです。
2. 公開の前に、自分の変更を見直すように頼む。 効果は小さいものでしたが、見直しの結果が文章で出てくるので、次の点検で人が見る場所が分かります。見直しで挙がった懸念を、そのまま次の依頼に回します。
3. アクセス制御、入力の扱い、認証の3つを、人が重点的に見る。 見つかった脆弱性の60.20%が、アクセス制御の不備、インジェクション、認証の不備の3分類でした。まずこの3つを見ます。ログインしていない人、または別の人のデータに触れる操作がないか。画面やAPIから受け取った値を、確かめずにデータベースや画面に渡していないか。パスワードやトークンが、そのまま保存されたりブラウザに置かれたりしていないか。ただし、この3分類で点検が終わるわけではありません。残りの約4割は別の種類です。別のAIにこの観点で読ませるのは補助として有効ですが、挙がった指摘と直した内容を社内で評価できないときは、セキュリティに詳しい人に確認を頼みます。
4. 秘密情報とデータの保存先を確かめる。 APIキー、データベースの接続情報、書き出したデータのファイル。これらがリポジトリに入っていないかを確かめます。APIキーやパスワードが入っていたら、公開前に失効させて新しいものに替えます。データのファイルが入っていたら、失効はできないので、どこまで公開されていたかと履歴を調べ、公開の停止と漏えい対応の要否を決めます。鍵の種類によっては、漏れても提供元から知らせが来ないことは、漏れたAPIキーを誰が止めるかに書きました。
5. 誰に公開するかを決める。 社内の数人で使うのか、全社員か、取引先か、インターネットの誰でもか。範囲が広がるほど、上の4つの点検を厳しくし、公開の可否を決める人を1人置きます。論文は、生成したアプリは試作品として扱い、実際の利用者に軽々しく触れさせないように勧めています。当社はそれを受けて、まず実データを使わない検証用の環境で試し、点検の結果に応じて利用者と公開の範囲を決めることを勧めます。社員も実際の利用者です。
この5つを1枚の点検表にして、アプリごとに記入して残します。点検表は自社のもので、作る人が変わっても、使うAIが変わっても使えます。
注意点
点検表があっても、ゼロにはなりません。 論文は、どの条件でも対象の脆弱性をすべて防げた設定はなかった、と書いています。点検表は、公開してよい範囲を決めるための道具で、安全の保証ではありません。
91%を、社内のアプリにそのまま当てないでください。 数字は公開稼働中のオープンソースのアプリのものです。社内のアプリは条件が違います。ただし、原因の3分類は頼み方と作り方から来ているので、社内のアプリでも同じ種類の問題が起きる可能性はあります。3分類は点検の参考として使います。
自社で点検できない範囲は、外に出す前に線を引いてください。 決済、個人情報、取引先のデータに触れるアプリは、上の5つの点検に加えて、専門家の診断を受けるかどうかを決めます。その判断自体は自社でできます。
KOIYALの見解
AIでアプリが作れるようになって、作る費用は下がりました。下がっていないのは、公開してよいかを決める責任です。論文が示したのは、その責任をモデルの性能に預けられないことだと当社は読みました。今回の実験では、上位のモデルに替えるより、本番運用に耐えるものを求める一言のほうが再発率を下げました。当社は、それに加えて人が見る点検を勧めます。人の点検の効果は論文の実験では測られていませんが、公開の可否を決めるのは人だからです。
当社は、インハウス経営(AIを活用し、自社で業務を改善し、自社で仕組みをつくる経営)を目指す会社に向けて、作る力と同じだけ、点検して公開を決める力を社内に残すことを勧めています。点検表を自社で持ち、公開の可否を決める人を自社で決める。アプリは外注で作っても、この2つを外に出すと、次のアプリでまた同じ場所から始めることになります。
次の行動
- 社内でAIに作らせたアプリを一覧にし、誰が使っているかと、公開の範囲を書く
- 一覧の中で、取引先かインターネットに公開しているものから、上の5つの点検をかける
- 点検表を1枚にして、次にアプリを作るときのプロンプトの末尾に、本番運用に耐えるものを、と書き足す
社内のアプリを一覧にしたら、FDE型支援の初回で一緒に点検表を作ります。点検表は御社のものとして残し、当社が離れた後も使えるようにします。お問い合わせの本文に、アプリの数と公開の範囲を書いていただければ、初回の前に点検の順番を当社で仮に組みます。
参考
- バイブコーディングで作った公開中のWebアプリ、9割に脆弱性 MSの研究者など調査(ITmedia NEWS・2026年10月7日。確認日2026年10月13日)
- Understanding the (In)Security of Vibe-Coded Applications(arXiv:2606.23130・v4 2026年9月14日。確認日2026年10月13日)
- 社内ツールをAIで内製する。SaaS購入前の判断基準と実例(KOIYAL・2026年8月28日)
- 漏れたAPIキーを誰が止めるか。国内SaaSは自社で守る(KOIYAL・2026年10月17日)
- Microsoft Execution Containersでエージェントの権限をコントロールする(KOIYAL・2026年10月16日)
- FDE型支援(KOIYAL)