

社内の規程を読んで答えるAIに、出張の日当を聞いた。AIは金額を即答し、根拠の文書も添えた。その文書は、2年前に改定される前の旅費規程だった。
答えは自信にあふれていて、読んだ人は疑わなかった。社内AIを動かしている会社で、形を変えて起きていることです。
KiteRaが2026年9月3日に発表した調査では、勤務先でAIエージェントを利用または検証している1,206人のうち、AIエージェントが古い社内ルールや最新かどうか分からないデータを参照したことで、規程や法令に違反しそうになった、または違反した人が13.4%でした。
手続きを誤って進めそうになった、または実際に誤った人が23.2%、顧客や取引先に誤った説明をしそうになった、または実際に説明した人が23.1%です。
この記事は、社内AIが古い記憶で間違える原因の1つと、取ってきた記憶を信じるかどうかをどう決めるのかを書きます。
材料は、2026年9月18日にarXivに公開された論文で、検索と生成の間に、記憶を信じるかを決める判断の層を置くという提案です。
読者は、社内文書を読むAIを作っている、または運用している情報システムやAI推進の担当者と、その仕組みに決裁する経営者です。
結論を先に書きます。
- 古い記憶で間違える原因の1つは、取ってきた文書を無条件に採用する設計にあります。 論文はこれを、取得すなわち採用、と呼びます。正答と誤答の両方を含む記憶をすべて読ませた実験では、文書を読ませないときより間違いが増えました。検索対象の整備と、採用の判断の両方が要ります
- 論文は、記憶を信じるかを3つの信号で決めます。 質問との関連度、記憶どうしの信頼度、そして業務のリスク。3つを合わせて確信度を出し、確信度とは別に、判断の向きが合っているかを示す一貫性を見ます。リスクが高いほど控えめになり、答えないという選択肢を持ちます
- 自社の社内AIに入れる形を、当社の未検証の設計例として書きます。 関連度は検索に任せ、業務リスクは質問の分類表で、文書の改定日と持ち主は採用の追加の条件として使い、論文の4つの動作を参考に、人に回す動作を加えます。当社がJevの確信度しきい値を決めたときと同じく、過去の記録から表を作って決めます
- 判断の層は、文書の掃除の代わりにはなりません。 論文自身が、記憶をそのまま使うと判断した場合にも8.0%の幻覚が残ると書いています。古い文書を読ませる範囲から外す作業は、判断の層を入れても要ります
論文は何を提案したか
出どころを書きます。論文の題は「An Interpretable Memory Decision Controller for LLM Agents Based on Three-Signal Complementarity: Decoupling Confidence and Consistency」、著者はYiming Zhang氏ほか4名で、2026年9月18日にarXivに第1版が公開されました。
査読前のプレプリントです。当社はarXivの要旨とHTML版を2026年11月16日に読みました。
対象は、LLMエージェントが過去のやり取りや文書を記憶として検索し、それをもとに答える仕組みです。RAG(検索拡張生成)と同じ構造で、社内文書を読んで答えるAIの多くがこの形です。
論文が問題にするのは、検索で取り出した記憶を、生成AIがそのまま採用することです。論文はこれを retrieval as adoption、取得すなわち採用、と呼んでいます。
提案は、検索と生成の間に Memory Decision Layer という判断の層を置くことです。学習するパラメーターを持たず、幾何学的な計算だけで、取り出した記憶をどのくらい信じるかを点数にし、点数に応じて4つの動作を選びます。
論文は、この層が白箱で、判断の理由を後から人が追える、と書いています。
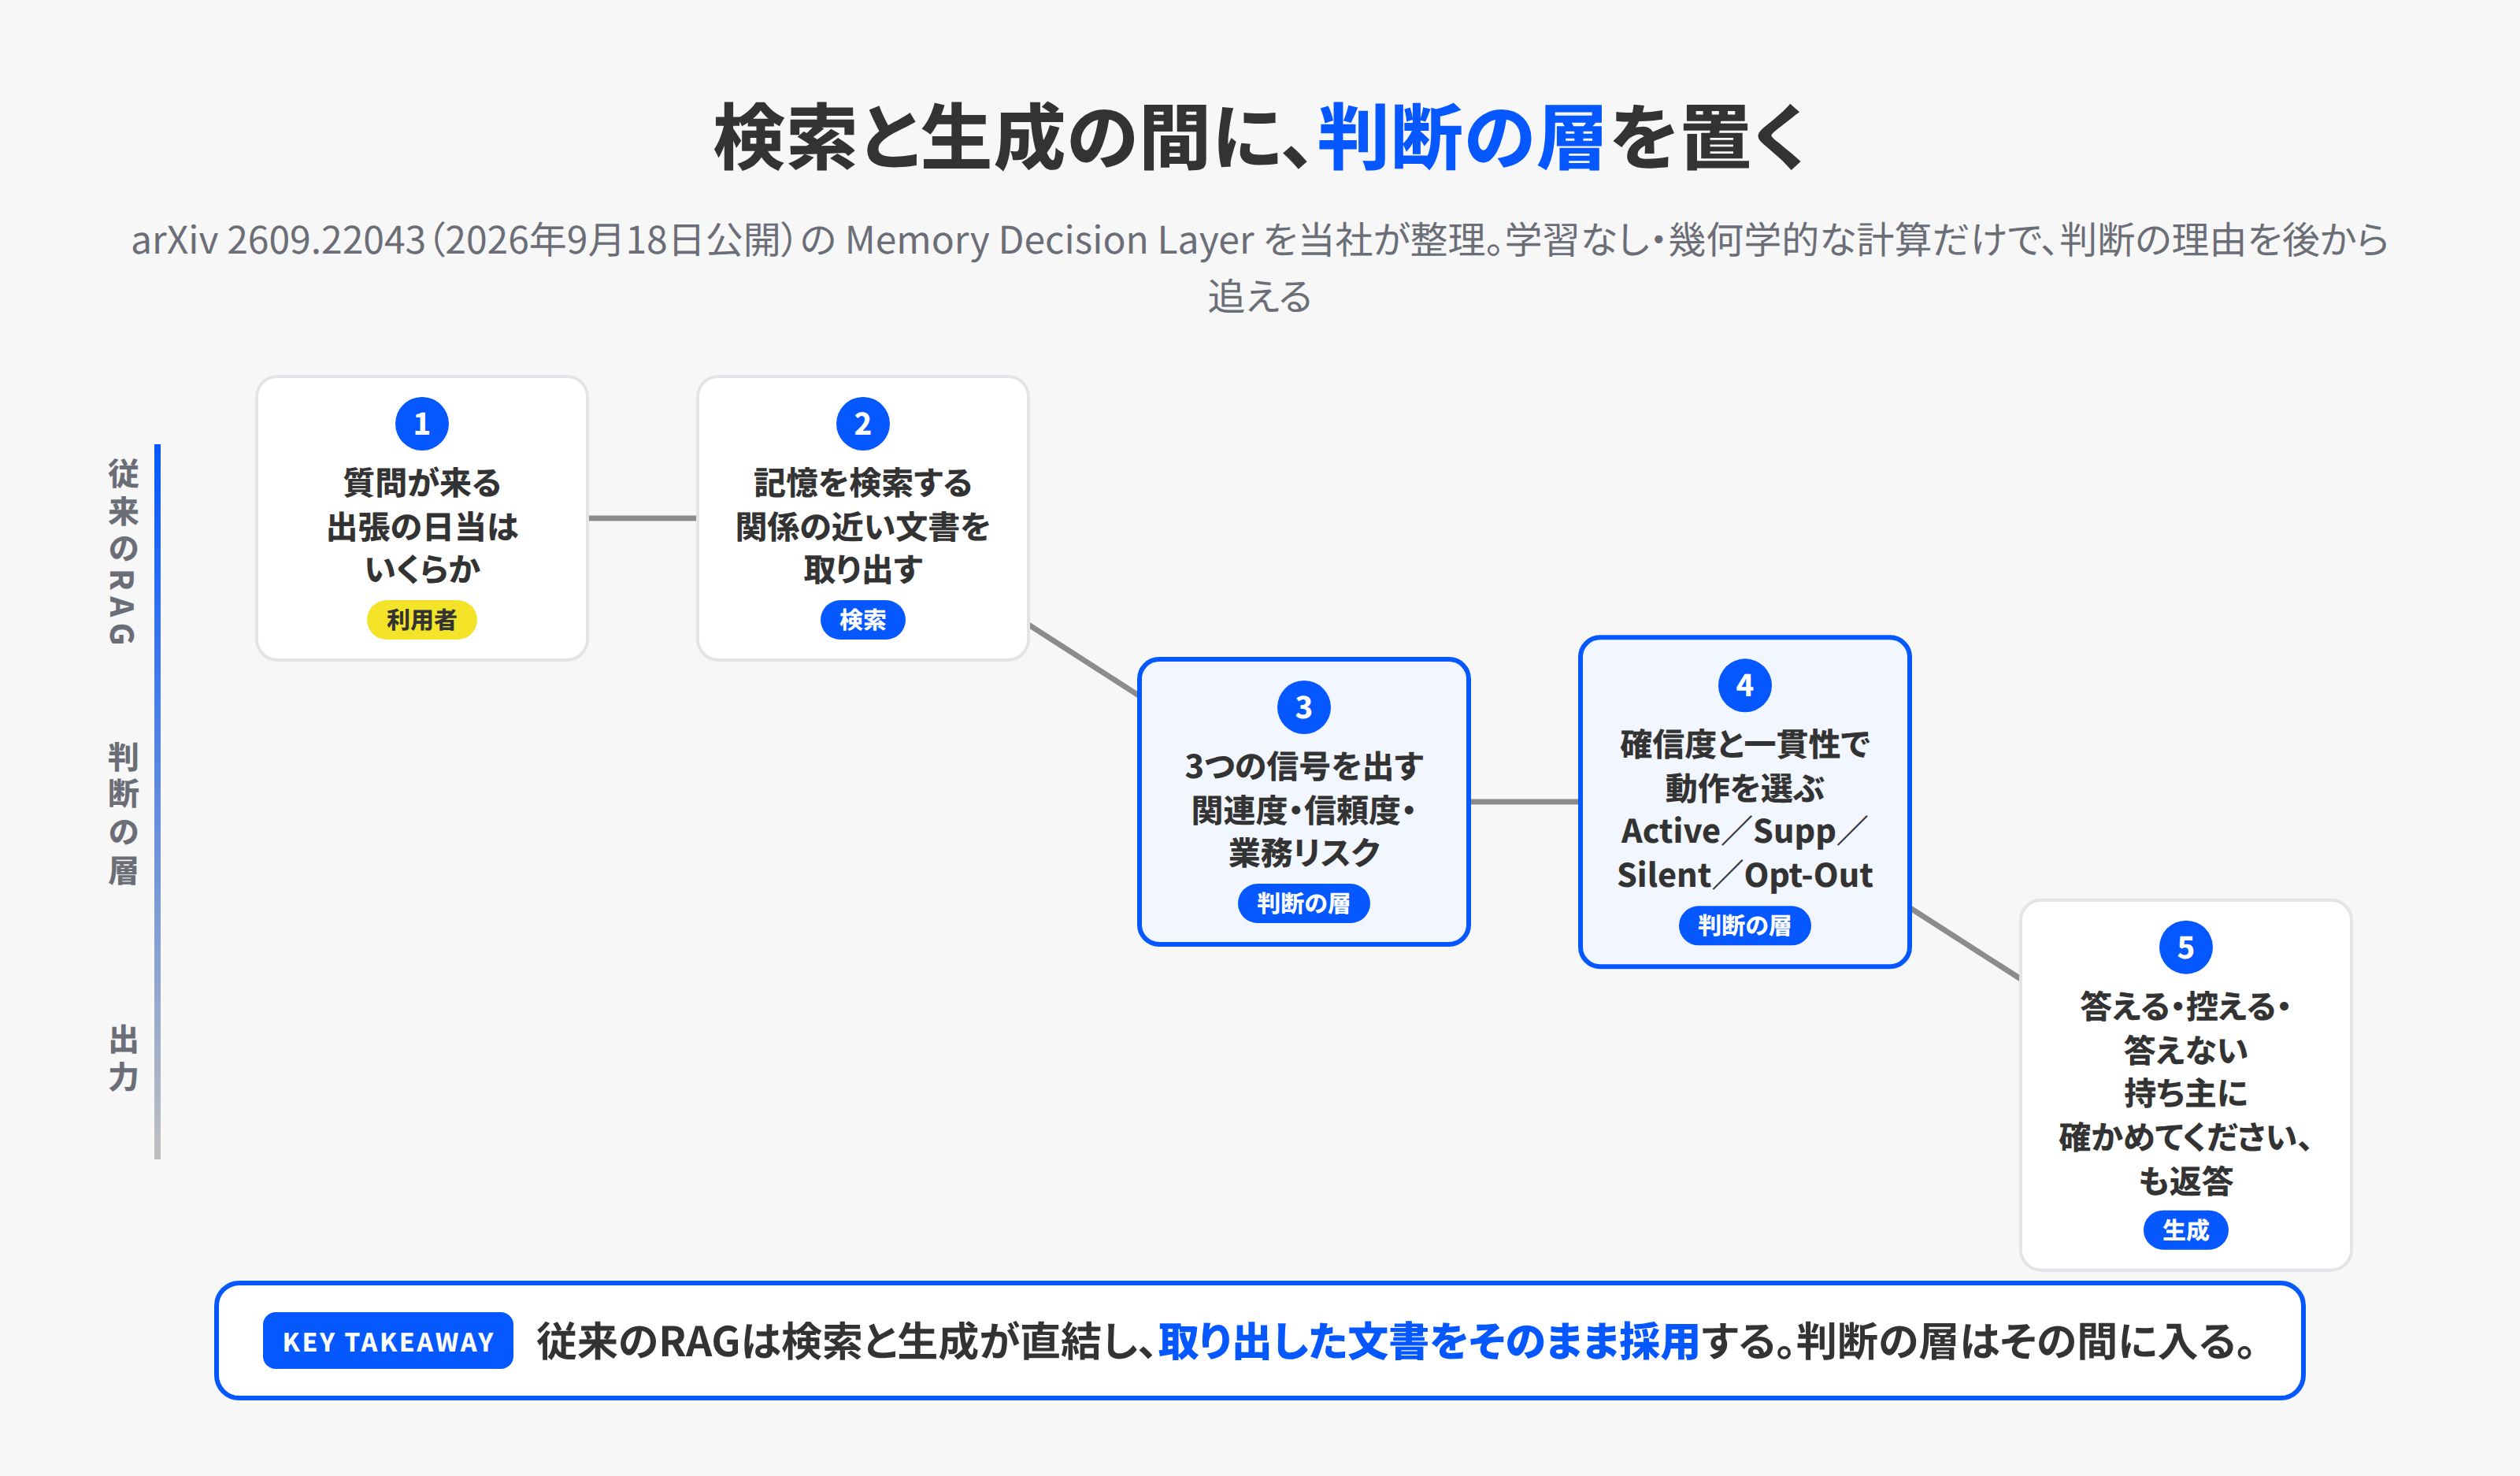
当社がこの論文を読んだ理由は、社内AIの間違いを、文書の掃除だけで防ごうとすると終わらないからです。文書は改定され続け、矛盾は必ず残ります。残った矛盾を、答える前にどう扱うか。その設計が、この層にあります。
なぜ古い記憶で間違えるのか
論文の実験で、当社がいちばん重く見た数字を先に書きます。オープンモデルのgemma-4-E4B-itにTruthfulQAという質問応答のベンチマークを解かせたとき、記憶を読ませない場合の幻覚率は23.0%でした。
正答と誤答を含む候補の記憶をすべて読ませる、通常のRAGの構成では、53.0%でした。実験のために矛盾する記憶を組み合わせた構成なので、一般の社内検索の誤答率ではありません。
それでも、矛盾する記憶が入ると間違いが増える、という方向は示されています。
理由を、当社の理解で書きます。検索は、質問との関係の近さで文書を取り出します。取り出した文書の中に、改定前の規程と改定後の規程の両方があれば、両方が生成AIに渡ります。どちらが今の規程かを判断する材料は、渡されていません。
社内文書に置き換えると、こうなります。旅費規程が3回改定されて4つのファイルがある。日当の質問に対して、4つとも日当という言葉を含むので、4つとも検索に引っかかる。
生成AIは4つを読み、金額が書いてあるものから答えを作る。改定前の規程が検索の結果に混ざっていると、改定前の金額を答えに採用する可能性があります。
原因はこれだけではありません。検索の対象の更新の抜け、有効期間で絞り込んでいないこと、生成のときの解釈も、古い答えの原因になります。
ただ、検索が正しく日当に関する文書を取り出していても、取り出した後に信じてよいかを判断する段階がなければ、間違いは防げません。論文が置こうとしているのは、この段階です。
3つの信号
判断の層は、取り出した記憶について、3つの信号を計算します。論文の定義を、当社の言葉で書きます。
| 信号 | 論文の計算 | 何を見ているか | 社内文書に置き換えると |
|---|---|---|---|
| 関連度 | 質問の埋め込みと、候補の記憶の埋め込みの類似度の最大値 | 質問に関係のある記憶があるか | 検索のスコア。すでにある |
| 信頼度 | 関連する記憶どうしの類似度の平均に、矛盾の割合の補数の2乗を掛ける。矛盾は否定・肯定否定・反意語を語彙で検出 | 取り出した記憶どうしが矛盾していないか | 改定日が違う同じ規程、金額が違う同じ項目があるか |
| 業務リスク | 質問の分野ごとの係数。健康・法律・金融などは高い値 | 間違えたときの被害の大きさ | 法令・契約・人事・金銭に関わる質問か |
関連度は、通常の検索がすでに持っている信号です。論文も、関連度だけで採否を決めるのが問題だと言っているので、新しいのは残りの2つです。
信頼度は、取り出した記憶どうしの関係を見ます。質問に関係する記憶が複数あって、その中身が互いに合っていれば信頼度が高く、矛盾していれば低くなります。
論文の実装では、矛盾の検出は語彙に基づいていて、否定の語、はい・いいえの向き、反意語の組で判定します。社内文書で言えば、同じ規程の名前で改定日が違うファイルが2つ取り出された時点で、信頼度を下げる、という使い方になります。
業務リスクは、質問の分野で決めます。論文では、健康、法律、金融、陰謀論に関する質問を高リスクに置いています。社内文書で言えば、法令、契約、人事、金銭に関わる質問を高リスクにします。
この信号は、記憶の中身ではなく、質問の種類から決まります。だから、文書の側に何も手を加えなくても、質問を分類する表があれば作れます。
3つの信号は、互いに補い合う関係にあります。関連度が高くても信頼度が低ければ、矛盾した記憶を根拠にしようとしている。
関連度も信頼度も高くても業務リスクが高ければ、間違えたときの被害が大きい。1つの信号で決めず、3つを合わせて決めるのが、論文の題にある相補性の意味です。
確信度と一貫性を分ける
3つの信号を合わせて、判断の層は確信度を出します。ここで論文は、確信度と一貫性を分けます。これが副題の意味です。
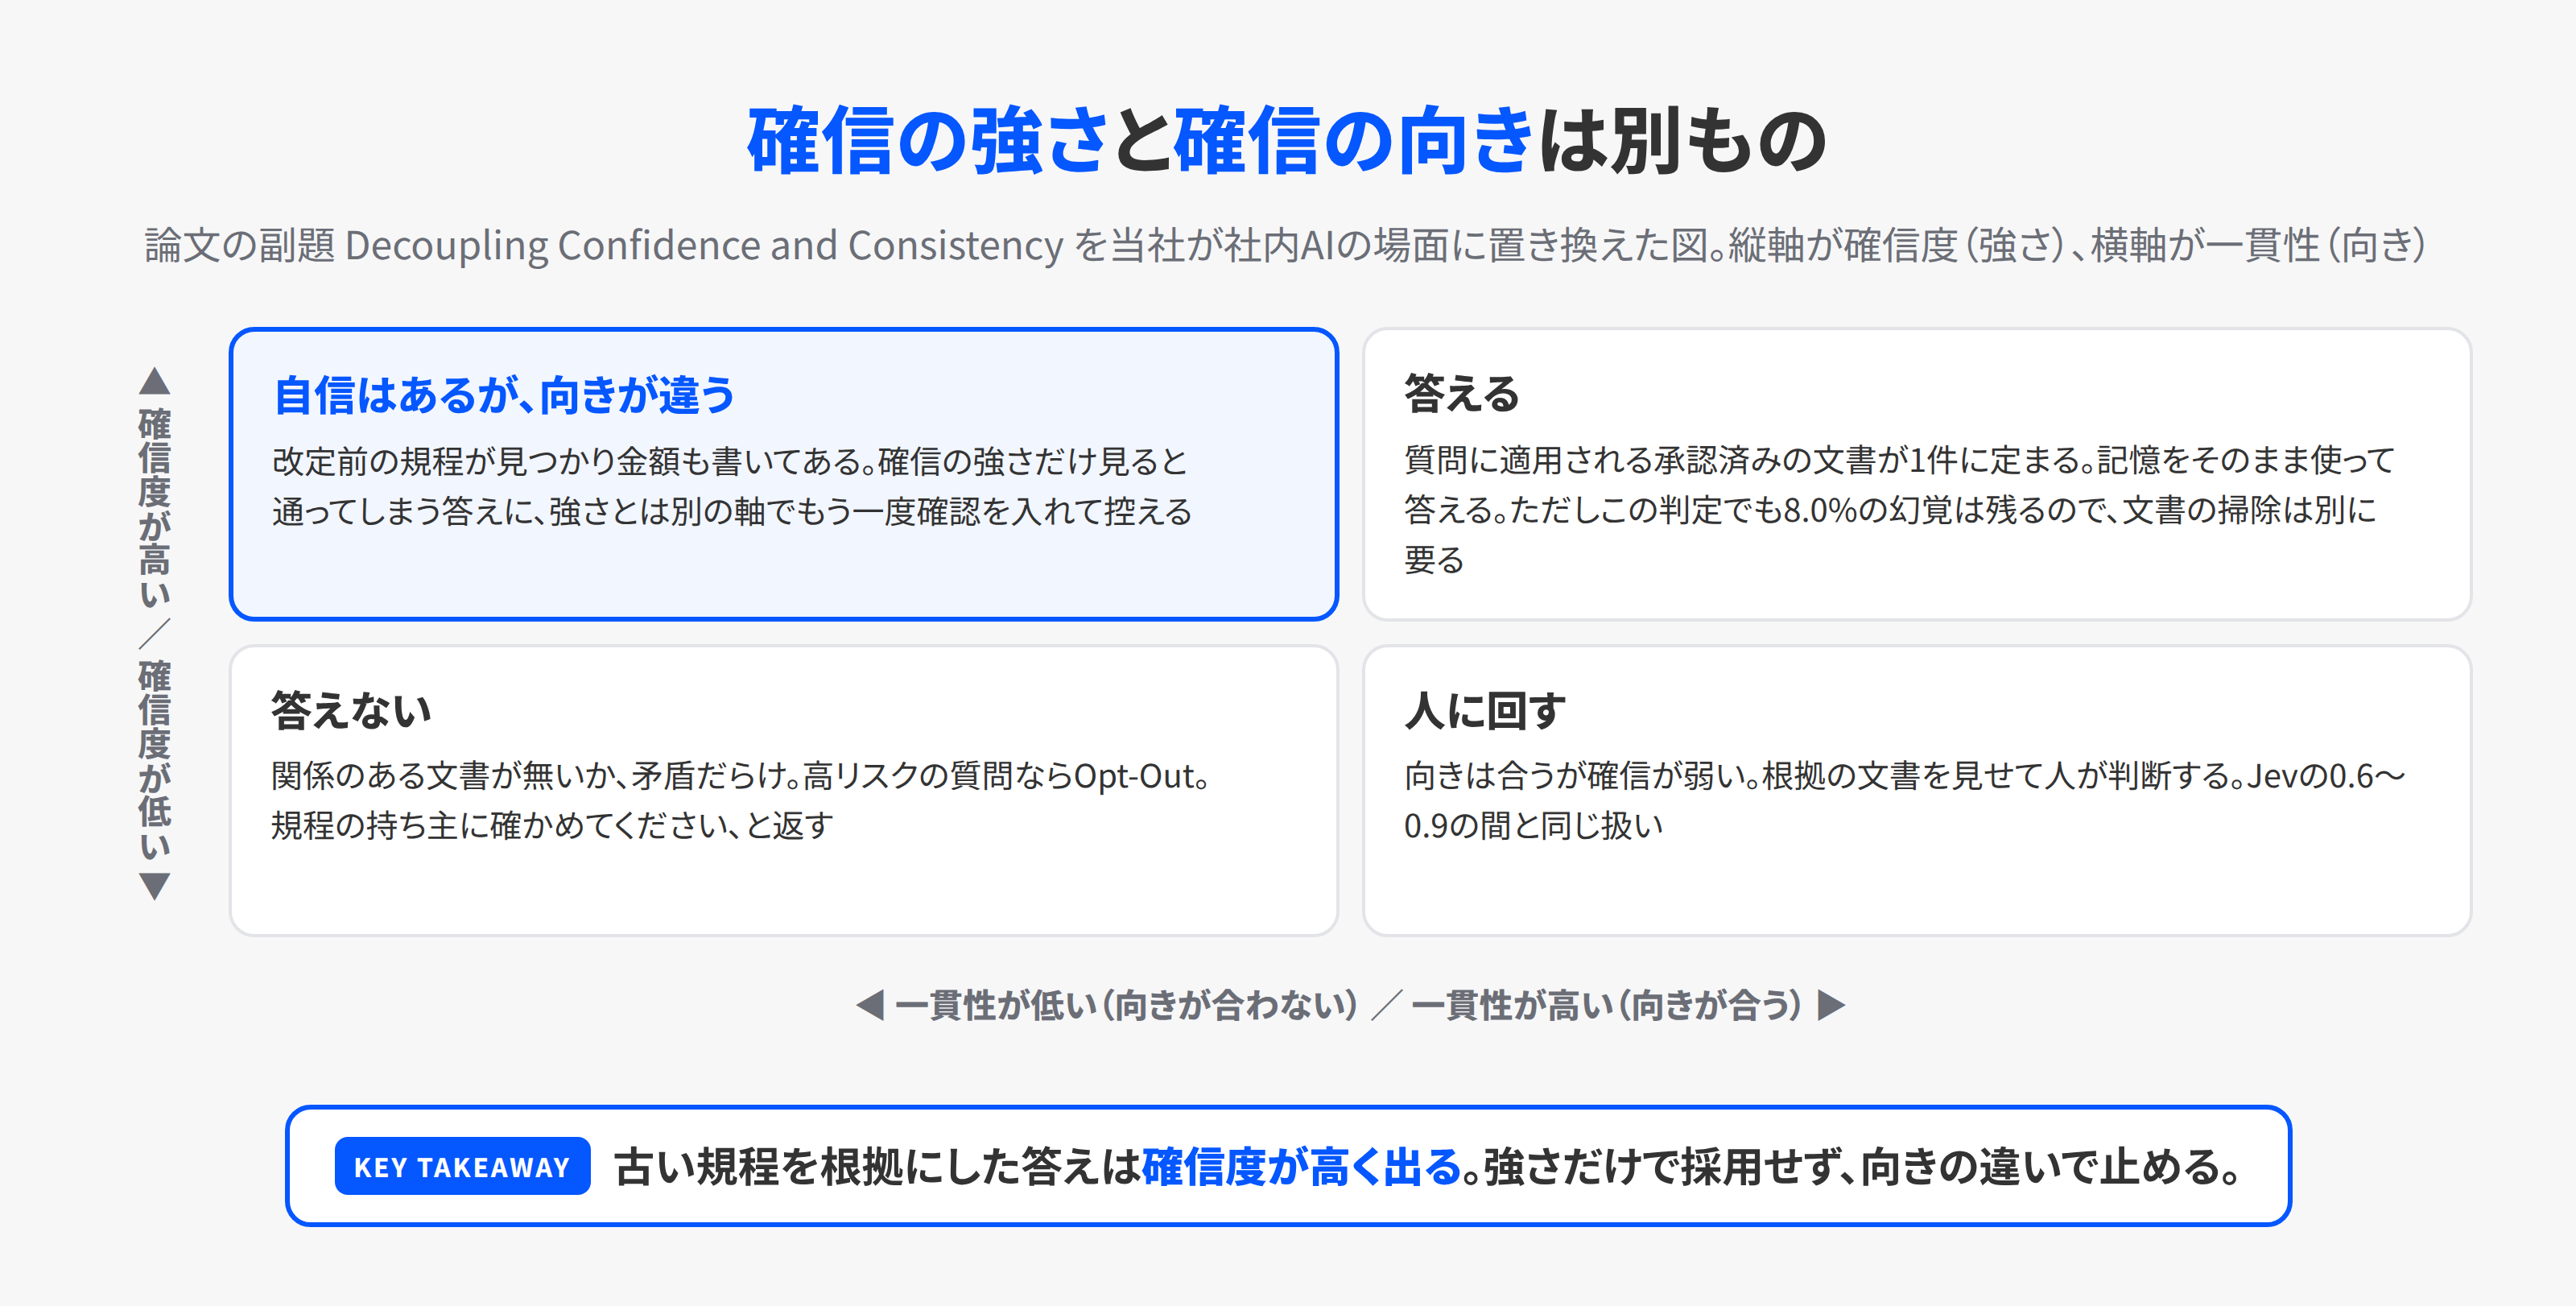
確信度は、3つの信号を合わせた判断の強さです。論文の計算では、信号を合成したベクトルの長さを0から1に収めたものです。どれだけ強く確信しているか、を表します。
一貫性は、判断の向きが合っているかです。論文の計算では、作業中の記憶のベクトルと、合成した判断のベクトルの間の角度の余弦です。確信の強さではなく、確信の向きが、いま扱っている文脈と合っているか、を表します。
論文は、最終的な確信度を、確信度に一貫性で重みをつけた値にしています。一貫性が低いと、確信度が高くても最終的な値は下がります。自信はあるが、向きが違う。この状態を検出するのが、分ける目的です。
論文は、2つが統計的に独立だとは言っていません。実験では相関係数が0.902と高い。それでも、一貫性は正しい判断と誤った判断を分けていて、その差は統計的に有意でした。論文の言い方では、2つは独立に説明でき、独立に監査できる、です。
社内AIの運用に引きつけて言えば、こういうことです。改定前の旅費規程を根拠にした答えは、確信度が高く出ます。文書は見つかり、金額も書いてある。
確信の強さだけを見ると通ってしまう答えに、強さとは別の軸でもう一度確認を入れる。これが、確信度と一貫性を分ける設計から当社が持ち帰った考え方です。
ただし、論文の一貫性は、関連度から作ったベクトルと合成した判断のベクトルの関係であって、文書の施行日と質問の時期を直接比べる指標ではありません。
規程が有効かどうかの判定は、一貫性には任せられないので、次の節以降で書く適用日と承認の状態の確認を、別に組み込みます。
リスクが高いほど控える。4つの動作
論文には、リスクの反転と呼ぶ設計があります。業務リスクの信号は、値が高いほど判断の層の活性を下げる向きで入れられています。リスクが高いほど、確信度が下がり、動作が控えめになります。
最終的な確信度は、3つのしきい値と比べられ、4つの動作のどれかになります。
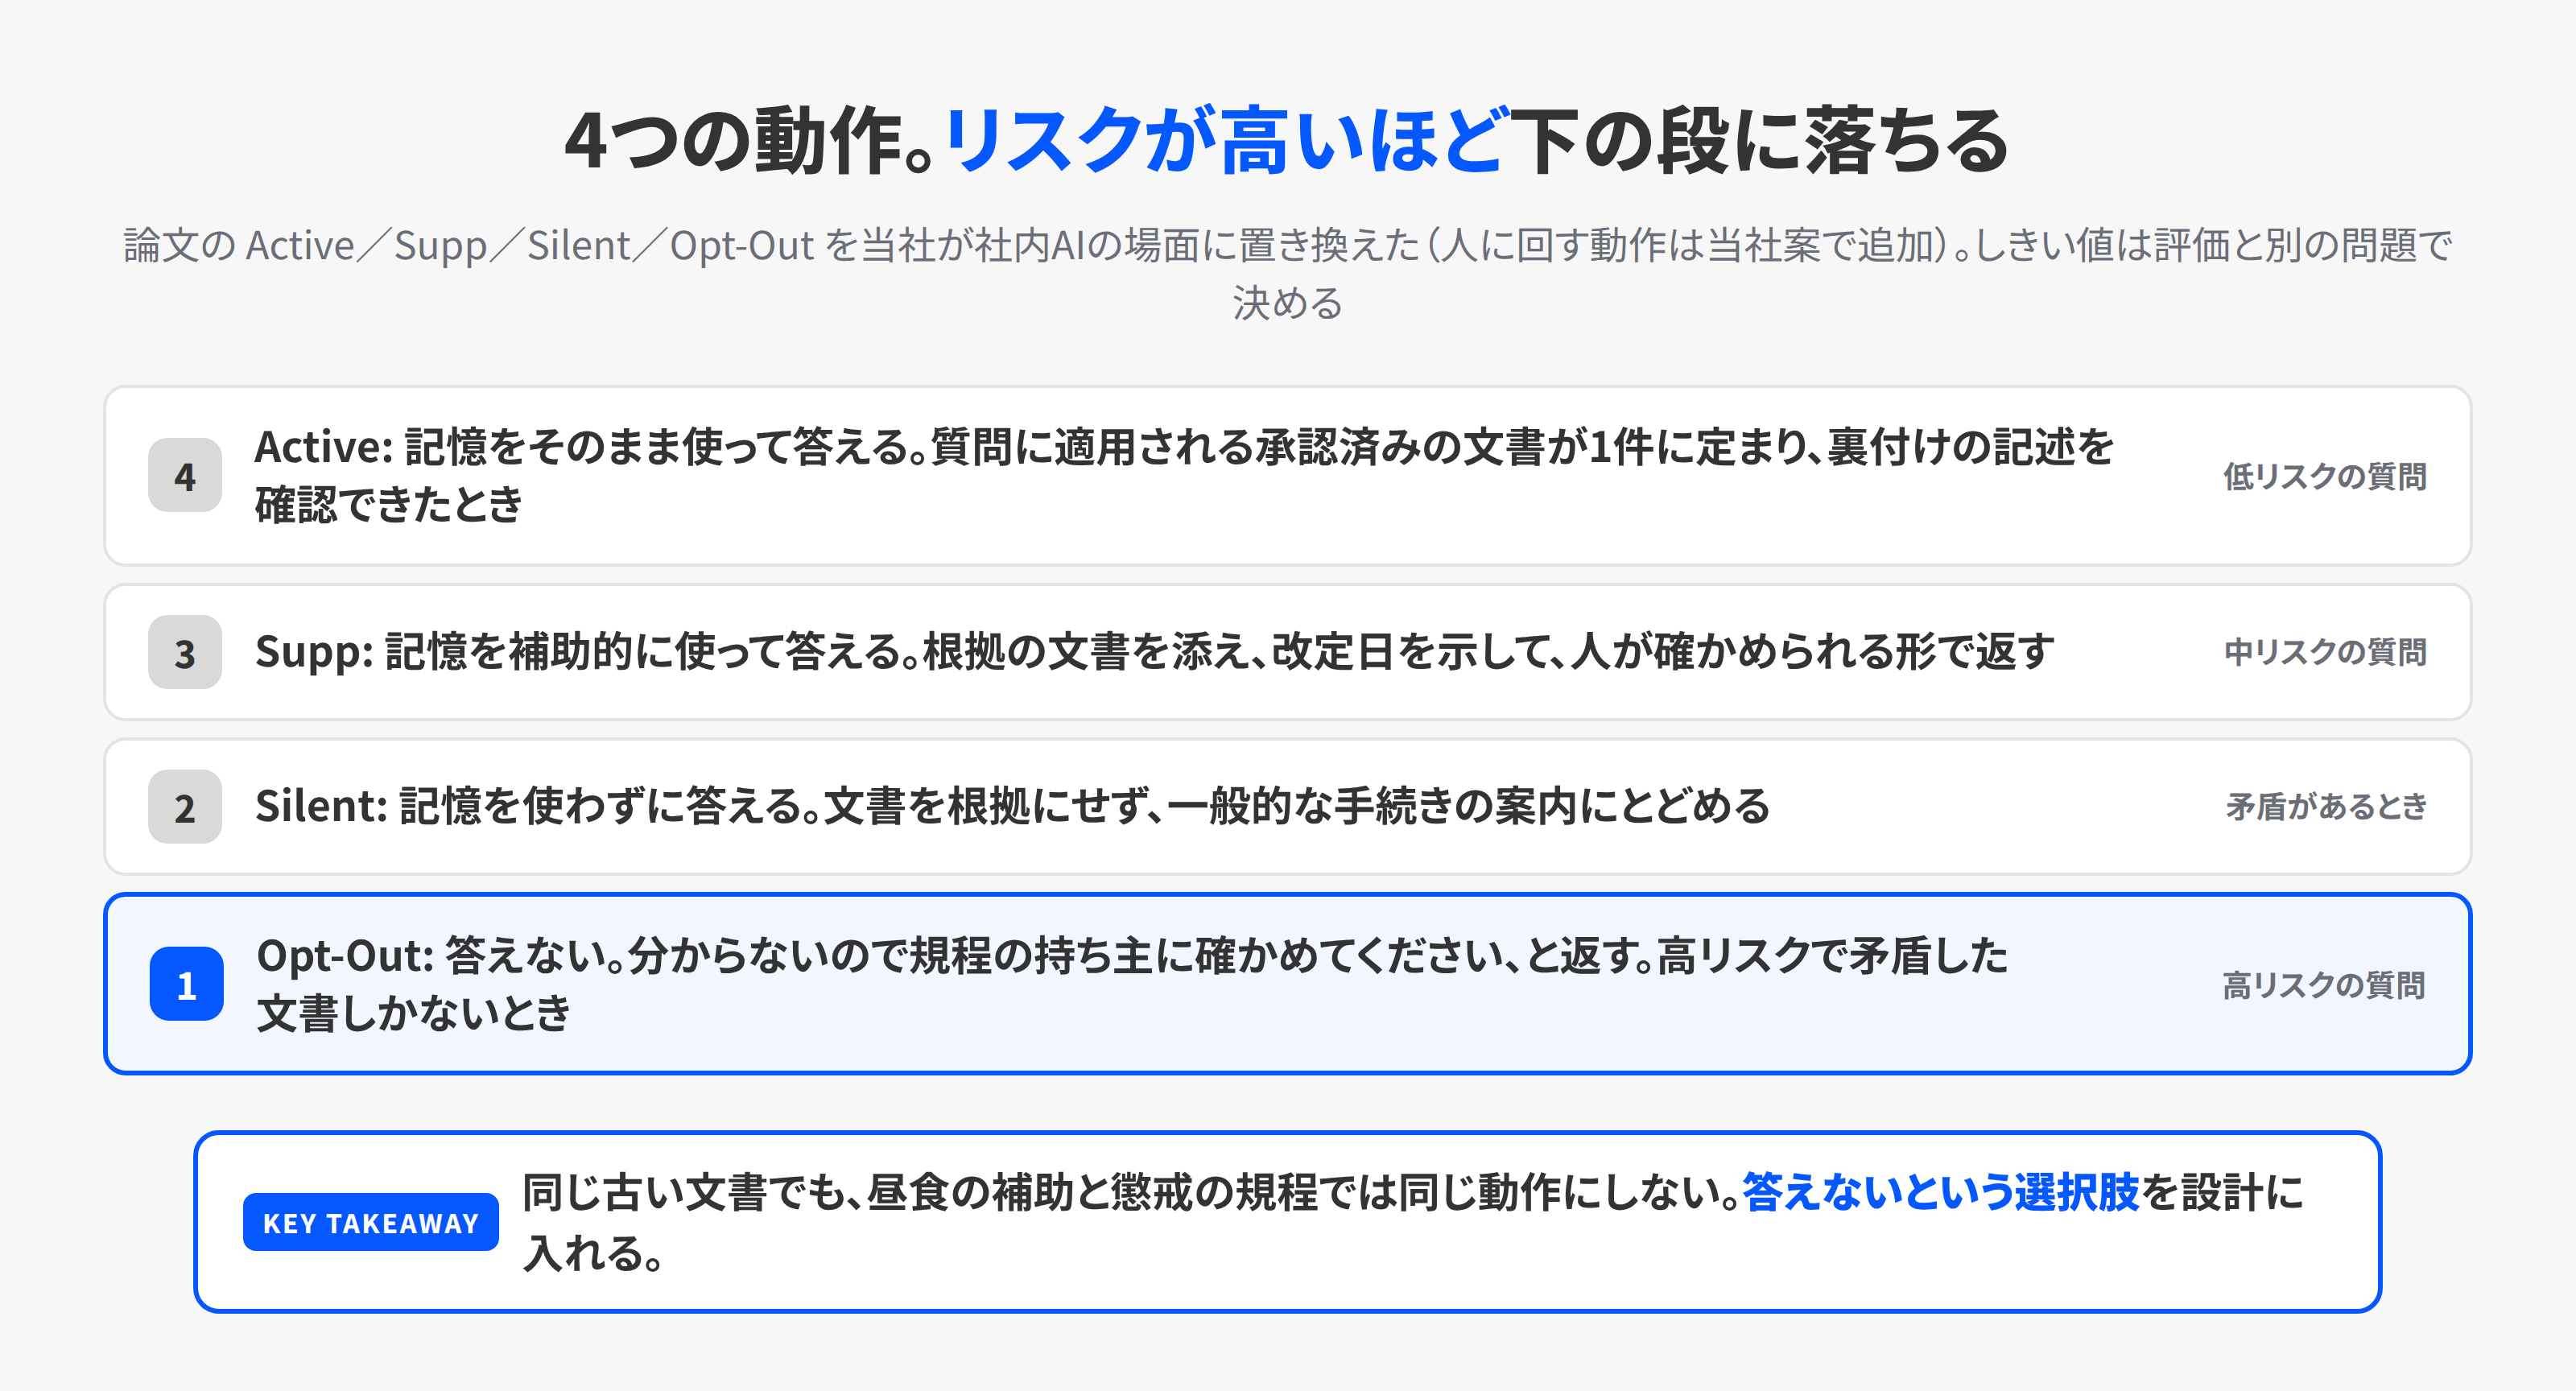
- Active: 記憶をそのまま使って答える
- Supp: 記憶を補助的に使って答える
- Silent: 記憶を使わずに答える
- Opt-Out: 答えない
しきい値は、評価に使う問題とは別の80問で、データセットごとに格子探索で決めています。当社もJevの確信度しきい値を、実際の記録からしきい値別の表を作って決めましたが、そのときは調整用と評価用の記録を分けるところまではしていません。分けて決める論文の進め方は、次にしきい値を見直すときに取り入れます。
4つの動作の中で、当社が注目したのはOpt-Out、答えないという選択肢が明示的にあることです。社内AIの多くは、何かしら答える設計になっています。
答えないという動作を設計に入れると、高リスクの質問で矛盾した記憶しかないとき、間違った金額を答える代わりに、分からないので規程の持ち主に確かめてください、と返せます。
論文の4つの動作に、人に引き継ぐ動作は含まれていません。この記事の後半で書く当社の設計例は、論文の4つを参考にして、人に回す動作を加えたものです。
リスクの反転を社内に置き換えると
同じ古い文書でも、昼食の補助を聞かれたときと、懲戒の規程を聞かれたときで、同じ動作にはしない。後者は、確信度が同じでも一段下の動作に落とす。質問の分類表が1枚あれば、この設計はできます。
論文の結果と、その限界
結果を、良い数字と、そうでない数字の両方を書きます。
良い数字。 gemma-4-E4B-itとTruthfulQAの組み合わせで、通常のRAGの構成の幻覚率53.0%に対して、判断の層を入れると23.3%でした。
要旨にある約56%の削減は、この相対的な減り方です。高リスクの質問に限ると、RAGの63.0%に対して0.0%でした。
別のモデルであるdeepseek-v4-flashでも、高リスクの質問では、RAGの10.7%に対して0.0%です。
ただし論文は、明示的に答えなかった場合を幻覚に数えていません。0.0%は、答えないを含む運用で、評価した高リスクの質問に幻覚が検出されなかったという意味で、全部に正しく答えたという意味ではありません。
判断にかかる時間は、語彙の処理を含めて1回あたり約0.14ミリ秒で、LLMに自己評価させる方法の2秒から4.7秒と比べて、桁が4つから5つ違います。
そうでない数字。 deepseek-v4-flashでは、全体の幻覚率は、RAGの4.3%に対して判断の層が4.7%で、勝っていません。
HaluEvalという別のベンチマークでも、全体では6.5%に対して7.0%です。つまり、判断の層の効果は、主に高リスクの質問で出ていて、全体を一様に良くするものではありません。
論文が書いている限界。 関連度が非常に高く、同時にリスクも高い場合、関連度が確信度を押し上げて、リスクによる抑制を打ち消すことがあります。
医療に関する117件の記録では、判断の正答率が55.6%まで下がりました。そして、記憶をそのまま使うActiveと判断した場合にも、8.0%の幻覚が残る。
論文はここから、検索の後の制御は、記憶の保存先を掃除する作業の代わりにはならない、と書いています。
当社が付け加える限界。 実験は、TruthfulQAとHaluEvalという一般的な質問応答のベンチマークで、社内文書ではありません。
サンプルは、deepseekで200問を3回、gemmaで150問を2回、geminiで30問を1回と、小さい。
幻覚の判定は、参照回答との埋め込みの類似度で行っていて、人が読んで判定したものではありません。信号の計算も語彙に基づく簡易なもので、論文自身が、学習による抽出や文書の断片ごとの判定を今後の課題に挙げています。
数字をそのまま社内AIに当てはめることはできません。当社がこの論文から持ち帰るのは、数字ではなく、設計の形です。
検索と生成の間に判断の段階を置くこと、その判断を3つの信号で作ること、確信の強さと向きを分けること、リスクで動作を変えること、答えない選択肢を持つこと。この5つは、実験の規模とは関係なく、社内AIの設計に使えます。
自社の社内AIに入れる形
論文の設計を、社内文書を読むAIにどう入れるか。当社の考えを書きます。論文を参考にした当社の設計例で、効果を測った実績はまだありません。
論文の信号の計算をそのまま置き換えるものではなく、関連度は検索に任せ、業務リスクは質問の分類で作り、文書の管理情報は採用の追加の条件として使います。
まず、AIの答えの根拠に出た文書を、1つの質問について並べてみます。出張の日当を聞いた質問で、根拠として取り出された文書が次の4件だったとします。
| 文書名 | 改定日 | 持ち主 | 日当の記述 |
|---|---|---|---|
| 旅費規程 | 2024/04/01 | 総務部 | 国内 3,000円 |
| 旅費規程(旧) | 2022/04/01 | 総務部 | 国内 2,500円 |
| 出張手続きの手引き | 2026/01/15 | 総務部 | 規程を参照 |
| 営業部の経費メモ | 不明 | 不明 | 国内 2,500円 |
この4件を見ると、3つのことが分かります。改定日が古い文書が混ざっている。同じ項目で金額が矛盾している。そして、持ち主が分からない文書がある。この表の列は、取り出した文書を採用してよいかを判断する条件の材料になります。
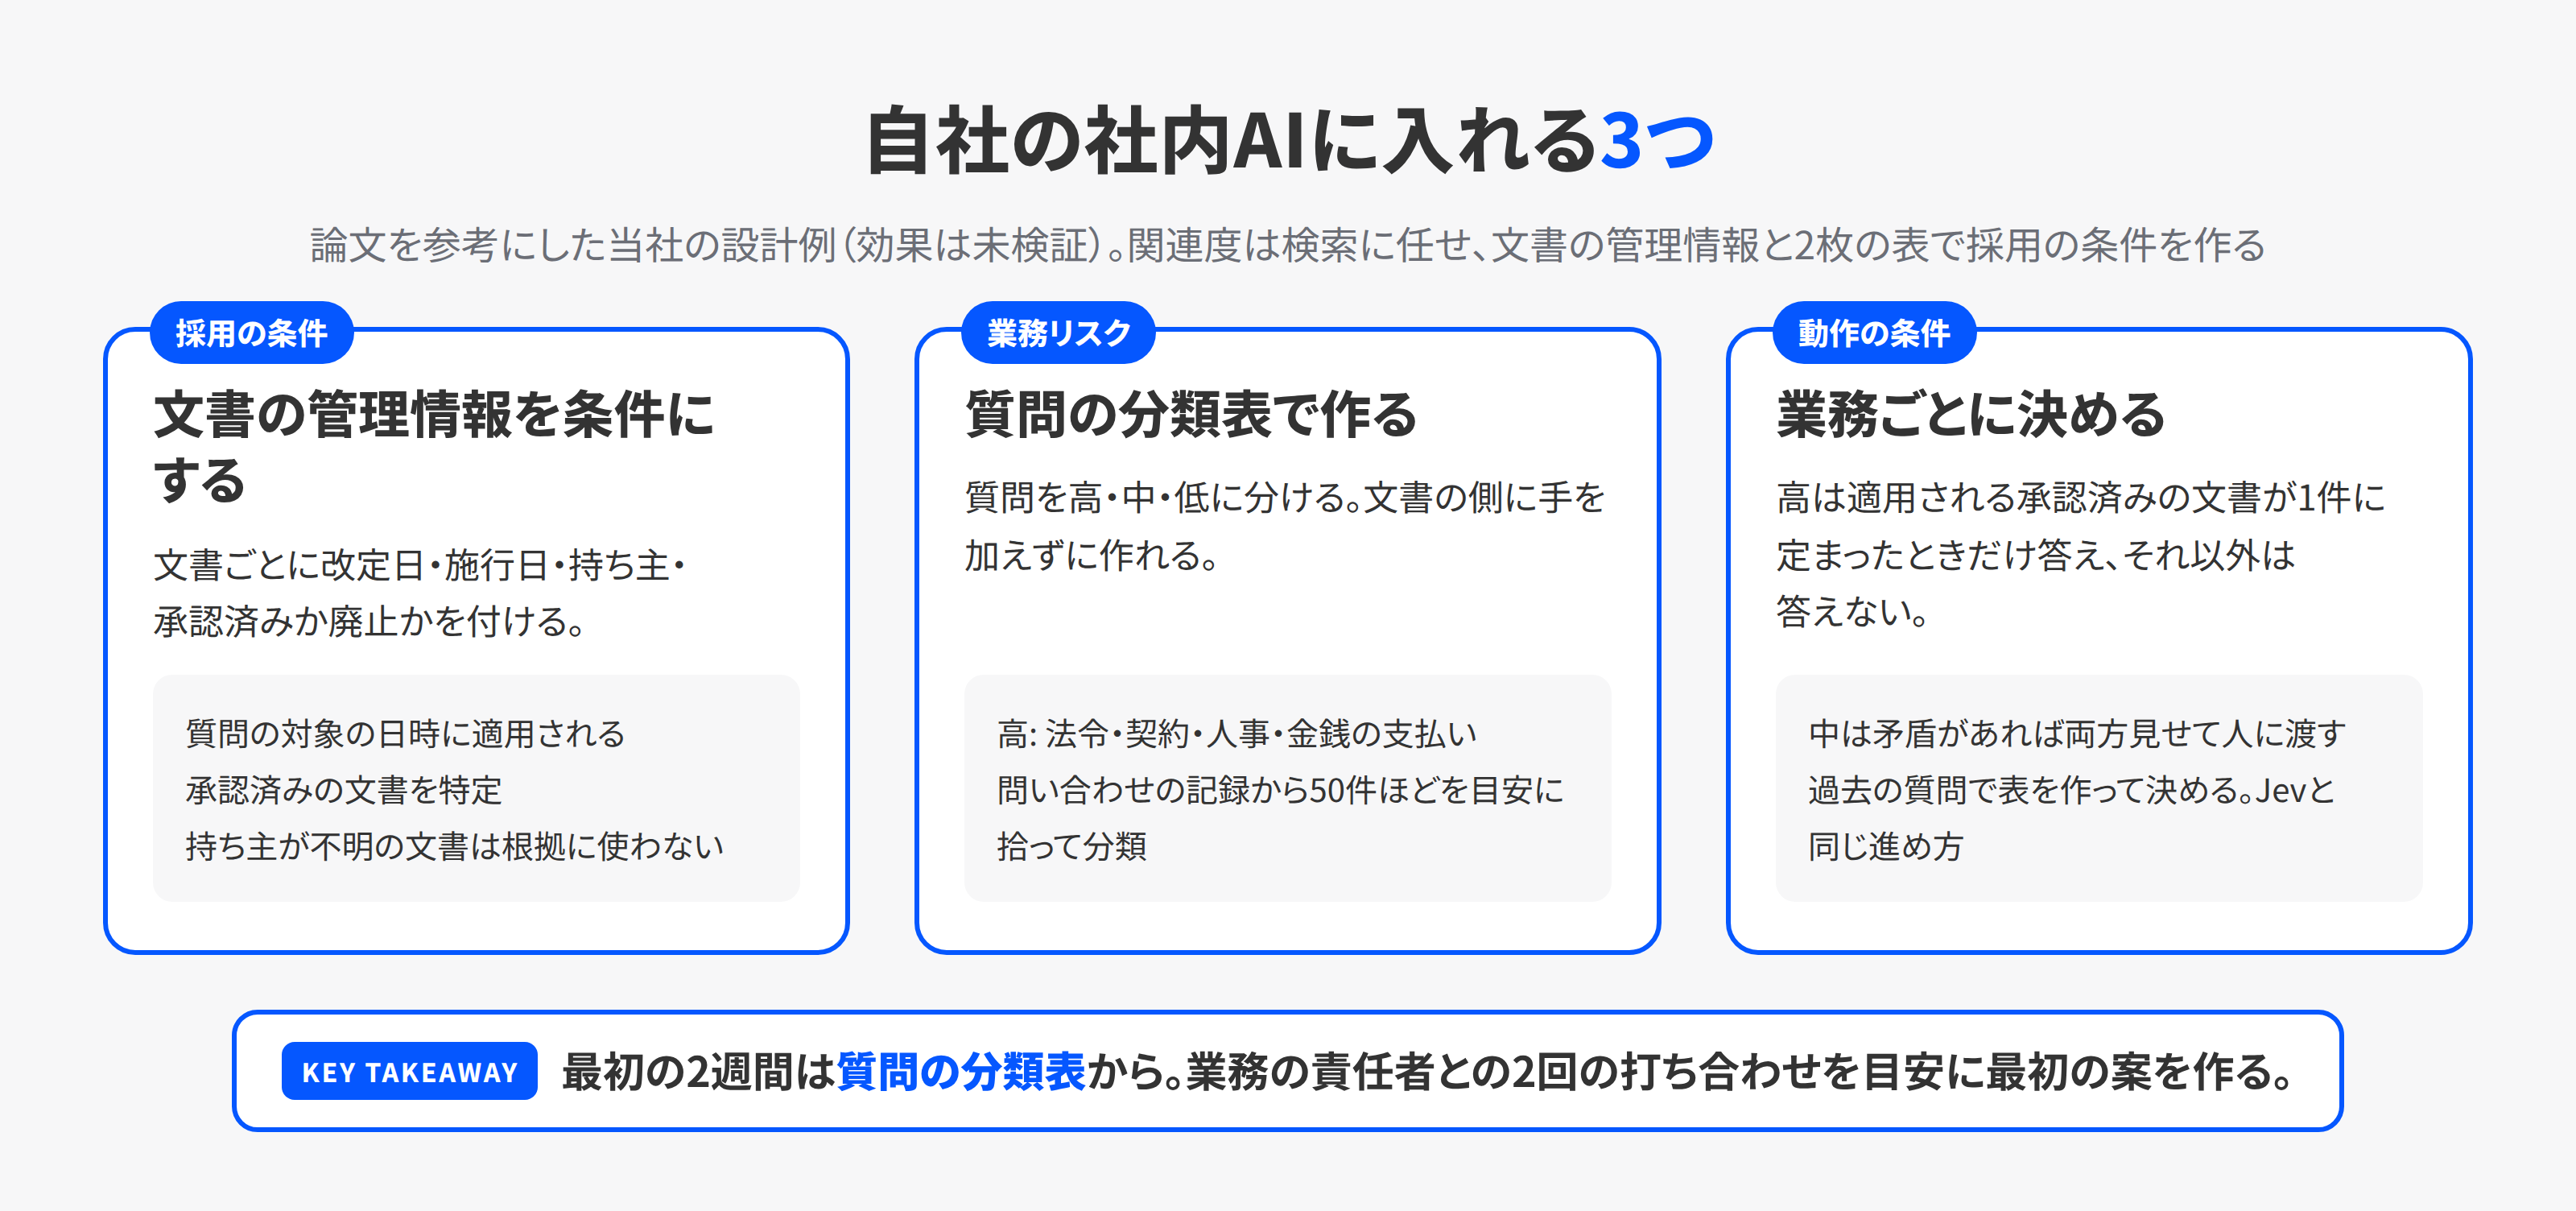
1. 文書の管理情報を、採用の条件にする。 文書ごとに、改定日、施行日、持ち主、承認済みか廃止かを付けます。同じ規程の名前で複数の文書が取り出されたら、質問の対象の日時と対象者に適用される承認済みの文書を特定し、それ以外を外す。
改定日が最新でも、施行前の文書や、過去の出張には適用されない文書があるので、改定日だけでは決めません。持ち主が不明の文書は、根拠に使わない。
これは論文の矛盾検出の計算そのものではなく、当社が独自に置く管理の規則です。語彙の解析と組み合わせるかどうかは、仕組みごとに決めます。
文書の管理情報の付け方は、Copilotを導入するときに行うべきデータと権限の整備に、正しいバージョン、更新する担当者、閲覧を認める人、保存先の4つとして書きました。
2. 質問の分類表で、業務リスクを作る。 質問を、高、中、低の3つに分ける表を作ります。高は、法令、契約、人事、金銭の支払いに関わる質問。
中は、社内の手続きの順序や申請先。低は、施設の場所や備品の使い方。この表は、文書の側に手を加えずに作れます。最初の案は、問い合わせの記録から質問を50件ほど拾って、業務の責任者と一緒に分類する、を目安にしています。分類できない質問や例外が残れば、件数を足します。
3. 動作の条件を、業務ごとに決める。 高リスクの質問は、質問の対象の日時に適用される承認済みの文書が1件に定まり、回答を裏付ける記述を確認できたときだけ答え、それ以外は、規程の持ち主に確かめるよう案内して答えない。
中リスクは、矛盾があれば根拠の文書を両方見せて人に判断を渡す。低リスクは、適用される最も新しい文書で答える。この3行が、動作の条件の表になります。数値のしきい値は、この条件の表を運用してから、記録をもとに足します。
当社は、判定専用モデルのJevで、確信度のしきい値を0.6と0.9の二段にしています。0.9以上は自動で進め、0.6未満は人に回し、間は先に処理して印を付け、週に1度まとめて確かめる。
決めるときは、公式の更新の分類の記録30件、うち確定した判定15件で、しきい値ごとの自動処理率と一致率の表を作りました。
この二段の基準は、問い合わせの振り分けにも使っています。社内AIの動作の条件も、同じ進め方で決められます。過去の質問と、そのときに根拠になった文書を並べ、どの条件なら間違った答えが外に出なかったかを数える。
判定専用モデルが2社から出たに書いたとおり、判断だけを返す仕組みは、文章を書く仕組みと分けて置くと、条件を後から調整しやすくなります。
最初の2週間でやること
3つのうち、2の質問の分類表から始めます。文書に手を加えず、問い合わせの記録から質問を拾って高・中・低に分けるだけなので、業務の責任者との2回の打ち合わせを目安に最初の案を作れます。表ができたら、高リスクの質問だけ、答える前に根拠の文書の施行日と承認の状態を人が確かめる運用を先に始めます。
文書の掃除と、判断の層の両方が要る
ここまで読むと、判断の層を入れれば古い文書を残しておいてもよい、と読めるかもしれません。当社はそうは考えていません。
論文自身が、記憶をそのまま使うと判断した場合にも8.0%の幻覚が残り、検索の後の制御は記憶の掃除の代わりにならない、と書いています。
文書の掃除は、間違いの元を減らします。判断の層は、残った元から間違いが外に出るのを防ぎます。前者をやらずに後者だけ入れると、矛盾の検出や根拠不足で答えない動作が増え、使われなくなるおそれがあります。
後者をやらずに前者だけやると、掃除の合間に改定された文書で、また間違いが出ます。
RAGは幻滅期、とGartner日本。社内文書検索の次の一手に、文書の側を整える4段を書きました。文書を減らす、大もとと持ち主を決める、聞かれた質問から整える、答えの採否を人に残す。
この記事の判断の層は、その4段目を仕組みにしたものです。4段目を人の運用で始め、質問の分類表としきい値が固まったら、仕組みに移す。この順番を当社は勧めます。
注意点
論文の数字を、自社の精度の見込みにしないでください。 実験は一般的な質問応答のベンチマークで、サンプルも小さく、全体の幻覚率ではRAGに勝っていない組み合わせもあります。持ち帰るのは設計の形です。
信頼度の計算を、最初から自動にしないでください。 論文の矛盾検出は語彙に基づく簡易なものです。社内文書では、改定日、施行日、持ち主、承認の状態を採用の条件にして矛盾を扱う方法を、当社は先に試します。
この管理情報が付いていない文書は、条件で判断できないので、根拠に使わない側に置きます。
答えない動作を、使えないという評価にしないでください。 高リスクの質問で、矛盾した文書しかないときに答えないのは、設計どおりの動作です。
答えない回数が多いときは、理由を記録して、矛盾、根拠の不足、リスクの設定、条件の厳しさのどれかに分類します。分類の結果を、文書の掃除と条件の見直しの優先順位に使います。
しきい値は、モデルや文書を変えたら測り直してください。 論文のしきい値は、データセットごとに決められています。自社の社内AIでも、生成AIのモデルを変えたとき、文書を大きく入れ替えたときは、過去の質問で表を作り直します。
確信度の高さを、正しさの根拠にしないでください。 改定前の規程を根拠にした答えは、確信度が高く出ます。自社の運用でも、AIが自信をもって答えた、は採用の理由になりません。
質問の対象に適用される承認済みの文書が特定でき、回答を裏付ける記述を確認できたことが、採用の理由です。
KOIYALの見解
社内AIが古い記憶で間違える問題を、当社は、AIの問題というより、判断の段階を置いていない設計の問題として見ています。
人が規程を調べるとき、古い規程と新しい規程の両方が出てきたら、改定日を見て新しいほうを使い、確信が持てなければ総務に聞きます。
この判断を、人は無意識にしています。社内AIには、この判断の段階がないまま、検索と生成が直結しています。
論文の価値は、この判断の段階を、学習なしの、人が追える計算で置けると示したことです。3つの信号、確信度と一貫性の分離、リスクの反転、答えない選択肢。
どれも、社内の言葉に置き換えて考えられます。施行日と承認の状態と持ち主、質問の分類表、業務ごとの動作の条件、持ち主に確かめてくださいという返答。
インハウス経営(AIを活用し、自社で業務を改善し、自社で仕組みをつくる経営)の観点で言えば、自社に残してほしいのは、判断の層のコードではなく、質問の分類表と動作の条件の表です。
どの質問が高リスクで、どの条件なら答えてよいか。これは、業務を知っている人にしか決められず、決めた表は、AIの仕組みを入れ替えても使い回せます。
仕組みを外部に作ってもらう場合でも、この2つの表は自社で作り、自社で更新してください。
自社でできるようになること
社内AIの答えを信じるかどうかの基準を、自社の言葉で表にすること。質問の分類表と、業務ごとの動作の条件の表。この2枚があれば、次に仕組みを変えるときも、何を守るべきかを自社で説明できます。
次の行動
- 根拠の文書を並べる。 社内AIが間違えた質問を1つ選び、そのときに根拠として取り出された文書を、文書名、改定日、持ち主、記述の4列で並べます。矛盾と、持ち主が不明の文書が見えます
- 質問を高・中・低に分ける。 問い合わせの記録から50件ほどを目安に拾い、法令・契約・人事・金銭に関わるものを高にします。業務の責任者との2回の打ち合わせを目安に最初の案を作ります
- 高リスクだけ、人の運用で始める。 高リスクの質問は、AIの答えを使う前に、根拠の文書の施行日と承認の状態と持ち主を人が確かめる。この運用で、答えないにすべき質問が見えてきます
3つを終えたら、動作の条件の表を作り、仕組みに移す段階です。文書のメタデータと質問の分類表を、いま動いている社内AIで一緒に作りたい会社は、FDE型支援の初回の打ち合わせで、間違えた質問の実例と根拠の文書をもとに進めます。
お問い合わせの本文に、社内AIが読んでいる文書のおおよその数と、間違えた質問の例を1つ書いていただければ、初回の前に当社で質問の分類表の叩き台を作ります。
参考
- An Interpretable Memory Decision Controller for LLM Agents Based on Three-Signal Complementarity: Decoupling Confidence and Consistency(arXiv 2609.22043・v1 2026年9月18日。確認日2026年11月16日)
- AIエージェントで約7人に1人が法令違反リスク。古いルールを参照させた代償とは(@IT・2026年10月13日。確認日2026年11月16日)
- 企業のGRCに関する実態調査 vol.4(データガバナンス)(KiteRa・2026年9月3日。確認日2026年11月16日)
- Jevで問い合わせを振り分ける。営業メールと本物の相談を確信度で実際に分けてみた(KOIYAL・2026年9月29日)
- RAGは幻滅期、とGartner日本。社内文書検索の次の一手(KOIYAL・2026年11月16日)
- Jevの確信度しきい値をどう決めるか。並行運用の記録から自動化率と精度の表を作る(KOIYAL・2026年9月26日)
- 判定専用モデルが2社から出た。Jevを回してきた当社の見方(KOIYAL・2026年10月26日)
- Copilotを導入するときに行うべきデータと権限の整備(KOIYAL・2026年10月27日)
- FDE型支援(KOIYAL)