

判断だけを返すAI、Jevを自社の週次処理に並走させた話を導入手順の記事に書きました。そこで、自動で進めるか人に回すかの線を確信度0.6に置き、この数字に根拠はまだない、と書きました。前回の記事で質問の書き方を固めたので、今回はその線を引きます。
この記事は、並走の記録30件から、しきい値ごとに「何件を自動で進められるか」と「自動で進めた分がどれだけ人の判定と合っていたか」の表を作り、当社がどこに線を引いたかの記録です。結論を先に書きます。
- 本人の確定判定がある15件では、しきい値をどこに置いても不一致がゼロでした。 精度でしきい値を選ぶ材料にはなりませんでした。差が出たのは自動処理率で、0.6なら30件中29件、0.9なら22件、0.99なら15件が自動で進みます
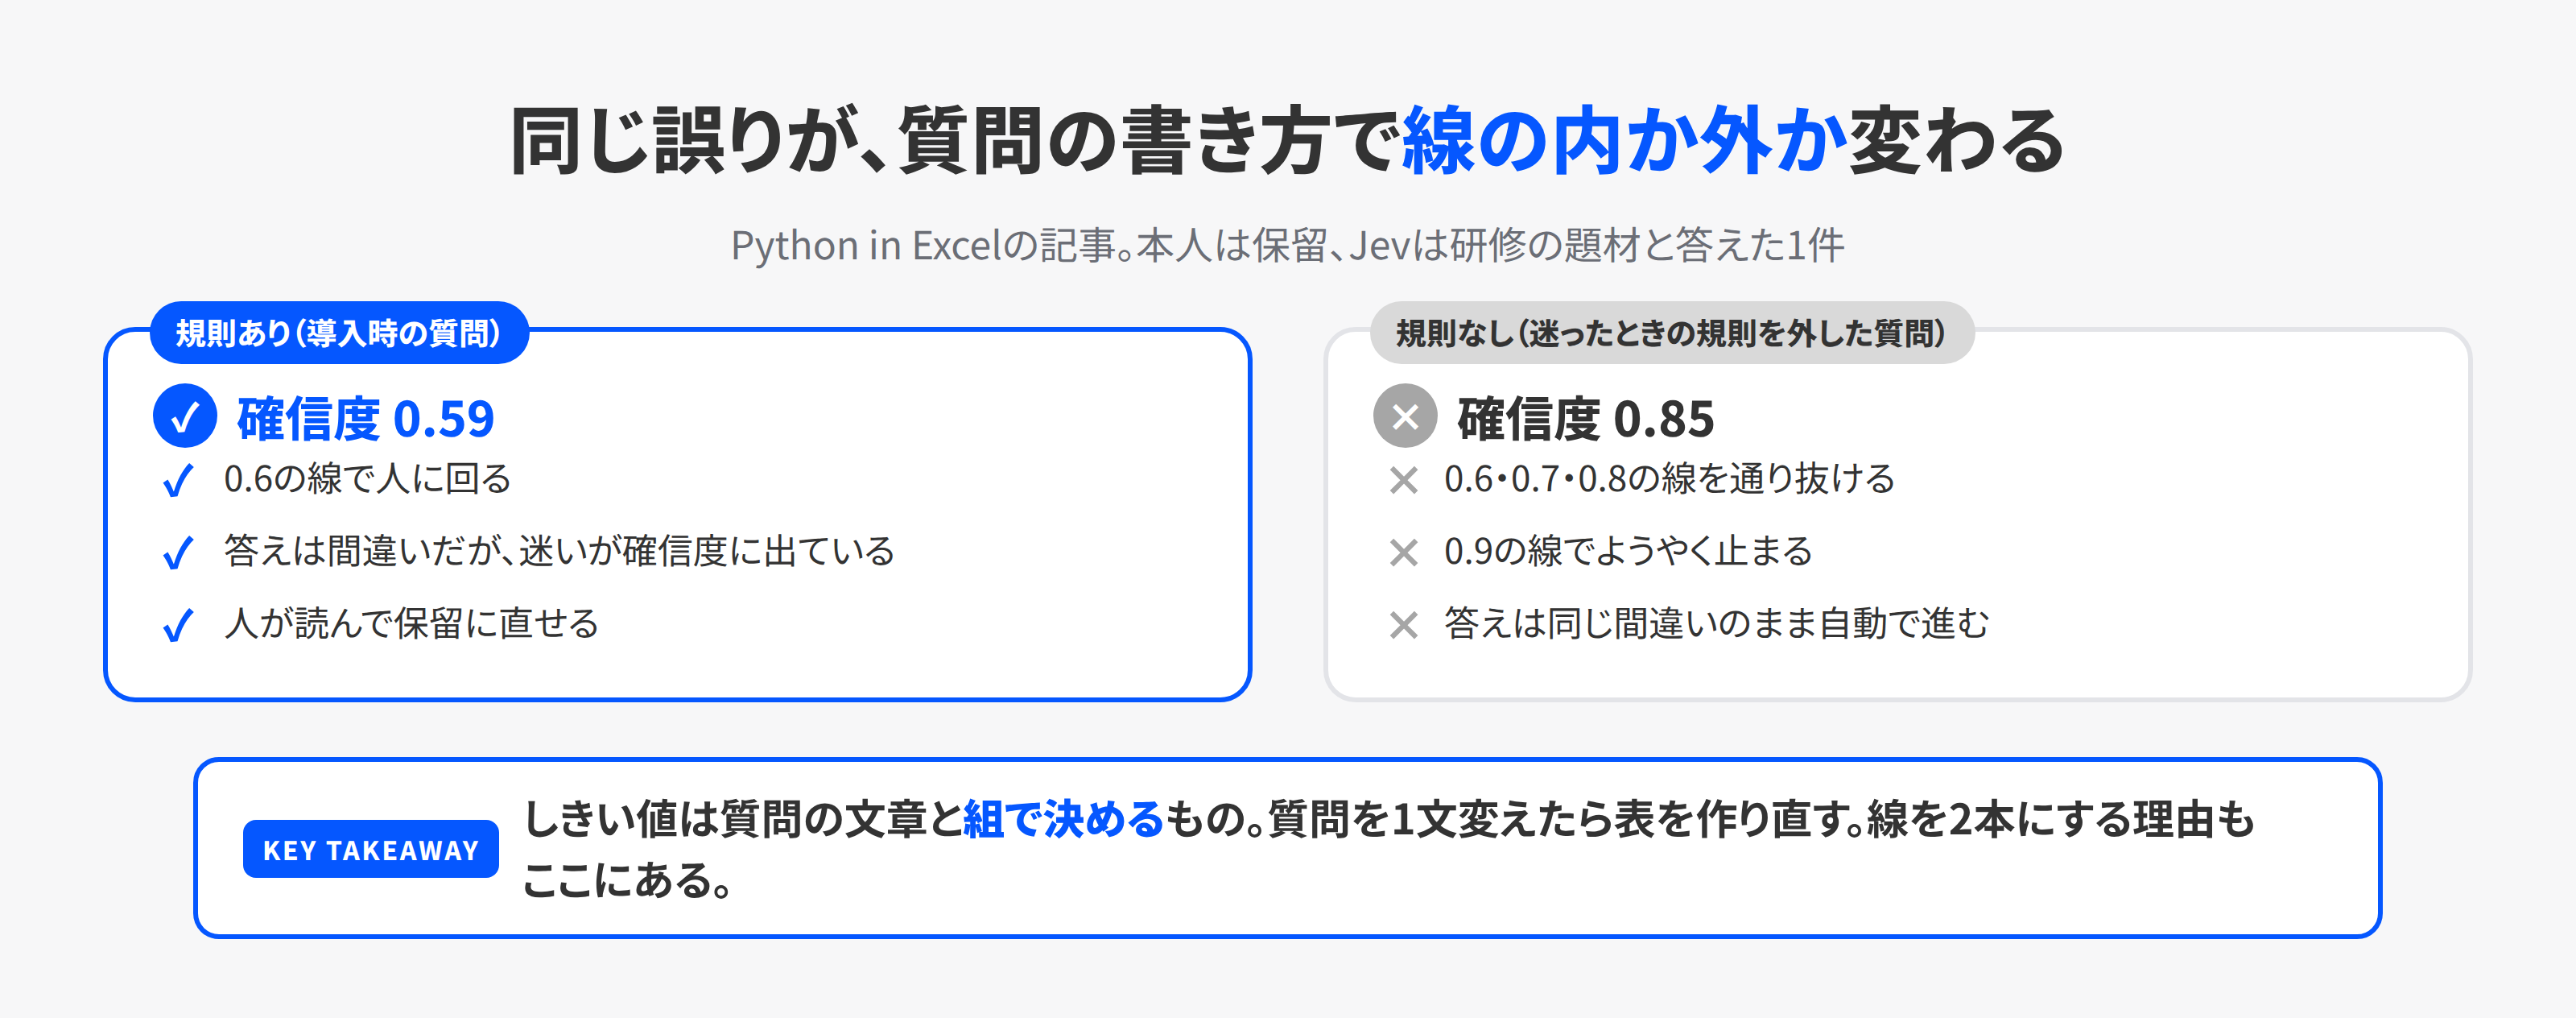
- 過去に1件だけあった誤りは、質問の書き方によって確信度0.59にも0.85にもなりました。 0.59なら0.6の線で人に回り、0.85なら0.9の線まで通り抜けます。しきい値は質問の文章とセットで決めるもので、質問を変えたら表を作り直す必要があります
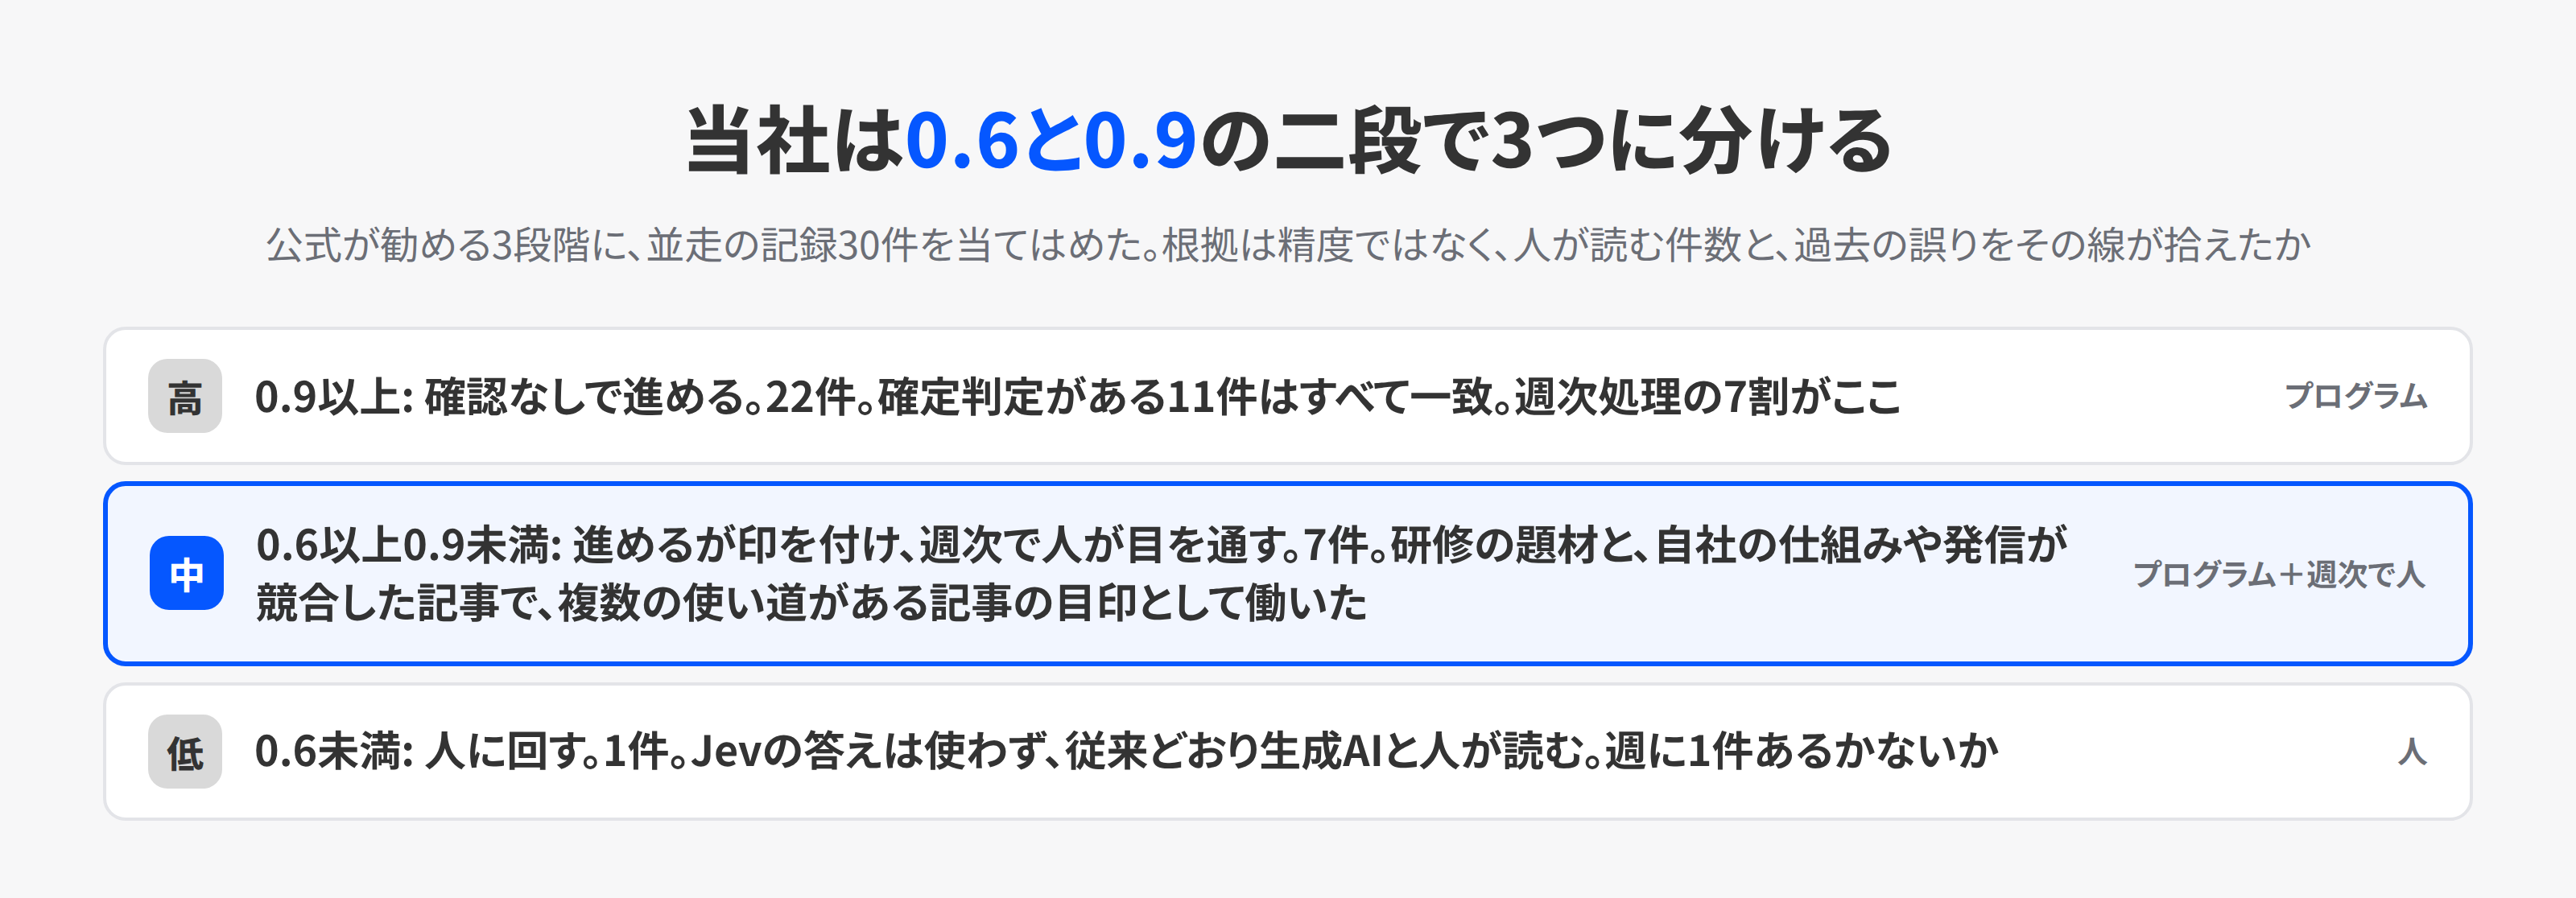
- 当社は0.6を「人に回す線」、0.9を「確認なしで進める線」にした二段構えにしました。 数字の根拠は精度ではなく、人が読む件数と、過去の誤りをその線が拾えたかどうかです
対象は30件、確定判定は15件で、傾向をつかむための記録です。精度を保証する数字ではありません(判定の実行日は2026年9月24日、モデルはjev-1.13.0、表の作成は9月25日)。
確信度とは何か。公式ドキュメントの勧め
先に、確信度(confidence)が何の数字かを整理します。
Jevは選択肢から1つ選ぶChoiceと、順序のある段階を答えるScoreで、答えと一緒に確信度を返します。公式ドキュメントによると、確信度は確率分布から計算した統計で、確率が1つの選択肢に全部乗っていれば1.0、選択肢の間で散るほど下がります。3択なら(3×最大の確率−1)÷2で近似できる、とあります。はい/いいえで答えるNoulは、確信度を持ちません。0から1の値そのものを見ます。
同じドキュメントは、確信度を3つの範囲に分けることを勧めています。高い範囲は自動で進める。中くらいの範囲は注意して進める(利用者に確認する、確認の印を付ける、情報を追加で集める)。低い範囲は動かない(人に回す、聞き返す、別の仕組みに落とす)。例のコードでは0.5を床にして、取り消しのきかない操作には0.9を使っています。
パターン集には、もう少し具体的な例があります。銀行の問い合わせ振り分けで、0.6未満は何であれ人へ、0.6から0.85は操作によって確認を挟み、0.85を超えたら送金承認のような操作も自動で進める、という三段です。残高照会は間違えても読み上げを聞き直すだけなので0.6でよく、送金承認は損失が大きいので高く置く。しきい値は1つではなく、操作ごとに、間違えたときの損失で決める、が公式の立場です。
もう1つ、公式の料理本に、しきい値を実データで決めた例があります。米国の年次報告書60件を75の業種に分類する課題で、確信度0.9を境にするとちょうど半分に割れ、確信側は30件中27件(90%)が正解、不確信側は30件中12件(40%)でした。不確信側を1段粗い区分で答え直すと、そちらは70%になった、と書かれています。確信度の高低で正答率がはっきり割れる、この形が理想です。
そして、公式ドキュメントは「保守的な値から始め、自分のデータで試して調整する」と書いています。当社の0.6はその「保守的な値」に当たります。ここから先が、自分のデータで試す部分です。
表の作り方。材料と列の決め方
材料は、前回の記事で使った30件です。Microsoft(9月7日・14日・17日号)とGoogle(9月1日・8日・15日・22日号)の公式更新の要約で、うち15件に本人の確定判定があります。内訳は研修の題材(training)が13件、発信のネタ(sns)が1件、保留(skip)が1件です。質問は、前回の実験で採用したv3(見送りの逃げ道としてlaterを足した4択、正確には5択)を使います。
表を作るスクリプトは決定論で、APIを呼びません。並走の記録ファイルを読み、しきい値ごとに件数を数えるだけです。列は5つにしました。
| 列 | 意味 |
|---|---|
| 自動処理 | 確信度がしきい値以上の件数と割合。人を挟まずに先へ進む分 |
| 人が読む | 残り。人が読んで判定し直す分 |
| 自動分の一致 | 自動処理側のうち確定判定がある件で、Jevの答えが人と一致した数 |
| 通った誤り | 自動処理側に残った不一致。人が拾えない誤り |
| 人側の一致 | 人が読む側のうち確定判定がある件で、Jevの答えが合っていた数。人に回さなくてもよかった件の目安 |
大事なのは4列目と5列目です。しきい値を上げると「通った誤り」は減りますが、「人側の一致」が増えます。つまり、合っている答えまで人が読み直すことになります。しきい値を決めるとは、この2つの損のどちらをどれだけ受け入れるかを決めることです。
一致の数え方は、前回と同じくlaterとskipを同じ扱いにしています。人の「保留」は4択の中ではskipに当たり、Jevのlaterはそれに対応させた選択肢だからです。
表。0.5から0.99まで
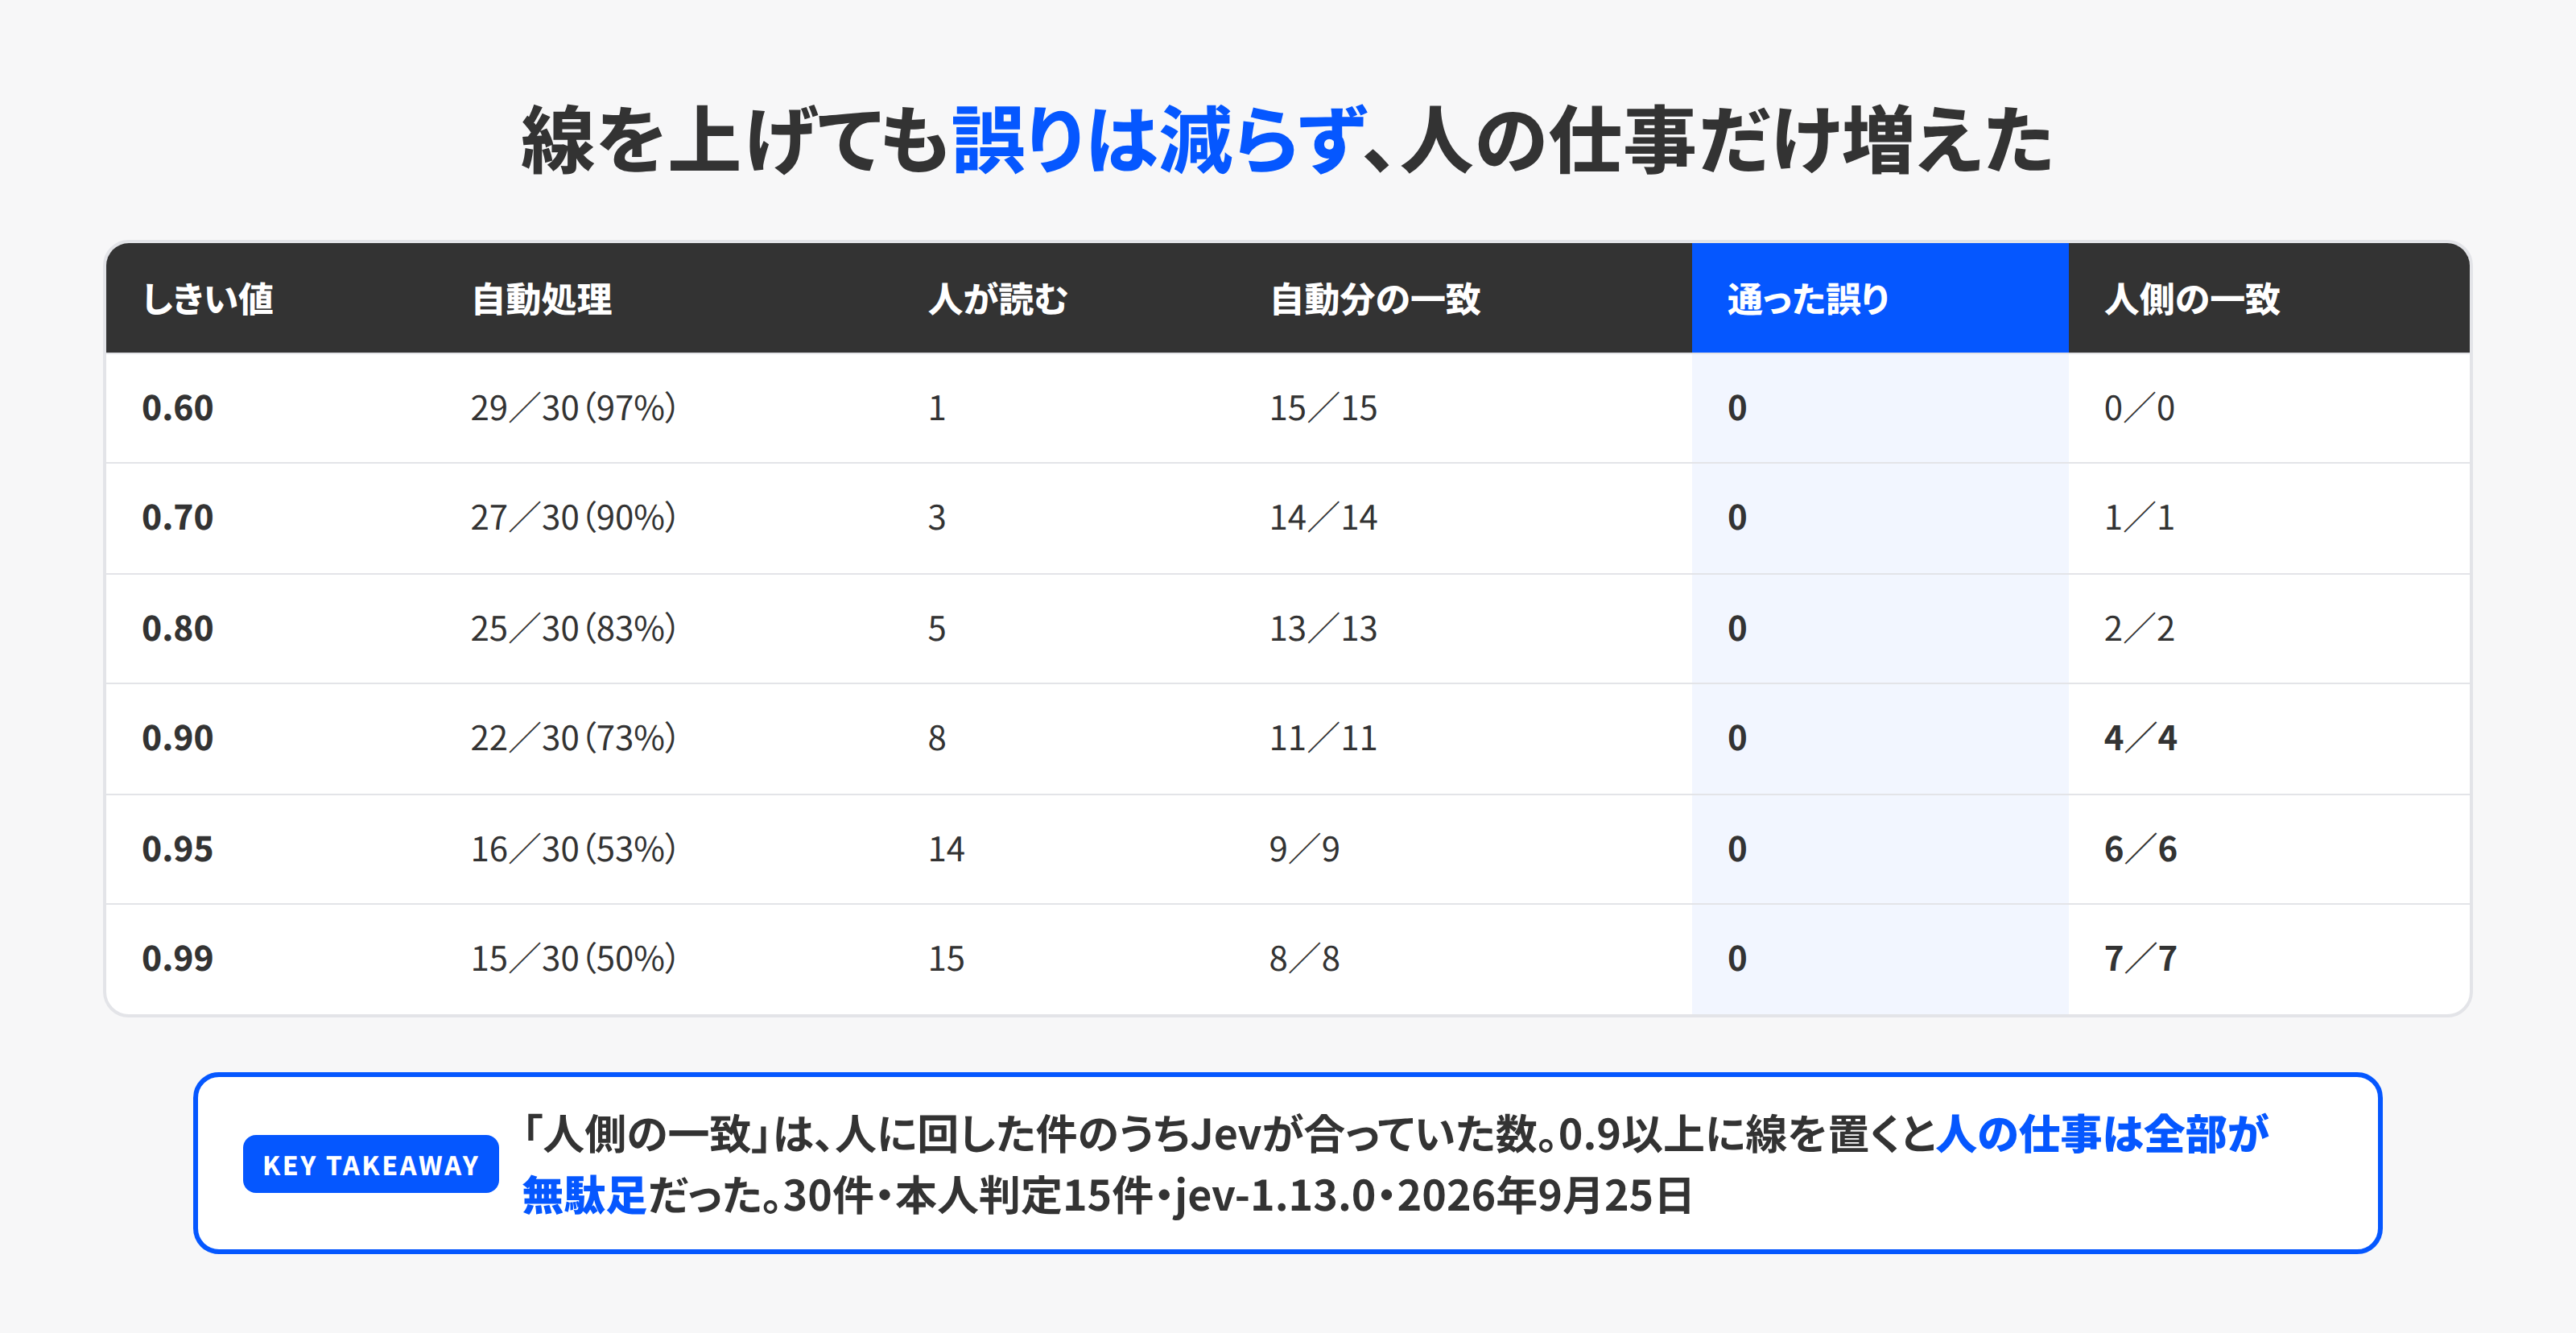
| しきい値 | 自動処理 | 人が読む | 自動分の一致 | 通った誤り | 人側の一致 |
|---|---|---|---|---|---|
| 0.50 | 30/30(100%) | 0 | 15/15 | 0 | 0/0 |
| 0.60 | 29/30(97%) | 1 | 15/15 | 0 | 0/0 |
| 0.70 | 27/30(90%) | 3 | 14/14 | 0 | 1/1 |
| 0.80 | 25/30(83%) | 5 | 13/13 | 0 | 2/2 |
| 0.90 | 22/30(73%) | 8 | 11/11 | 0 | 4/4 |
| 0.95 | 16/30(53%) | 14 | 9/9 | 0 | 6/6 |
| 0.99 | 15/30(50%) | 15 | 8/8 | 0 | 7/7 |
確信度の分布は、最小0.53、中央値0.98、最大1.00です。30件のうち22件が0.9以上に集まり、0.6から0.9未満が7件、0.6未満が1件です。
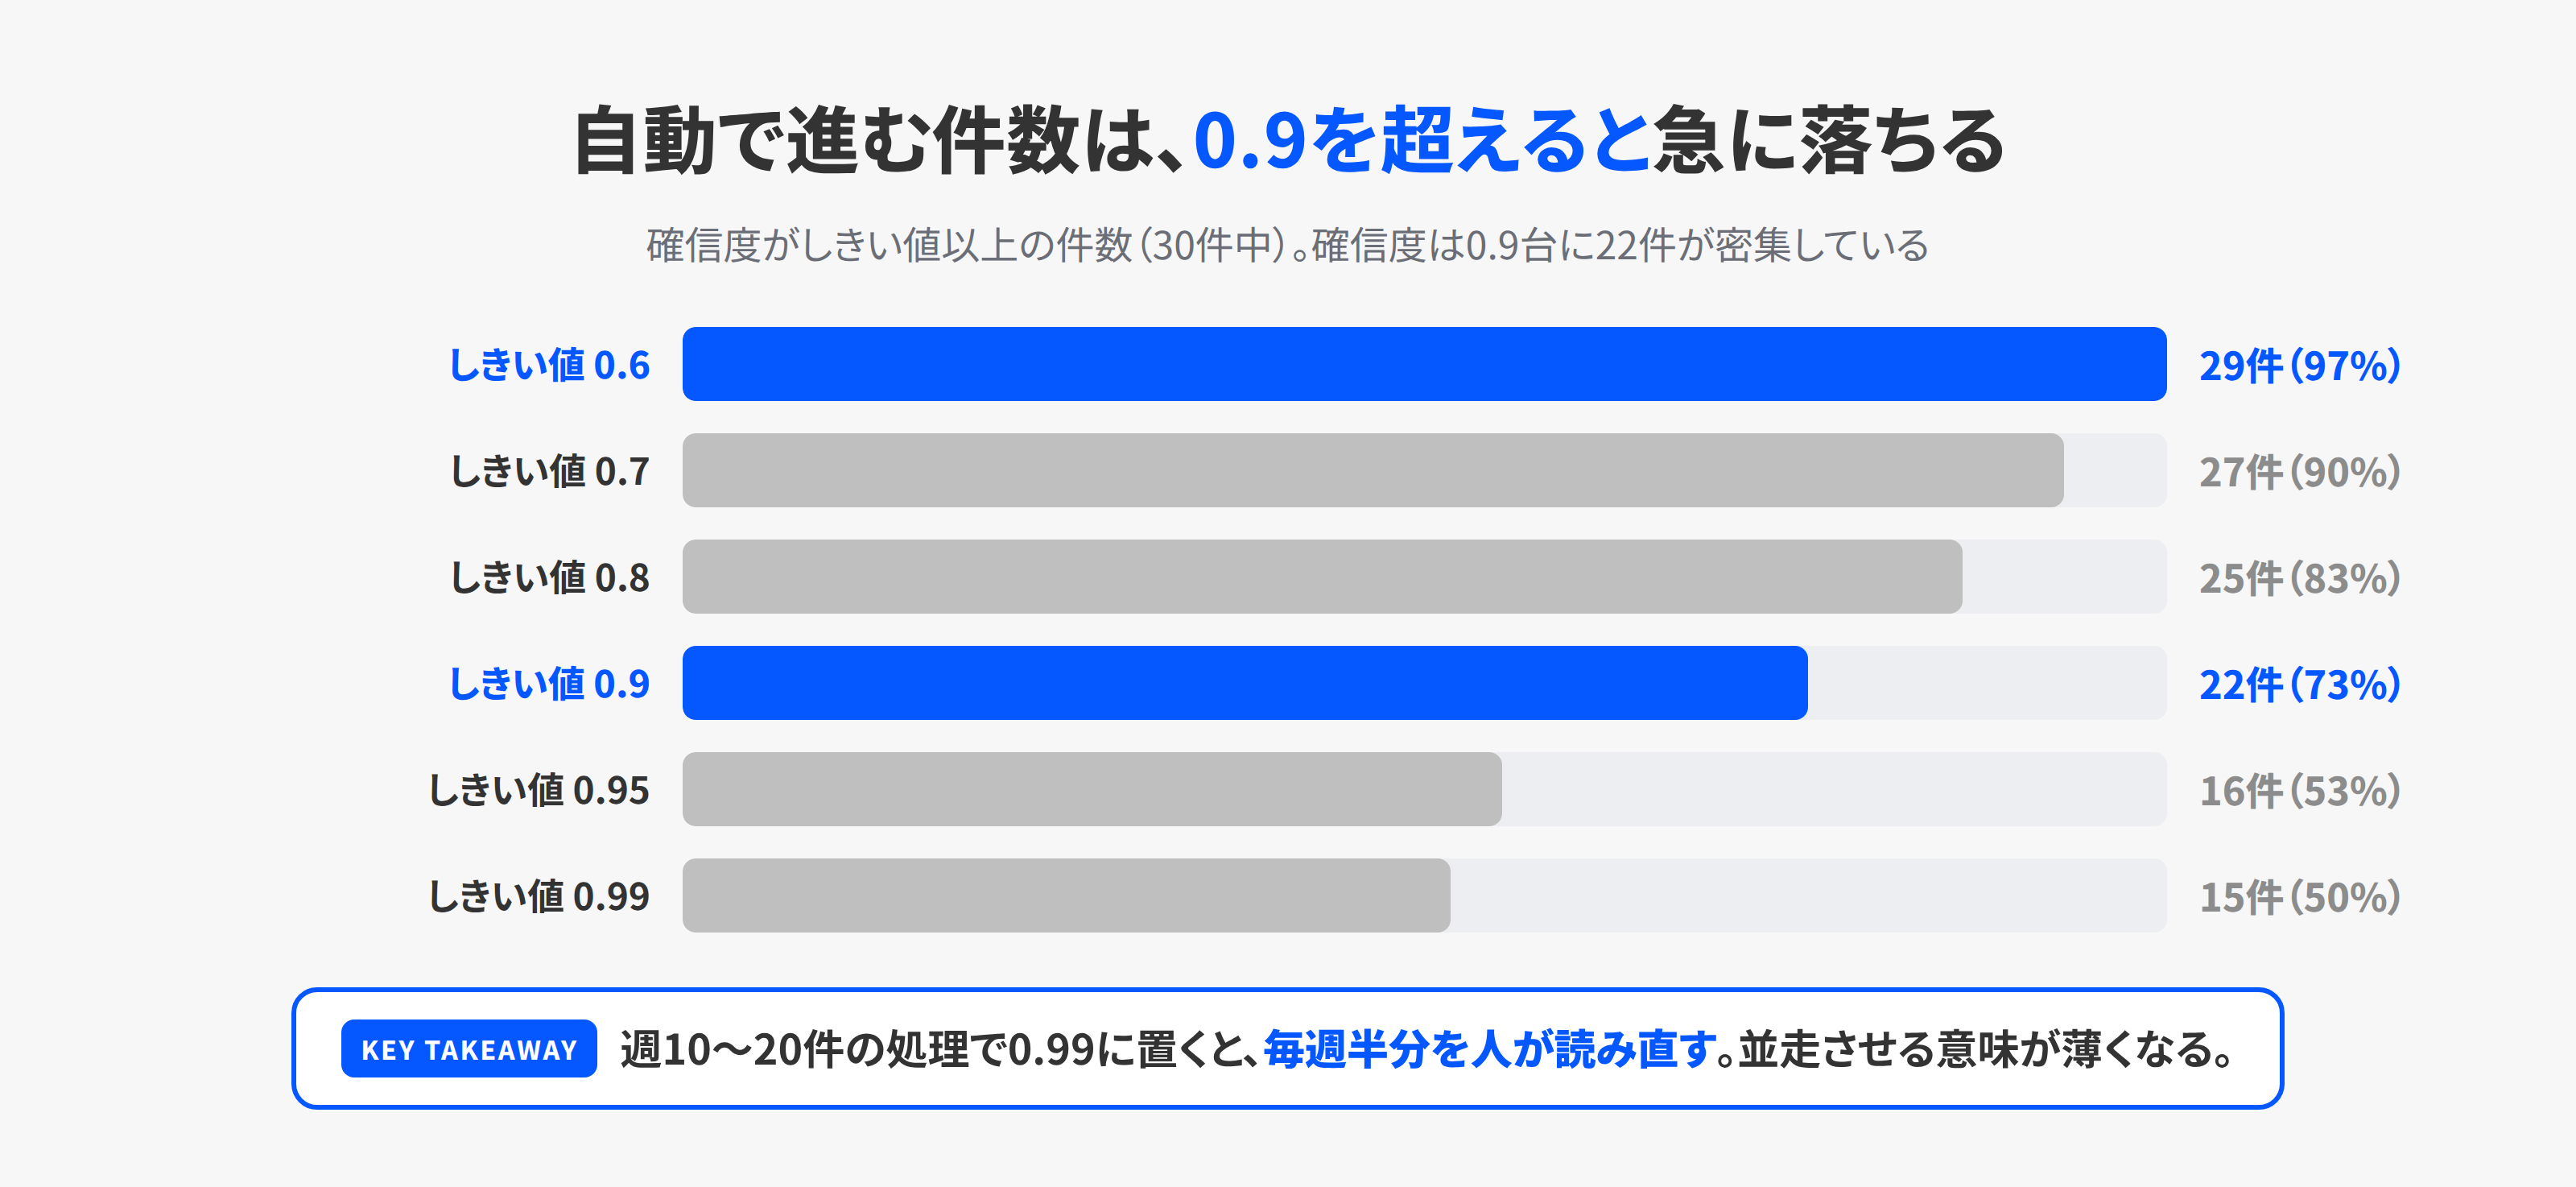
読み方を3つに分けます。
自動処理率は、0.9を超えると急に落ちます。 0.6から0.8までは30件中29件から25件で、人が読む件は1件から5件です。0.9で8件、0.95で14件、0.99で15件になります。確信度が0.9台に密集しているので、0.9より上に線を引くと、その密集した部分を人に回すことになります。当社の週次処理は週に10件から20件なので、0.99に置くと毎週半分を人が読み直す計算です。それなら並走させる意味が薄くなります。
通った誤りは、どこに線を引いてもゼロでした。 これは良い知らせのように見えますが、後で書くとおり、しきい値を決める材料としては物足りない結果です。
人側の一致は、0.7から増え始めます。 0.9で4件、0.99で7件です。人に回した件が全部、Jevの答えで合っていた。つまり、線を上げて増えた人の仕事は、今のところ全部が無駄足でした。
不一致がゼロ、の意味。一致率は弱い物差し
15件で不一致ゼロ、という結果を、そのまま「精度100%」と読んではいけません。理由が2つあります。
1つ目は、確定判定の偏りです。15件のうち13件が研修の題材です。何も考えずに全部を研修の題材と答える仕組みでも、15件中13件、87%が一致します。当社の週次処理は公式更新の要約を読む仕事なので、大半が研修の題材になるのは当然で、一致率という物差しがもともと甘い課題です。
2つ目は、誤りの件数です。しきい値を決めるとき本当に見たいのは、誤りが確信度の低い側に集まっているか、です。公式の料理本の例では、60件を確信度で半分に割ると正答率が90%と40%に割れました。誤りが21件あったから、その分かれ方が見えたわけです。当社の30件では、v3の質問で誤りがゼロなので、確信度の高低と正答率の関係を確かめようがありません。
だから、この表から言えるのは「今の質問と今の30件では、どのしきい値でも誤りは通っていない。差が出るのは人が読む件数だけ」までです。精度でしきい値を選べる段階ではありません。判断が難しい課題(問い合わせの振り分けや、書類の適否のように、選択肢の間で本当に迷う件が多いもの)なら、同じ表の作り方で確信度と正答率の関係が見えてくるはずで、それは次の記事で試します。
唯一の誤りは、質問の書き方で0.59にも0.85にもなった
材料が薄い中で、しきい値の置き方について一番はっきりした手がかりになったのは、前回の実験で見えていた1件の誤りです。
Python in Excelの上級者向けの技を紹介する記事を、本人は今の受講者には重いとして保留にしました。Jevは研修の題材と答えました。この1件の確信度が、質問の書き方によってどう動いたかを、同じ表で見ます。
| 質問の書き方 | この記事の答えと確信度 | 0.6の線 | 0.8の線 | 0.9の線 |
|---|---|---|---|---|
| v1 導入時の質問(規則あり) | 研修の題材・0.59 | 人に回る | 人に回る | 人に回る |
| v4 迷ったときの規則を外した質問 | 研修の題材・0.85 | 通り抜ける | 通り抜ける | 人に回る |
| v3 逃げ道laterを足した質問(現行) | later・0.62(一致) | 自動で進む | 人に回る | 人に回る |
導入時の質問では、誤りの確信度は0.59でした。0.6の線がぎりぎりで拾い、人が読む側に来ます。ところが、複数に当てはまるときの規則を外した質問では、同じ誤りの確信度が0.85に上がりました。0.6でも0.7でも0.8でも通り抜け、0.9でようやく止まります。答えは同じ間違いなのに、線に引っかかるかどうかが質問の文章で変わったわけです。
ここから言えることは2つです。
しきい値は、質問の文章と組で決めるものです。 0.6という数字が良いか悪いかは、それ単体では決まりません。今の質問の下で、誤りがどの確信度に出るか、で決まります。質問を1文でも変えたら、表を作り直して線を引き直す。当社では、質問を変える提案が出たら、前回のような全件の再判定と、今回の表の再生成を1セットで行う決まりにしました。どちらも1円未満で1分以内に終わります。
線を1本にすると、質問の変化に弱くなります。 0.6の1本だけだと、上の例のように誤りが0.85に動いた瞬間に通り抜けます。0.9にもう1本引いておけば、そこで止まります。ただし0.9の1本だけにすると、今度は人が読む件が8件に増える。だから当社は2本にしました。
当社の置き方。0.6と0.9の二段
今の当社の並走では、確信度で3つに分けています。
| 範囲 | 扱い | 30件のうち | 内容 |
|---|---|---|---|
| 0.6未満 | 人に回す。Jevの答えは使わず、従来どおり生成AIと人が読む | 1件 | 新学期向けのGemini活用まとめ(0.53) |
| 0.6以上0.9未満 | Jevの答えで先に進めるが、週次のレビューで人が目を通す印を付ける | 7件 | SharePointクラシック機能の廃止(0.68)・カレンダーの外部会議連携(0.78)・Office LTSC 2021の終了(0.78)・移行インポート(0.83)・外部ツール接続(0.88)・Workspace Studioの追加機能(0.89)・Python in Excel(later 0.62) |
| 0.9以上 | 確認なしで進める | 22件 | 残り。確定判定がある11件はすべて一致 |
0.6と0.9の2本にした理由を、精度以外の3つで書きます。
1つ目、人が読む件数です。 0.6未満は30件中1件、週に換算して1件あるかないかです。0.6から0.9未満の7件は、自動で分類しつつ印を付けて週次で見返す扱いなので、読み直しではなく確認です。週次のレビューは元からあるので、追加の手間は印の付いた記事を先に見る、程度です。
2つ目、過去の誤りをその線が拾えたかです。 唯一の誤りは、質問の書き方によって0.59と0.85に出ました。0.6と0.9の2本なら、どちらの書き方でも人の目に触れる側に入ります。
3つ目、真ん中の7件の顔ぶれです。 確率の内訳を見ると、7件はどれも研修の題材と、自社の仕組み(self)か発信(sns)が競合していました。SharePointクラシック機能の廃止は研修0.74に対して発信0.22、Office LTSCの終了は研修0.82に対して自社0.10、外部ツール接続は研修0.91に対して自社0.09です。実際、この7件は当社の実務でも「研修の題材にも、記事のネタにもなる」記事でした。Office LTSCの終了は本人の判定も「研修反映と発信の両方」です。真ん中の範囲は、誤りを拾う場所というより、複数の使い道がある記事に印を付ける場所として働いています。これは意図していなかった効果で、真ん中の範囲を残す理由になりました。
しきい値は質問ごとに変える
当社の並走では、1回の呼び出しで3つの質問を同時に聞いています。4択(正確には5択)のChoice、大企業向けかどうかのNoul、急ぎ度の3段階のScoreです。しきい値の決め方は、質問の型と、間違えたときの損失で変えています。
Choiceは確信度で分けます。 上に書いたとおり0.6と0.9です。間違えたときの損失は、記事の置き場所が1週間ずれることで、翌週の週次レビューで直せます。だから低めでよい。
Noulは確信度を持たないので、0.5からの距離で分けます。 大企業向けかどうかは0から1の値で返り、0.5に近いほど迷っています。当社のラッパーは、0.5からの距離を2倍してChoiceと同じ線(0.6)と比べています。値にすると0.2以上0.8以下が「迷い」の扱いです。この質問は分類ではなく並べ替えの材料なので、誤りの損失はさらに小さく、線が広めでも困りません。
Scoreは確信度で分け、期待値は並べ替えに使います。 急ぎ度は0(急がない)・1(今月中)・2(今週中)の3段階で、答えは1.56のような期待値と、Choiceと同じ形の確信度です。振り分けは確信度で、線もChoiceと同じです。期待値のほうは、週次のレビューで記事を並べる順番に使っています。段階の間に落ちる値は2つの段階で迷っていることを示すので、期待値だけを見て「今週中」と断定しない、という使い方です。
これから作る問い合わせの振り分けでは、線を高くする予定です。営業メールを本物の相談と取り違えても損は小さいですが、本物の相談を営業メールとして捨てると、その1件が失注です。取り返しのつかない側の誤りに合わせて、自動で捨てる側の線を0.9より上に置き、迷った件は全部人が読む形から始めます。公式パターンの「操作ごとに別のしきい値」を、そのまま当てはめる形です。
版を固定して、変えたら測り直す
もう1つ、公式ドキュメントに明記されている注意があります。モデル名の別名(jev-latest)は、新版が出ると自動で新しい版に移ります。公式は「特定の版に対してしきい値を調整したなら、別名ではなくその版のIDを固定する」と書いています。
確信度の分布は、版が変わると動き得ます。今回の表は、jev-1.13.0という版の上で、v3という質問の上で成り立つ数字です。どちらかが変われば作り直しです。当社は、導入手順の記事の時点で既定のモデル名を版の番号に固定していて、新版が出たら次の手順で移ります。
- 新版を別名ではなく版の番号で指定し、同じ30件(その時点までに増えた並走の記録も含む)を再判定する
- 表を再生成し、旧版と並べる。見るのは、確信度の中央値、0.6と0.9で分けたときの件数、確定判定との不一致の位置
- 不一致の位置が線の内側(人が読む側)にあれば、線はそのまま新版へ移す。外側に出ていれば、質問か線を直してから移す
この手順は、モデルの版だけでなく、質問を変えたとき、判定の対象が変わったとき(たとえばMicrosoftとGoogleに加えてAnthropicの更新を読ませ始めたとき)にも同じです。
表を作る手順。自社でやるなら
当社の手順を、そのまま使える形に一般化します。前提は、導入手順の記事の並走まで済んでいることです。
- 並走の記録に、人の確定判定を残す。 Jevの答えと確信度だけ記録しても、表は作れません。人がその件をどう判定したかを、同じ記録か対応づけられる場所に残します。当社は週次のネタ帳に「判定(確定)」の行を書き、見出しで対応づけています
- しきい値を刻んで、5つの列を数える。 0.5から0.99まで、自動処理の件数、人が読む件数、自動処理側の一致、通った誤り、人側の一致。決定論のスクリプトで、APIは呼ばなくてよい
- まず「通った誤り」の列を見る。 ゼロでない最小のしきい値が、その質問での下限です。全部ゼロなら、当社と同じく精度では決められない段階なので、誤りの件数が貯まるまで保守的な線を続けます
- 次に「人側の一致」の列を見る。 線を上げて増えた人の仕事のうち、無駄足だった件数です。ここが週の処理件数に対して許せる範囲を超える手前が上限です
- 過去の誤りが、線のどちら側にいたかを確かめる。 質問の書き方を変えた版があれば、同じ誤りが確信度いくつに出たかを並べる。線を2本にするかどうかは、ここで決まります
- 線を決めたら、版と質問を固定して記録する。 表と一緒に、モデルの版、質問の全文、材料の件数と期間を残します。どれかが変わったら1から
3で「精度では決められない」と分かるのは、手戻りではありません。その質問がその業務で迷っていない、という結果です。当社の週次処理はそうでした。迷っていない判断は、低めの線で自動に流して、人の時間を迷っている判断のほうに使う。それが表を作って分かることです。
費用と時間
表の生成はAPIを呼ばないので、費用はかかりません。判定そのものは前回の実験の120回で、入力が1件あたり平均869から1,016トークン、合計で0.005ドル、1円未満でした。表を作り直すたびに全件を再判定しても、この費用です。
時間は、30件の再判定が1分以内(1件0.5秒前後)、表の生成が1秒未満です。しきい値の見直しを月に1回やっても、人の作業は表を読む10分だけです。
次にやること
当社の並走は、0.6と0.9の二段のまま続けます。週次のレビューで、確定判定との一致率と、真ん中の範囲に入った記事の顔ぶれを見ます。誤りが出たら、その確信度がどこにいたかを表に足します。
次の記事では、同じ表の作り方を、判断がもっと難しい課題に当てます。自社サイトの問い合わせフォームに来た実データを、営業メール、本物の相談、研修の相談、推進支援の相談の4つに振り分ける課題です。営業メールが大半を占める中で、本物の相談を取りこぼさない線をどこに置くか。こちらは誤りが出るはずなので、確信度と正答率の関係が見えると考えています。
自社の判断をJevに渡そうとしている方は、しきい値を1つの数字として探さないでください。今の質問の下で、誤りがどの確信度に出るかを表にして、人が読む件数と見比べる。それが線を引く作業です。数字は、質問を変えたら変わります。