
2026年9月15日にTypeSafe AIがJevを公開してから、1か月以内に同じ型のモデルが2社から発表されました。10月1日にCloudflareがClefを、10月9日にMicrosoftがMicrosoft-Decision-1を発表しています。どちらも、文章を書かず、あらかじめ決めた選択肢に確率だけを返す判定専用モデルです。
当社は9月からJevを自社の週次処理に組み込み、導入手順、質問の書き方、しきい値の決め方、問い合わせの振り分けを記事にしてきました。その続きとして、この記事では3つのモデルを並べ、同じ15件をJevとClefに渡した実測を示し、当社がどこに寄せることにしたかを書きます。読者は、自社の判定をAIに渡そうとしている担当者と、提供元を決める立場の情報システムの担当者です。
結論を先に書きます。
- 3つは同じ型で、Jev向けに書いた質問はClefにそのまま通りました。 状況と質問を渡し、選択肢ごとの確率と確信度が返る。Cloudflareは「Jev-API互換」を明記していて、当社の質問はJSONを1文字も変えずにClefで動きました。Microsoft-Decision-1は同じ考え方のモデルですが、Jevとの互換は発表に書かれておらず、当社は未検証です
- 同じ15件で、JevとClefの答えは人の判定とほぼ同じでした。ただし確信度の出方が違います。 Jevは15件中14件、Clefは判定できた14件中14件が人と一致しました。Jevの記録は9月の質問の版で、Clefには現在の版を送ったという条件の違いがあるので、差を提供元だけのせいにはできません。それでも、Jevが0.99と答えた件にClefは0.59を付けます。Jevで決めた0.6と0.9のしきい値をそのままClefに適用すると、確認なしで進む件はゼロになります。線は提供元ごとに取り直すものです
- 当社はCloudflareに寄せます。理由は精度ではなく管理です。 口座がすでに自社のサイトと同じ、重みが公開されていて将来は自前で動かせる、価格が明示されている。契約と鍵を1つ減らせます。2週間JevとClefを並行して動かし、一致率が同等以上ならClefをデフォルトにします。Microsoft-Decision-1は、契約を増やさないので当面は公開情報で見ます
数字は、Jevが2026年9月24日、Clefが10月13日の当社の実行記録と、各社の発表(確認日2026年10月20日)によります。対象は人の確定判定がある15件で、内訳は研修の題材13件、発信1件、見送り1件です。
判定専用モデルとは何か。1か月で何が変わったか
判定専用モデルの説明はJevとは何かに書いたので、ここでは要点だけ繰り返します。渡すのは、判断の材料になる状況(問い合わせの本文、記事の要約、申請書の内容)と、答えの形を決めた質問です。質問の形は3つで、選択肢から1つ選ぶChoice、順序のある段階を答えるScore、真偽の確率を返すNoulです。返ってくるのは文章ではなく、選択肢ごとの確率と、どれだけ迷ったかを示す確信度です。文章を1文字ずつ生成しないので、速く、安く、答えが選択肢の外に出ません。
9月の時点では、この型のモデルはJevだけでした。10月に状況が変わりました。
Cloudflare Clef(2026年10月1日)。 Birthday Weekの発表で、ClefとClef-flashの2つが出ました。Clefは中国Alibabaが公開しているQwen3.8-27Bを土台に、重みを固定したまま追加の層を学習させたモデルで、Clef-flashは同じ作りでQwen3.5-9Bが土台です。重みはHugging FaceにApache 2.0で公開され、Cloudflareの推論基盤Workers AIでも動きます。発表は「fully Jev-API compatible」と書いていて、Jevの呼び出し先とモデル名を変えるだけで移せる設計です。文脈は1回の呼び出しで64kトークン、画像は1回に4枚まで渡せます。価格は入力100万トークンあたり0.24ドル、出力は無料です。10月9日の続報で、Clef-flashは0.09ドルから0.038ドルに値下げされ、代わりにWorkers AI上の文脈が24kに縮みました。音声と動画を受け取るClef-omniも同じ日に出ています。
Microsoft-Decision-1(2026年10月9日)。 Microsoftが「decision-scoring model」として出したもので、Qwen3.5-9Bを土台に追加学習したモデルです。入力は決められた選択肢の組で、出力は選択肢ごとの較正された確率です。はい・いいえ、多肢選択、段階評価に加えて、採点基準に沿ってAIの回答やエージェントの行動を採点する用途を挙げています。Microsoft FoundryとOpenRouterで提供され、価格は入力100万トークンあたり0.042ドル、出力は無料です。Jevと同じ価格です。発表では、36のベンチマークで最高精度、GPT-6 Solより35倍速い、選択肢の言い換えや並べ替えで答えが変わらない、という数字が並びます。Jevとの互換については、発表に記述がありません。
Jev側の動き。 TypeSafe AIは10月14日にJev 1.14を出しました。価格は1.13と同じで入力100万トークンあたり0.042ドル、出力無料。文脈は1回の呼び出しで64k、1つの質問あたり32kです。入力は文字だけで、画像は受け取りません。別名のjev-latestは10月20日時点で1.13.0を指していて、当社の記録もすべて1.13.0です。
3つを並べます。価格と文脈は各社の公開情報、速さと一致率は当社の実測です。
| Jev(TypeSafe AI) | Clef(Cloudflare) | Microsoft-Decision-1 | |
|---|---|---|---|
| 発表 | 2026年9月15日 | 2026年10月1日 | 2026年10月9日 |
| 土台 | 非公開 | Qwen3.8-27B(Clef-flashはQwen3.5-9B) | Qwen3.5-9B |
| 提供 | TypeSafe AIのAPI | Workers AI。重みはHugging FaceでApache 2.0 | Microsoft Foundry・OpenRouter |
| 質問の型 | Choice・Score・Noul | 同じ。Jev-API互換と明記 | はい・いいえ、多肢選択、段階評価、採点基準 |
| 入力 | 文字 | 文字・JSON・画像4枚まで | 文字 |
| 文脈 | 64k(1質問あたり32k) | 64k(Clef-flashのWorkers AI版は24k) | 発表に記述なし |
| 価格(入力100万トークン) | 0.042ドル・出力無料 | 0.24ドル(Clef-flashは0.038ドル)・出力無料 | 0.042ドル・出力無料 |
| 自前で動かせるか | 不可 | 可。Clefは85GB、Clef-flashは41GBのGPUメモリが目安 | 不可 |
| 当社の実測の速さ(中央値) | 493ミリ秒 | 585ミリ秒 | 未計測 |
| 当社の実測の一致 | 14/15 | 14/14 | 未計測 |
表の読み方を2つ補います。速さは当社が新潟から呼び出した往復の時間で、Cloudflareが発表に載せた中央値209ミリ秒とは測り方が違います。自前で動かす目安のGPUメモリは、The RegisterがCloudflareの担当者の談話として報じた数字で、同時実行1、文脈64kの前提です。当社の手元にあるGPUは24GBなので、Clefは載りません。Clef-flashを量子化して載せる余地はありますが、試していません。
自社の実測。同じ15件をJevとClefに渡した
当社は週に1回、MicrosoftとGoogleの公式更新を読んで、研修の題材にするか、自社の運用に取り込むか、発信のネタにするか、見送るかを決めています。この4択(迷ったときの逃げ道laterを入れて5択)をJevに並行して判定させてきたのが、質問の書き方の記事としきい値の記事で使った判定です。
10月13日に、その中から人の確定判定がある15件を、同じ材料でClefに渡しました。質問は、当社が今Jevに毎週送っている質問のJSONを、1文字も変えずに送っています。Clefの呼び出し先はWorkers AIで、モデルはclefです。
条件の違いを1つ先に書きます。Jev側の数字は9月24日の実験の記録で、そのときの質問は導入時の版(4択で、複数に当てはまるときの規則つき)です。Clefに送ったのは現在の版(見送りの逃げ道laterを足した5択に、大企業向けかどうかと急ぎ度の2問を加えた3問)です。同じ記事を、違う版の質問で判定した比較なので、確信度の差を提供元だけのせいにはできません。同じ版で測り直すのは、次の節に書く2週間の比較運用で行います。
結果の要約です。
| 判定者 | 人と一致 | Jevと一致 | 速さの中央値 | 入力トークン合計 | 費用 |
|---|---|---|---|---|---|
| Jev(jev-1.13.0・9月24日の記録・導入時の質問) | 14/15 | 同一 | 493ミリ秒 | 13,893 | 契約による |
| Clef(Workers AI・10月13日・現在の質問) | 14/14 | 13/14 | 585ミリ秒 | 11,141 | 0.0027ドル |
Clefの分母が14なのは、1件がWorkers AI側の呼び出し制限(HTTP 429)で判定できなかったからです。Clef-flashは同じ日に15件全部がHTTP 422(リクエストの内容が受け付けられない)で判定できず、表から外しました。こちらは呼び出し側のリクエストの形を直してから測り直します。
1件ずつ並べます。確信度は、Choiceの答えに付いてくる0から1の値です。
| 公式更新の題 | 人 | Jev | Clef |
|---|---|---|---|
| Gemini in Workspaceのカスタム指示の対応アプリ拡大 | 研修 | 研修(1.00) | 研修(0.69) |
| Workspace StudioにDrive・Gmail・Chatの新ステップ | 研修 | 研修(0.99) | エラー |
| Gemini Notebookの監査ログが管理コンソールに追加 | 研修 | 研修(0.99) | 研修(0.59) |
| Google Picsの画像生成がDocs・Slidesに内蔵 | 研修 | 研修(1.00) | 研修(0.74) |
| Google Vidsで文書・PDF・Wordを動画要約に | 研修 | 研修(0.98) | 研修(0.66) |
| GeminiデスクトップアプリがWindowsに | 研修 | 研修(0.99) | 研修(0.71) |
| どのアプリからでもWorkspace横断で資料作成・予定登録 | 研修 | 研修(0.99) | 研修(0.80) |
| 初期設定時にMicrosoftからチームとデータを移行 | 発信 | 発信(0.86) | 発信(0.32) |
| Gemini Enterpriseに状況に応じたアクセス制御 | 研修 | 研修(0.99) | 研修(0.78) |
| Gemini Notebookの外部共有を管理コンソールで管理 | 研修 | 研修(0.99) | 研修(0.64) |
| Gemini in Workspaceが外部ツールに接続 | 研修 | 研修(0.86) | 研修(0.69) |
| Workspace Studioにカスタム開始条件・外部連携・Webhook | 研修 | 研修(0.93) | 研修(0.40) |
| SharePointのAIページ作成 | 研修 | 研修(0.98) | 研修(0.40) |
| Python in Excelの上級者向けの技 | 見送り | 研修(0.59) | later(0.16) |
| Office LTSC 2021のサポート終了まで1か月 | 研修 | 研修(0.84) | 研修(0.17) |
答えの列を見ると、2つはほとんど同じ判断をしています。唯一の違いは14件目で、本人が見送りにした記事をJevは導入時の質問で研修の題材と答えました(これがしきい値の記事で書いた唯一の誤りで、同じ記事に現在の版の質問を送るとJevもlaterと答えます)。Clefは現在の版の質問でlater、つまり決めきれないと答えました。当社の数え方ではlaterと見送りを同じ扱いにしているので、Clefはこの件も一致です。確信度は0.16なので、どのみち人が読む側に来ます。
確信度の列は、まるで違います。Jevは15件の中央値が0.99で、0.9以上が11件あります。Clefは14件の中央値が0.65で、0.9以上はゼロ、0.6未満が6件です。同じ件で比べると、Office LTSCの終了はJevが0.84、Clefが0.17。SharePointのAIページ作成はJevが0.98、Clefが0.40。答えは同じ研修の題材なのに、迷いの表し方が違います。質問の版が違うので、この差のうちどれだけが提供元の違いによるものかは、同じ版で測り直すまで分かりません。
確信度は、選択肢ごとの確率がどれだけ1つに集中しているかを表す数字です。Clefの値が低いのは、確率を他の選択肢にも分けて返しているということです。Cloudflareの発表は、学習でBrier損失という、確率の較正のための損失を使ったと書いています。ただし、予測した確率が実際の正答率に合っているか(較正)と、確信度の高低で一致率が分かれるかは、別々に確かめることです。当社の15件では誤りが1件しかないので、どちらも確かめられていません。
確信度の出方が違うなら、しきい値は取り直す
しきい値の記事で、当社は0.6未満を人に回し、0.6以上0.9未満は印を付けて自動で進め、0.9以上は確認なしで進める二段にしました。この線をそのままClefに適用すると、どうなるか。
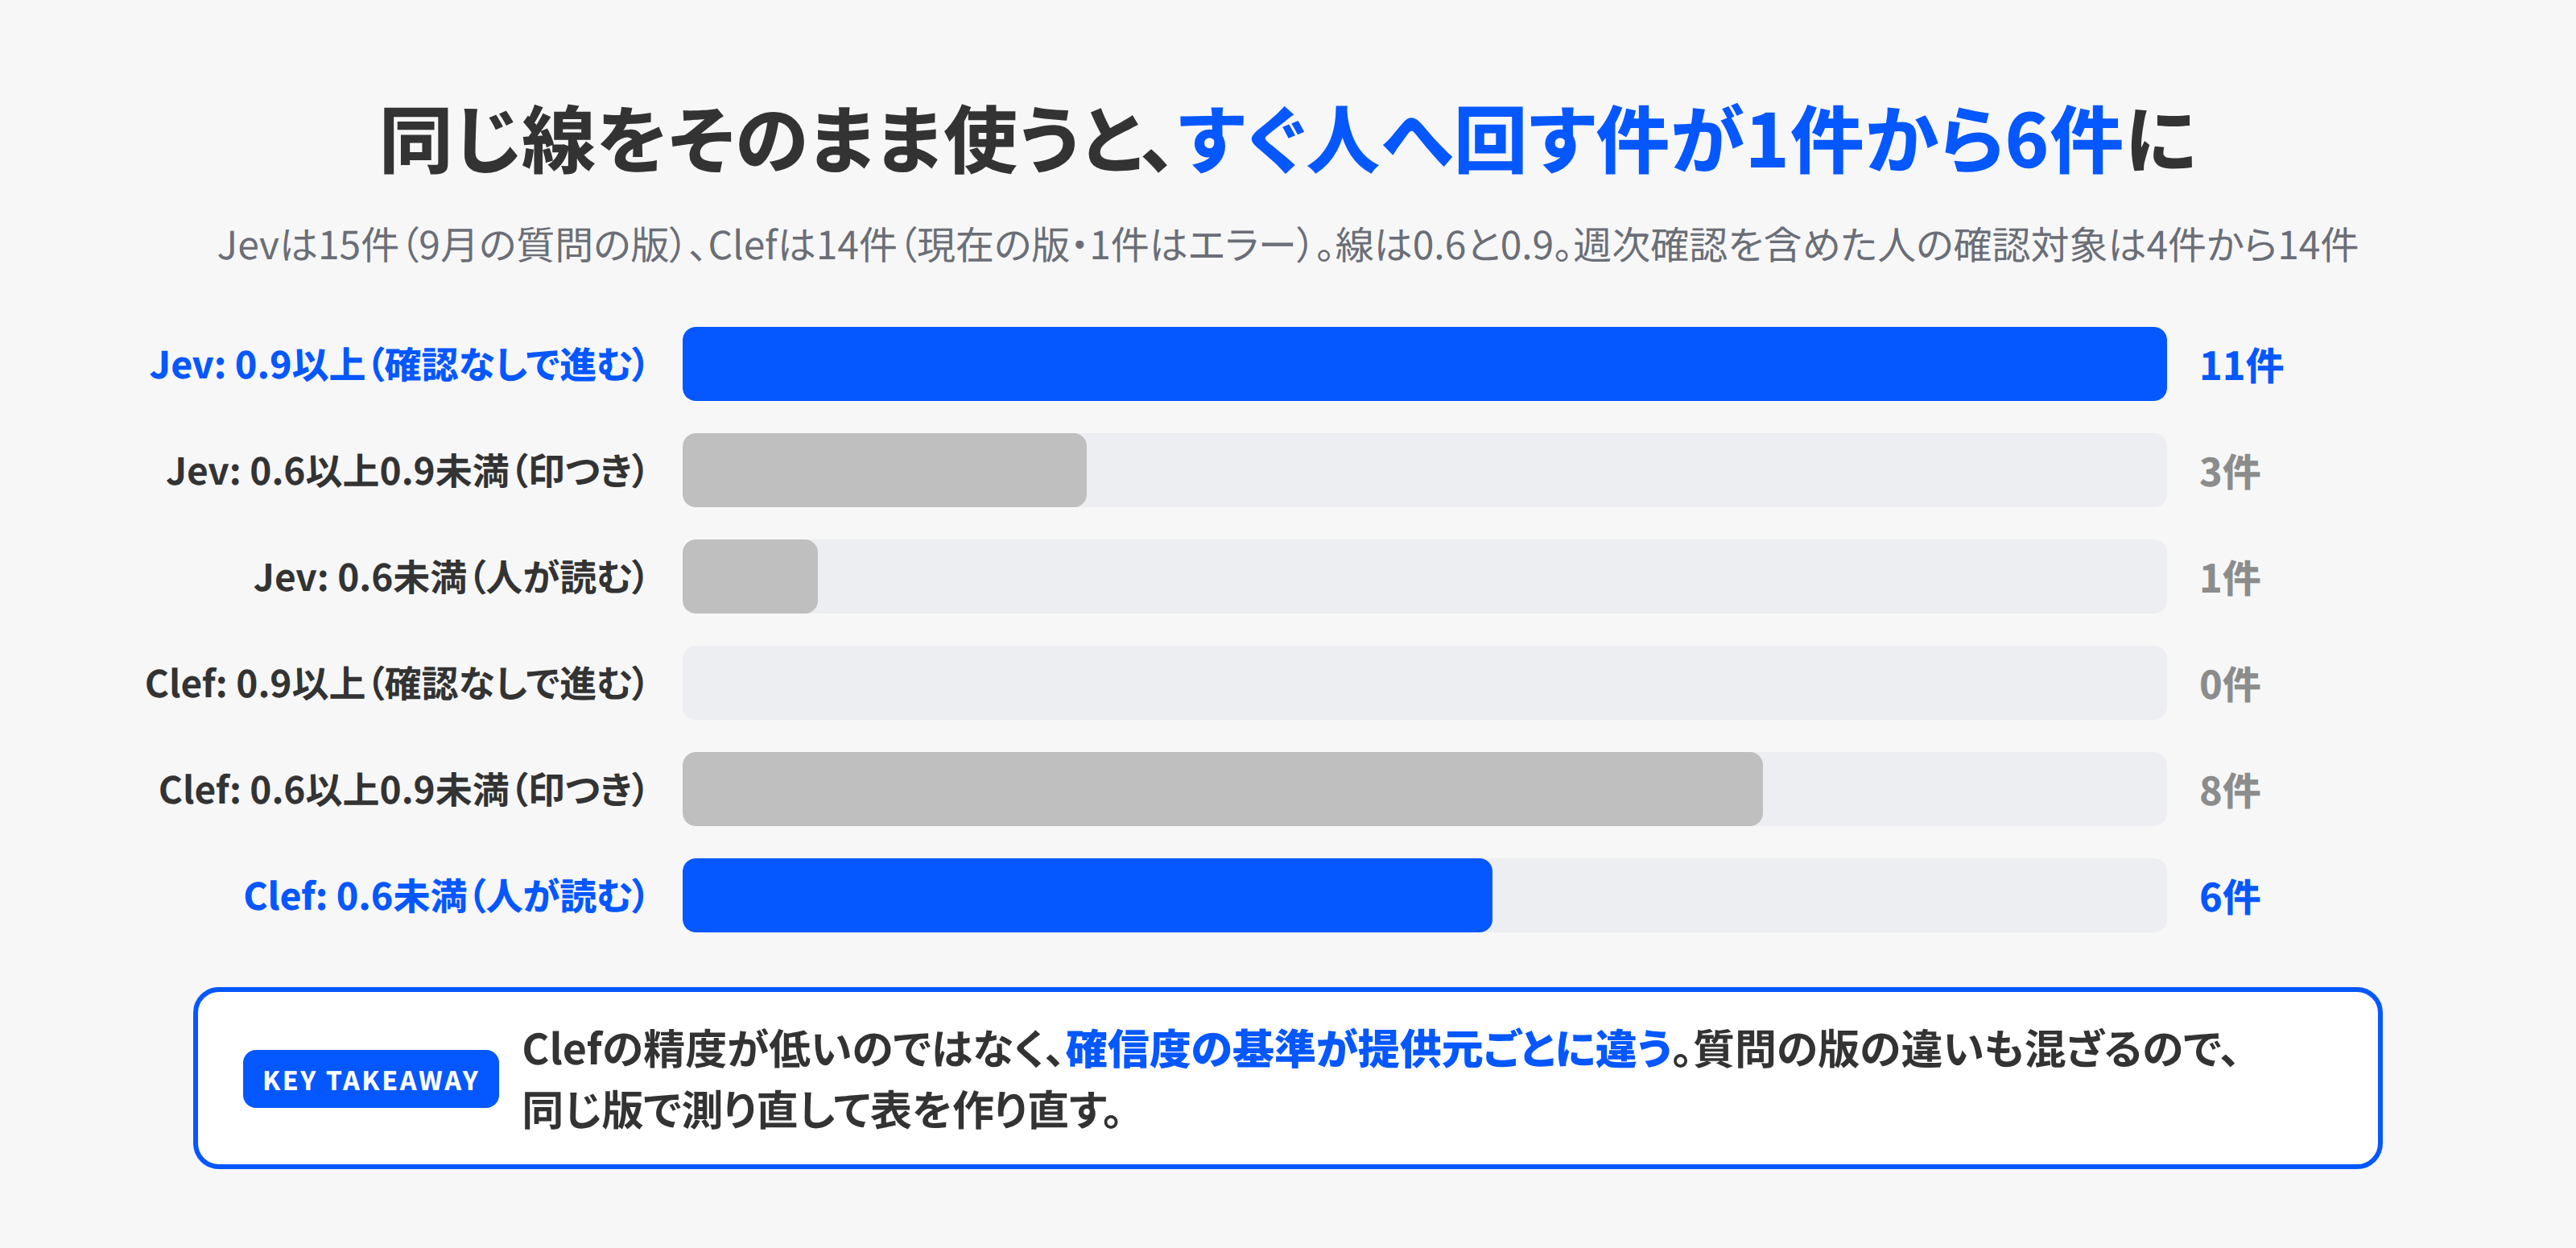
Jevでは15件のうち11件が確認なしで進み、印つきが3件、人が読むのが1件です。Clefでは14件のうち確認なしで進む件がゼロ、印つきが8件、人が読むのが6件になります。答えはほぼ同じなのに、線を変えなければ、Clefに切り替えた瞬間に、すぐ人へ回す件が1件から6件に増えます。印つきの件も週次で人が確認するので、確認の対象で数えると4件から14件です。Clefには、未判定の1件を後で再判定する作業も加わります。
これは、Clefの精度が低いという話ではありません。確信度という数字の基準が提供元ごとに違う、という話です。前の節に書いたとおり、質問の版も違うので、差の全部が提供元によるものとは言えませんが、提供元を変えたときに線をそのまま使えない、という結論は変わりません。しきい値の記事で「しきい値は質問の文章と組で決める」と書きましたが、提供元を変えるときも同じで、質問を変えたときと同じ手順で表を作り直します。
当社がClefの線を引き直す手順は、しきい値の記事の手順そのままです。比較運用の記録に人の確定判定を残し、0.5から0.99まで刻んで自動処理の件数と通った誤りの数を数え、過去の誤りがどの確信度に出たかを見る。今の14件から仮に置くなら、人に回す線は0.4あたり、確認なしの線は0.8あたりになりますが、誤りが0件の表から線を決めることはできないので、2週間の比較運用で件数を貯めてから決めます。
もう1つ、版の固定も提供元ごとに要ります。TypeSafe AIの公式ドキュメントは、しきい値を調整したなら別名ではなく版のIDを固定するように書いています。Jevでは当社はjev-1.13.0を固定しています。Clefは、Workers AI上のモデル名がclefで、Cloudflareは10月9日の続報で重みを変えずに提供基盤を変えて速くしたと書いています。重みが同じなら確信度の分布は動かないはずですが、重みが更新されたときに気づける形で記録を残す必要があります。当社は、判定の記録に提供元とモデル名を書いていて、応答に含まれるモデル表記も今後は毎回記録します。
当社の方針。Cloudflareに寄せる
10月13日に、社内で「Cloudflareだけで完結するより、Jevのほうが良かったか」という問いが出ました。当社の答えは、Cloudflareに寄せる、です。理由を3つ書きます。精度は理由に入っていません。今回の記録では人との一致に差が出ず、質問の版も違うので、精度の差は判断できないからです。
1つ目、口座と鍵が増えない。 当社のサイト、データベース、自動処理はすでにCloudflareの上で動いています。Clefを使うのに新しい契約も新しい鍵も要りません。Jevは契約が1つ、鍵が1つ増えた状態で、Microsoft-Decision-1を使えばAzureかOpenRouterの口座がもう1つ増えます。今回の入力の長さでは判定は1件0.0002ドル前後で、当社の想定件数では費用よりも、鍵を管理する手間と、請求先が増えることのほうが重い。契約と鍵を1つ減らせるのが、寄せる最大の理由です。
2つ目、重みが公開されている。 ClefはApache 2.0で重みが公開されています。今は当社のGPUに載りませんが、載る機種を用意するか、Clef-flashを量子化すれば、社外に材料を送らずに判定できる道があります。問い合わせの本文のように、外に出したくない材料を判定したい会社には、この道があるかどうかが決め手になります。JevとMicrosoft-Decision-1は、重みが公開されていません。ただし、The Registerの取材にCloudflareの担当者が答えているとおり、学習データは公開されていません。重みの公開と学習データの公開は別で、Clefは前者だけです。
3つ目、価格が明示されている。 Workers AIのモデルページに、入力100万トークンあたり0.24ドル、出力無料、と書かれています。Jevの6倍近い単価ですが、当社の月間の判定は数百件で、合計しても1ドルに届きません。単価の差より、公開された価格表があって、請求を自社の他のCloudflareの費用と同じ画面で見られることを取ります。
この方針を、当社は次の運用の決まりにしました。10月20日時点で決めた段階で、2週間の比較運用はこれから始めます。
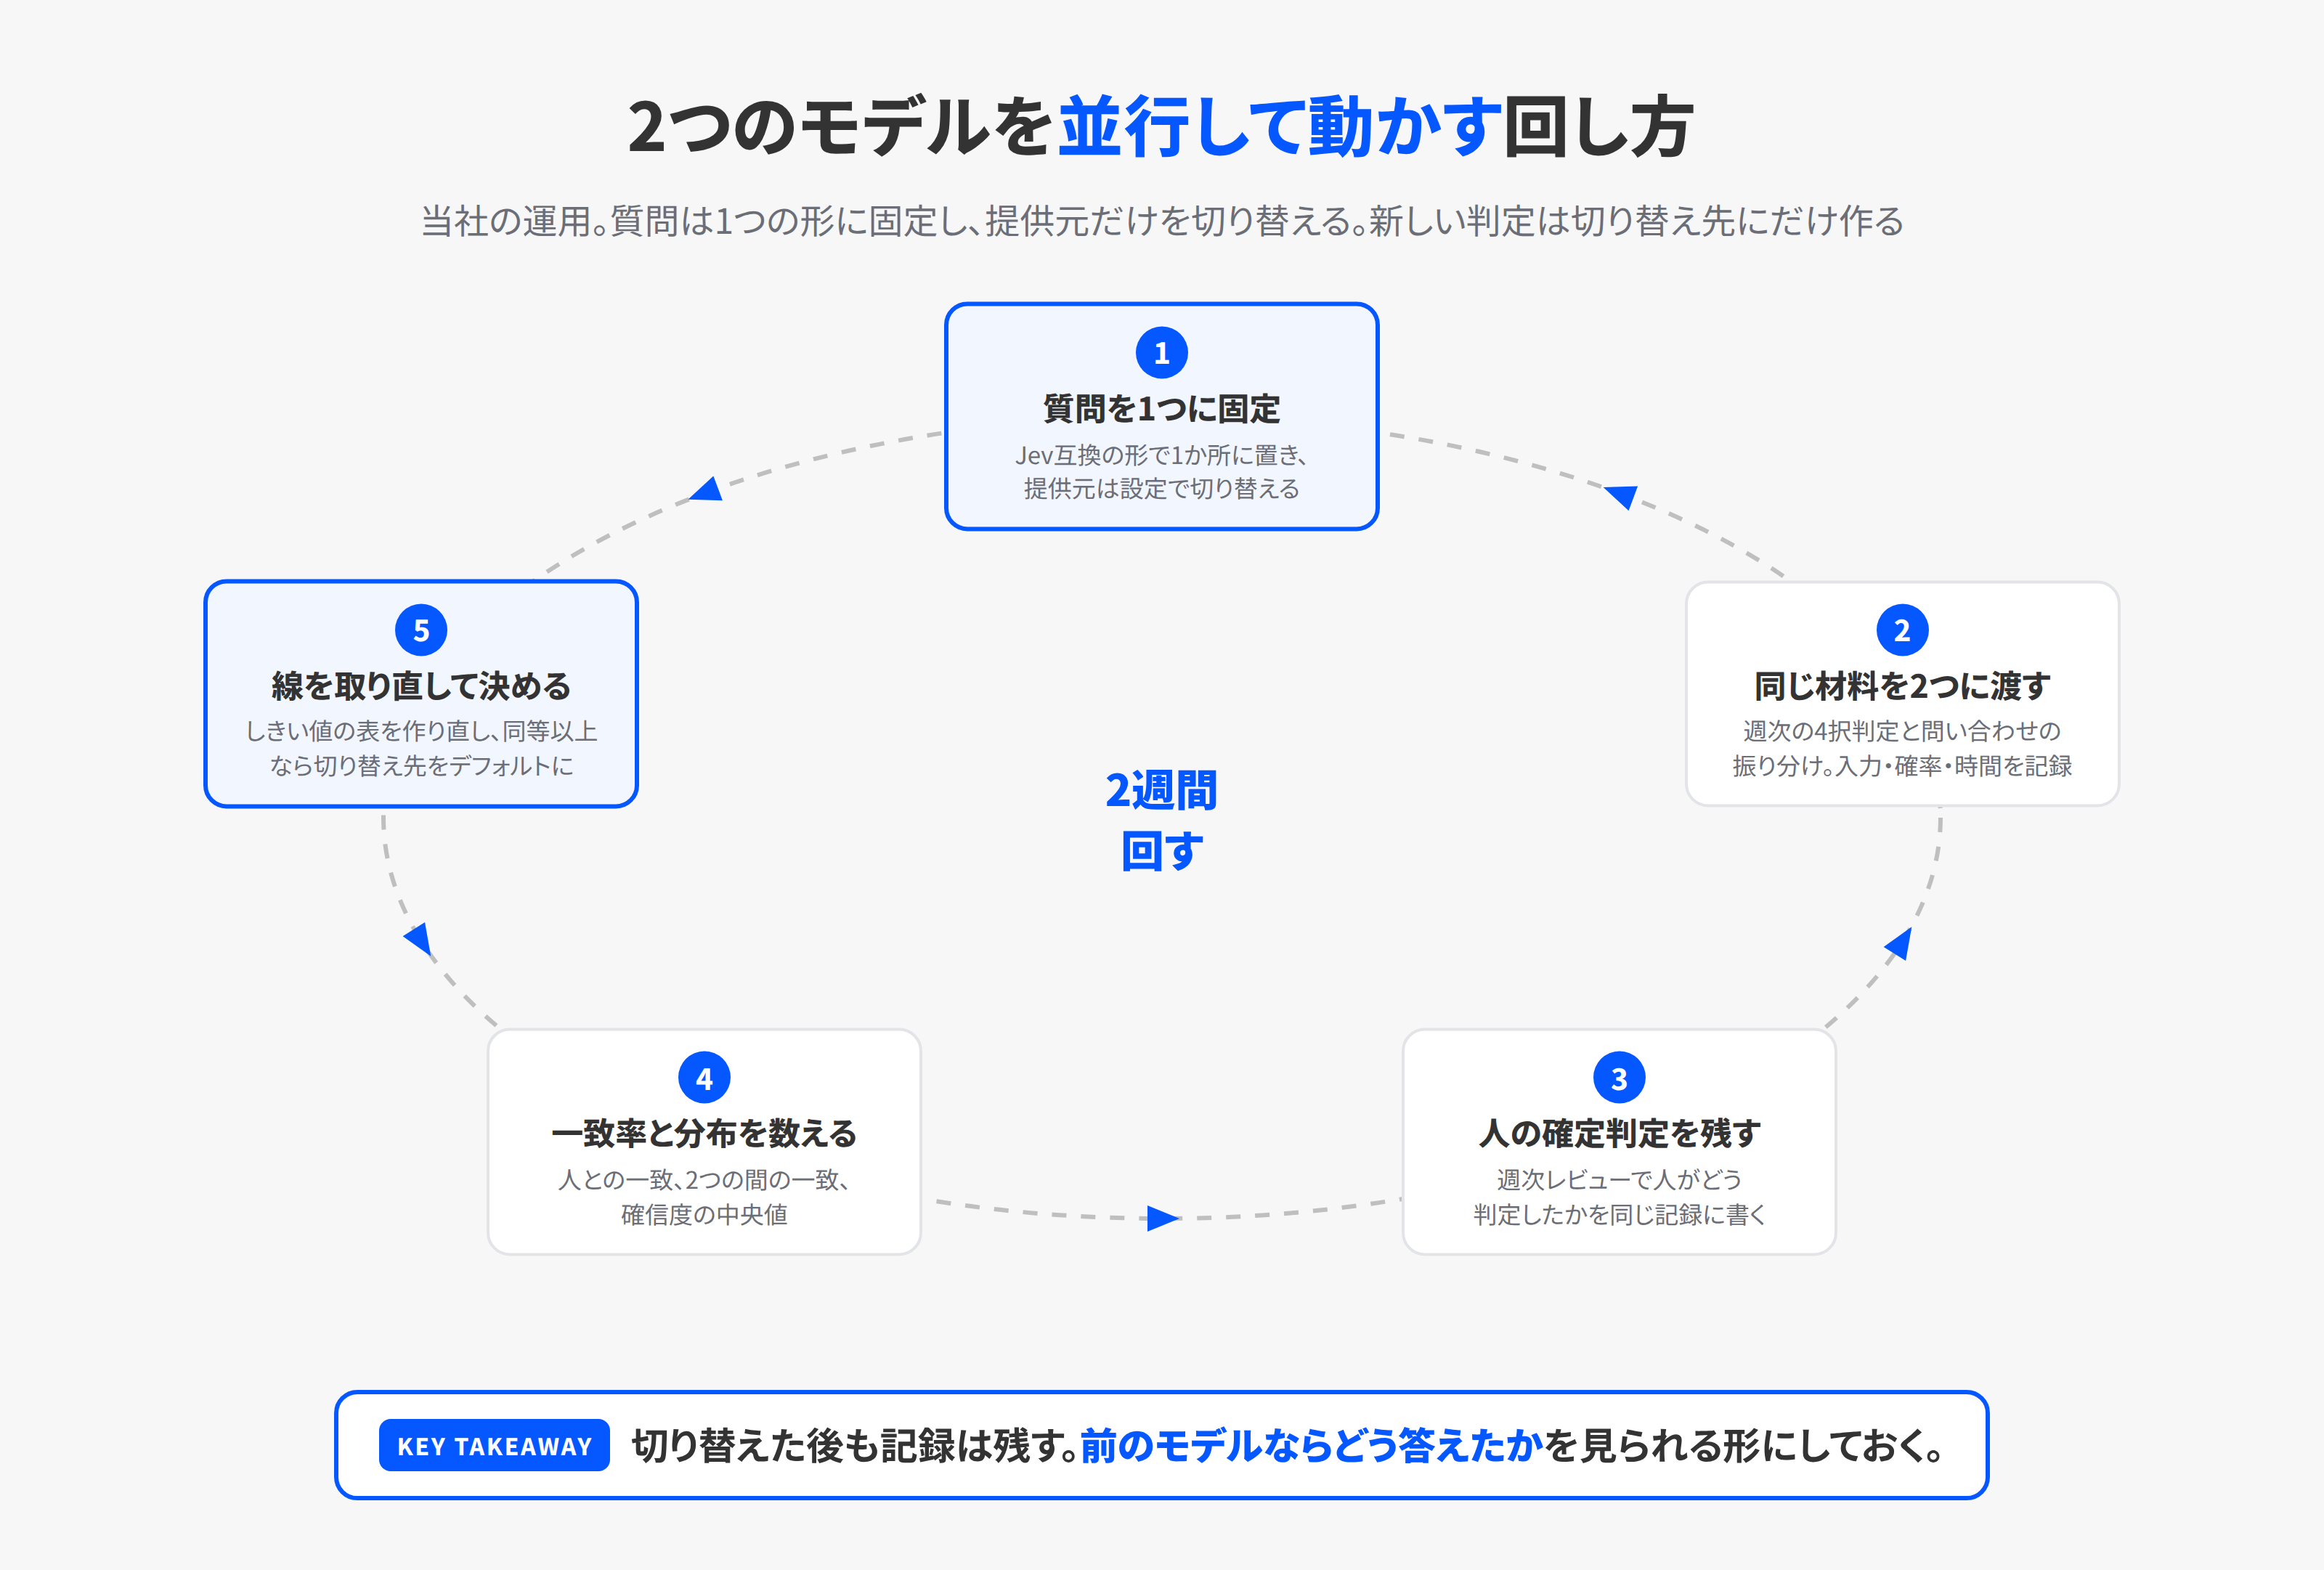
- 質問はJev互換の1つの形に固定する。 当社は質問の大もとを1つのスクリプトに置き、提供元を環境変数で切り替える形にします。ClefがJevの形をそのまま受け取るので、質問を2通り書く必要がありません。切り替えのスクリプトは、これから作ります
- 2週間、JevとClefを並行して動かす。 週次の4択判定と問い合わせの振り分けで、同じ材料を両方に渡し、人の確定判定と並べて記録します
- 一致率と確信度の分布を数える。 Clefが人の判定とJevと同等以上に一致していれば、デフォルトをClefにします。Jevは契約の更新時に止めます
- Clefのしきい値を取り直す。 比較運用の記録から表を作り、人に回す線と確認なしの線を引き直します
- 新しい判定はClefだけで作る。 2週間の間も、新しく作る判定はClef側にだけ登録します。Jev側には足しません
- Microsoft-Decision-1は契約を増やさない。 公開情報で見て、Jev互換が明記されるか、FoundryかOpenRouterの口座を別の理由で持つことになったら、同じ15件を渡して比べます
判定の記録は、公式更新の比較では入力と確率、応答の時間、トークン数を残します。問い合わせの振り分けでは、前の記事に書いたとおり本文を記録に残さず、判定の結果と確率、応答の時間、トークン数だけを残します。提供元を切り替えた後に「前のモデルならどう答えたか」を見られるようにするためです。
判定モデルに渡す仕事の選び方
提供元の話を先にしましたが、読者の会社でまず決めるのは、どの仕事を判定モデルに渡すかです。10月13日の社内の議論で、当社は2つの案を取り下げました。展示会で聞き取った課題の型分けと、研修の提出物の一次採点です。理由は、どちらも1回きりか、量がないからでした。判定モデルは1件の費用が安く速い代わりに、質問を書き、人の判定を記録し、しきい値を取る手間が最初に要ります。その手間は、同じ判定を繰り返す仕事でしか回収できません。
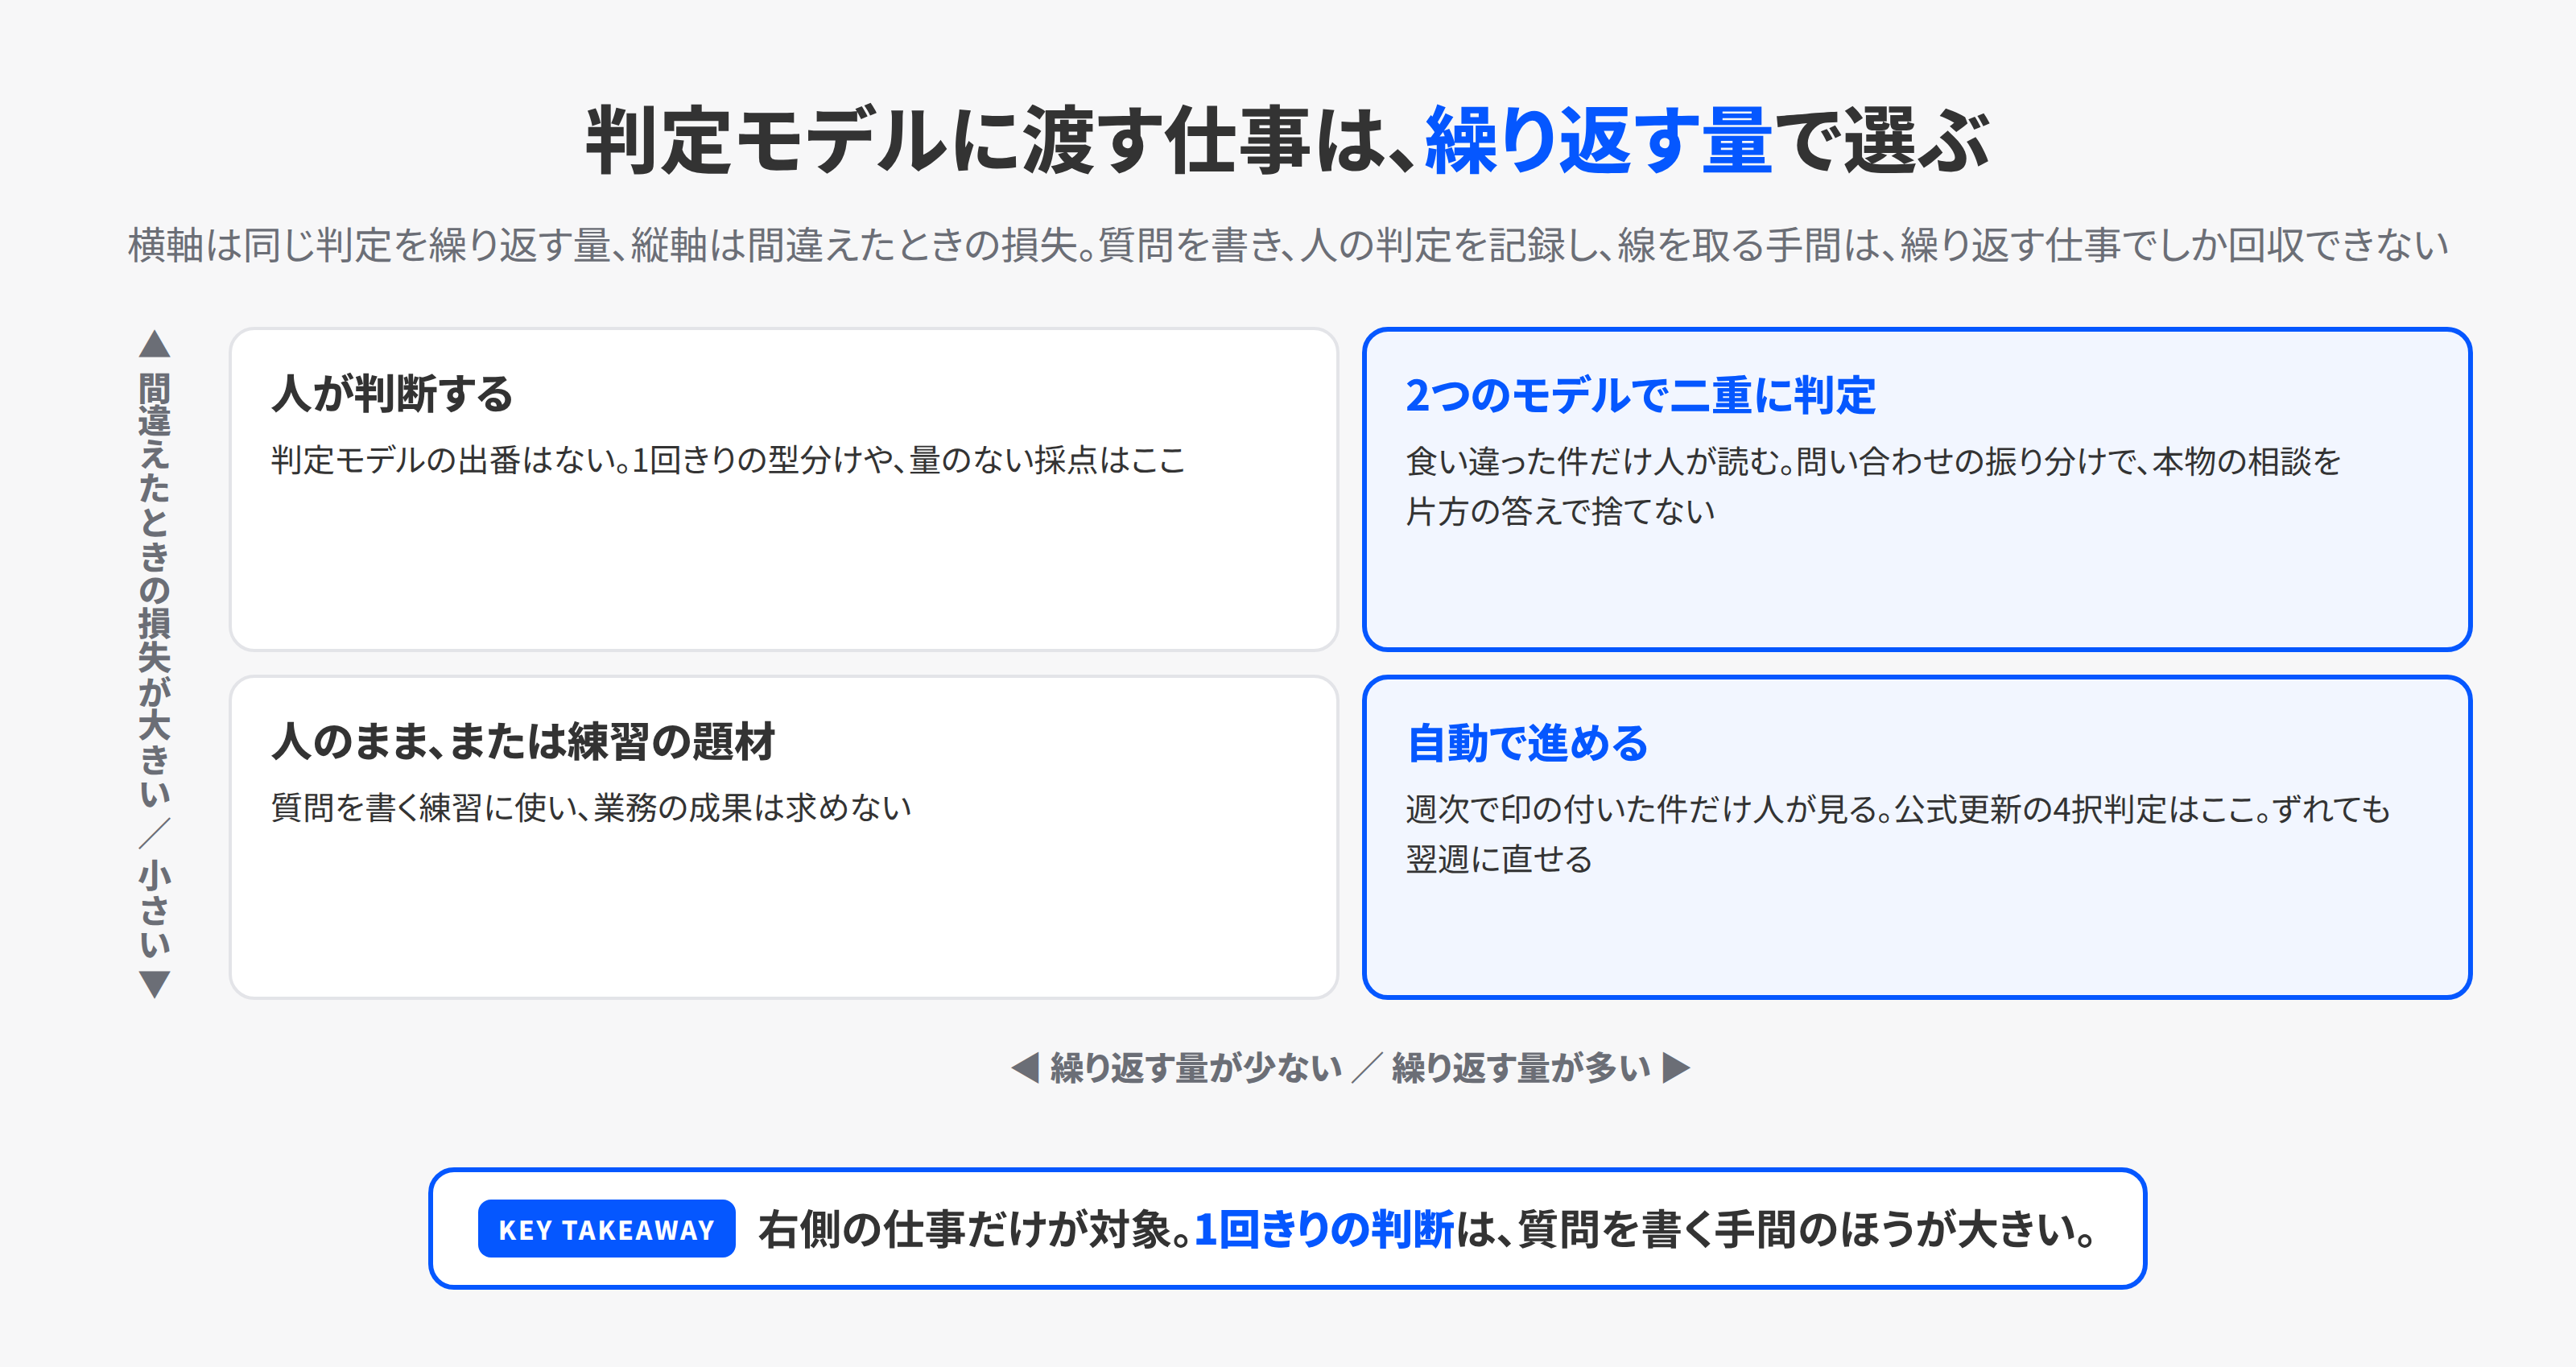
横軸は、同じ判定を繰り返す量です。縦軸は、間違えたときの損失です。
- 量が多く、損失が小さい仕事。 自動で進めて、週次で印の付いた件だけ人が見ます。当社の週次の4択判定がここです。記事の分類が1週間ずれても、翌週に直せます
- 量が多く、損失が大きい仕事。 2つのモデルで二重に判定し、食い違った件を人が先に読みます。当社の問い合わせの振り分けで、返信が要るかどうかの真偽判定をJevとClefの両方に聞き、食い違いを確認の先頭に置く形にします。二重判定は確認の順番を決める補助で、本物の相談を売り込みとして除外する判断は、見落としの率を確かめるまで人が全件を確認します。2つが同じ誤りをすれば、食い違いには出ないからです
- 量が少なく、損失が小さい仕事。 人のままにするか、社内で判定モデルに慣れるための題材にします。質問を書く練習として使い、業務の成果は求めません
- 量が少なく、損失が大きい仕事。 人が判断します。判定モデルの出番はありません
当社がこの図で右側に置いた仕事を、現状と提案の形で並べます。量と費用は当社の見積もりです。
| 判定 | 今 | 提案 | 質問の型 | 量の目安 |
|---|---|---|---|---|
| 公式更新の4択(研修・自社の運用・発信・見送り) | Jev | 継続。Clefを控えに | Choice | 週30件 |
| 問い合わせの振り分け | Jev | 継続。返信が要るかの真偽をClefでも二重判定し、食い違いを確認の先頭に置く | Choice+Noul | 月30件 |
| 無人で作った記事の公開前の検査 | 無し(機械検査は禁止語だけ) | 根拠のない頻度や断定があるか、例が実例に読めるか、顧客名や実数が無いか、を真偽で判定し、1つでも真なら配置しない | Noul×3 | 日2本 |
| SNS投稿文の検査 | 人 | 断定で締めていないか、補足の括弧が無いか、1日1テーマに反していないか、を段階で判定し、低い文は出さない | Score | 日10本 |
| 新機能の見出しに記事にする価値があるか | 人が受信箱を読む | 見出しごとに4択で判定し、高確信の件だけ待ち行列に足す | Choice | 日20件 |
| 広告の見張りで検知したドメインが不正か | 不明なドメインは全部検知 | 自社か顧客の正当なページか、不正なページか、を判定し、不正の高確信だけ即停止、それ以外は人へ | Choice | 月数件 |
| アフィリエイト提携の申請可否 | 人 | 提携条件が自社媒体の規約と合うかを真偽で一次判定し、人は真の件だけ申請する | Noul | 週10件 |
| 週次報告の数字に対策が要るか | 生成AI | アクセス解析の変化を、無視・様子見・対策の3段階にして、対策が要る数字だけ生成AIが考察する | Score | 週20指標 |
3行目と4行目は、この記事を書いている仕組みの検査です。当社のブログの一部は無人で制作していて、公開前の検査は禁止語の機械検査と、別のAIが元の資料と見比べる事実の確認です。「根拠のない頻度を書いていないか」のような判断は、今は確認役のAIが文章で指摘していますが、真偽の判定に置き換えれば1件あたり1円未満で、配置する前にプログラムとして止められます。費用は日2本、1本あたり1.2万トークンとして月0.2ドルです。
提供元を決める4つの判断基準
自社の判定をどの提供元に渡すか。当社が今回の比較で使った判断基準を、読者が使える形にします。
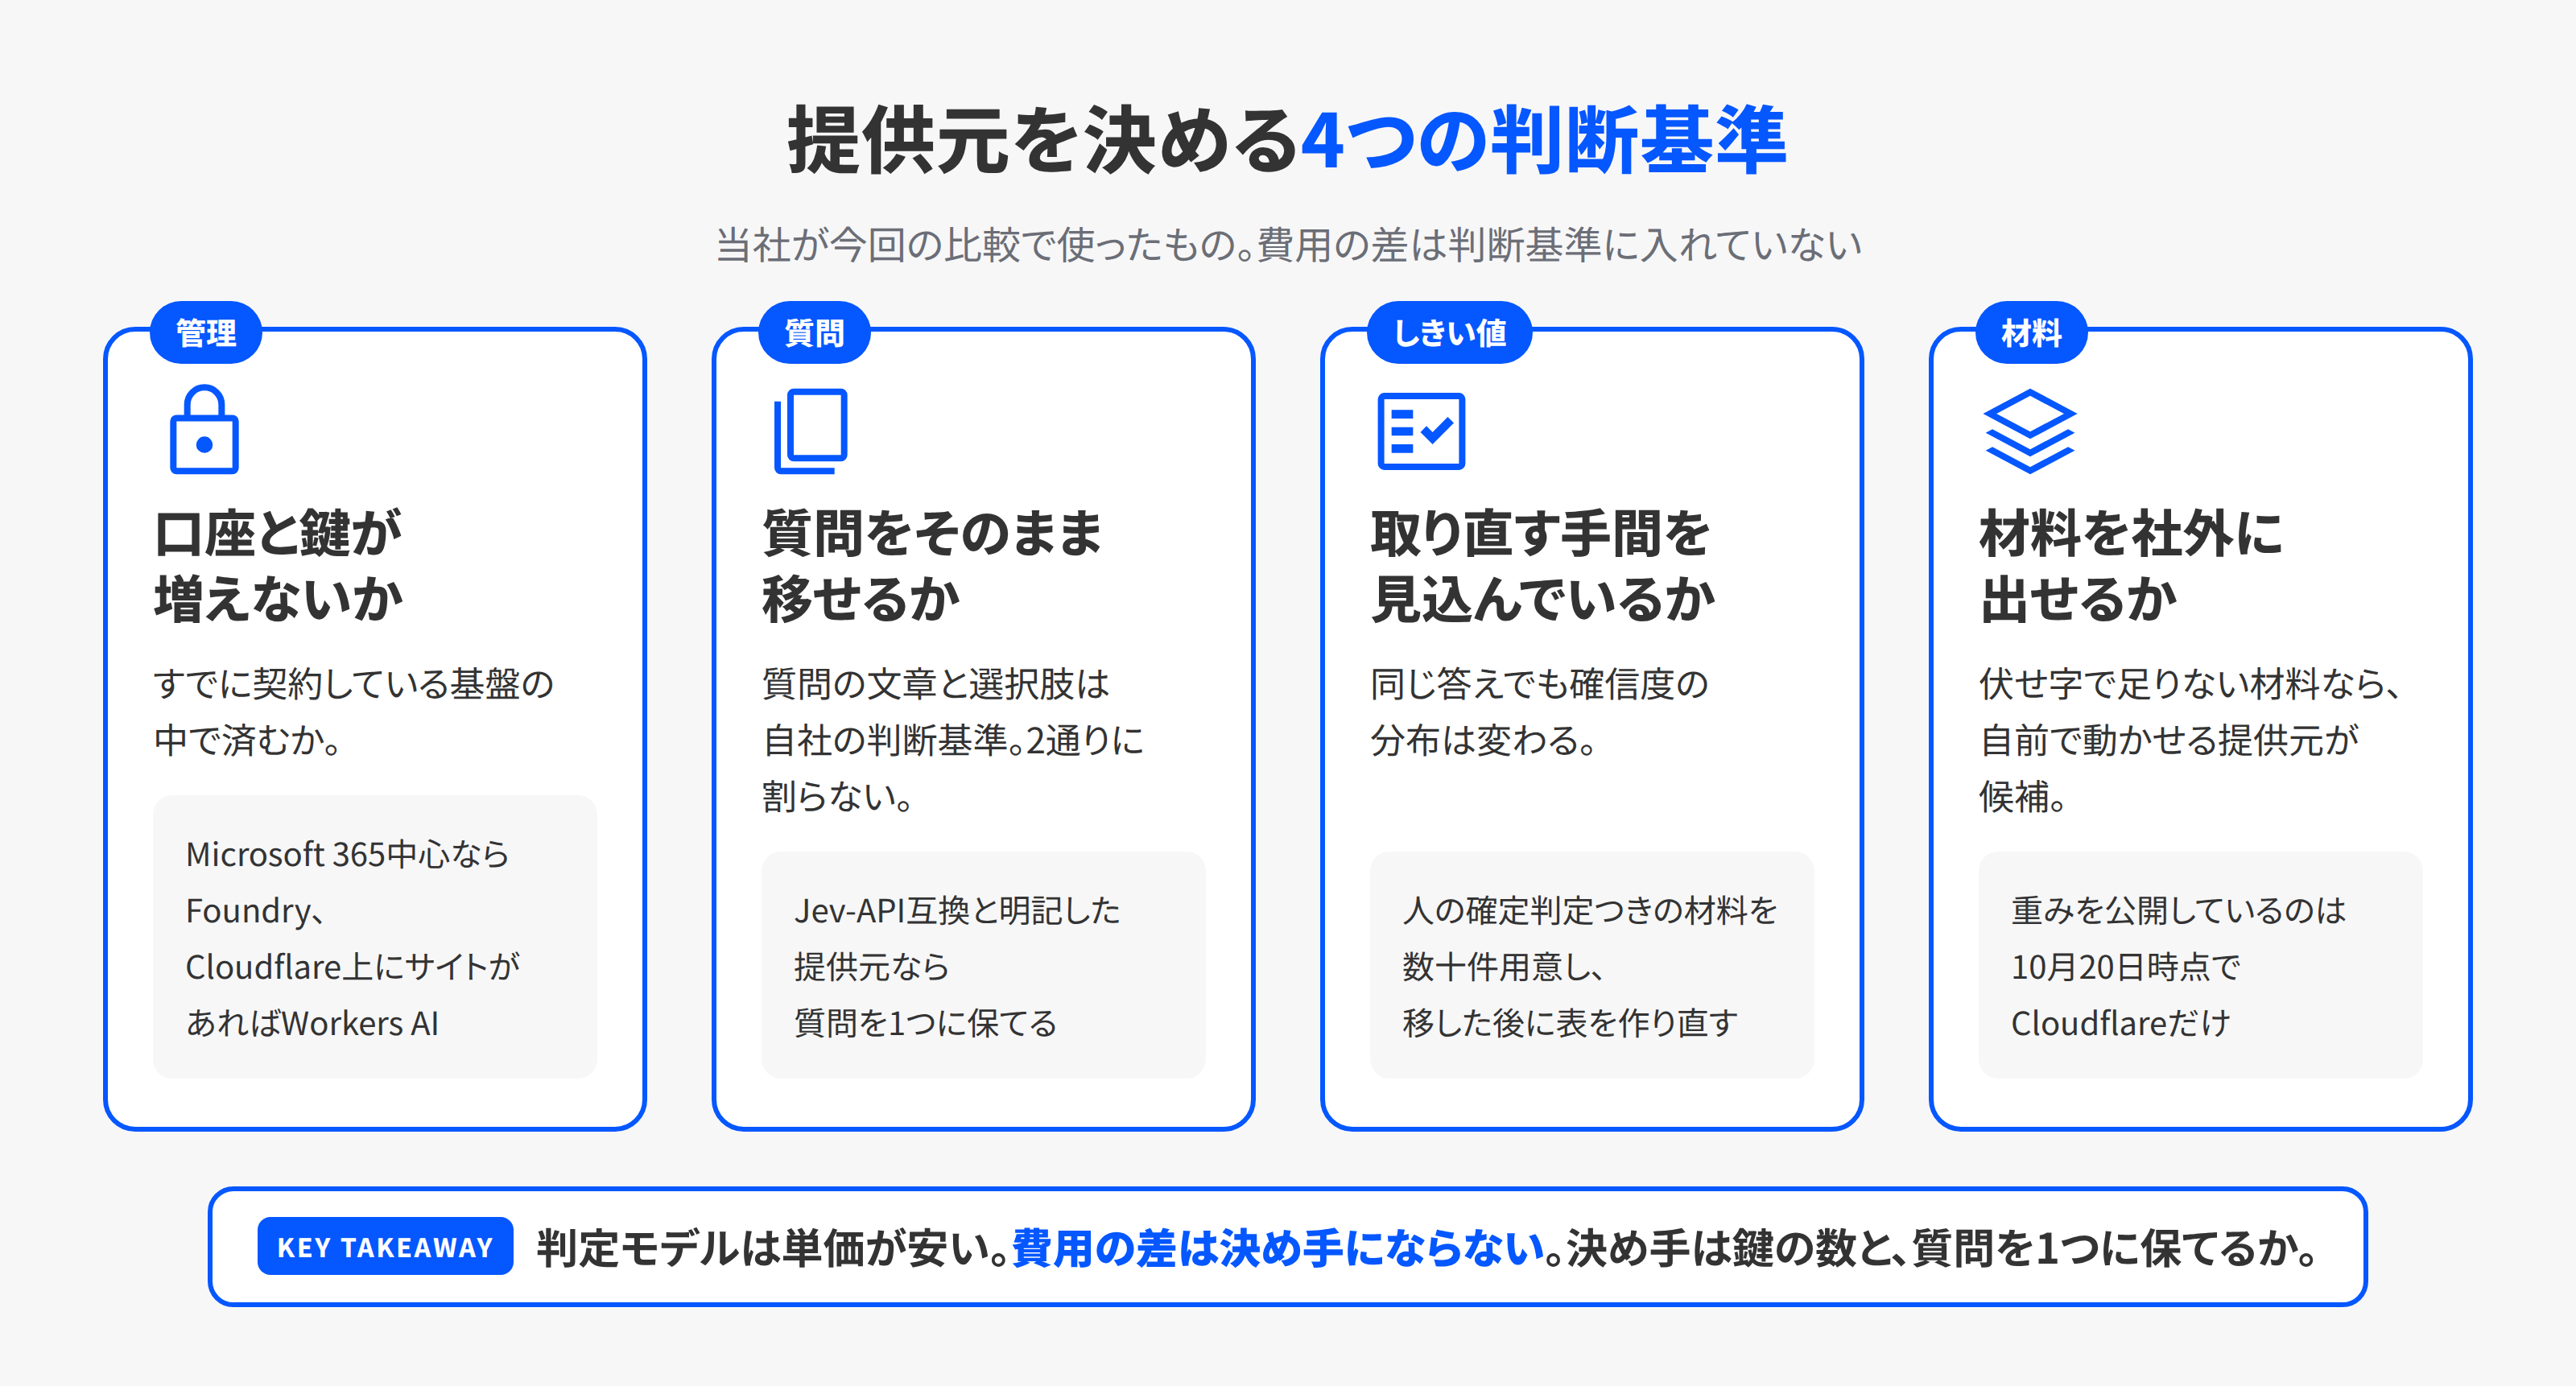
口座と鍵が増えないか。 当社の入力の長さと件数では、判定モデルの費用の差は決め手になりませんでした。決め手は、すでに契約している基盤の中で済むかどうかです。Azureの契約とFoundryを運用する体制がすでにある会社ならFoundry、Cloudflareの上にサイトがある会社ならWorkers AI、どちらでもない会社ならJevの単独契約が、それぞれ鍵の少ない選択です。Microsoft 365を使っているだけでは、Foundryの口座と権限は別に要ります。
質問をそのまま移せるか。 質問の文章と選択肢の定義は、自社の判断基準を文章にしたものです。これを提供元ごとに書き直すと、基準が2つに割れます。Jev-API互換と明記している提供元なら、質問を1つに保てます。互換が書かれていない提供元を選ぶときは、質問の変換を自社で書くことになり、変換の違いが答えの違いになります。
しきい値を取り直す手間を見込んでいるか。 提供元を変えると、同じ答えでも確信度の分布が変わります。移す前に、人の確定判定つきの材料を数十件用意し、移した後に表を作り直す。この手間を見込まずに移すと、人に回る件数が突然増えるか、誤りが通り抜けるかのどちらかが起きます。
材料を社外に出せるか。 問い合わせの本文、社員の申請、顧客の文書を判定するなら、材料がどこへ送られるかが先です。当社は問い合わせの本文からメールアドレスやURLを伏せ字にしてから送っています。伏せ字で足りない材料なら、重みが公開されていて自前で動かせる提供元が選択肢になります。10月20日時点で重みを公開しているのはCloudflareだけです。
注意点
数字は各社の自測です。 Clefの速さと精度の表はCloudflareが自分で測ったもので、The Registerは、公式のDecision Indexではまだ再現されていないと書いています。Microsoft-Decision-1の36ベンチマークもMicrosoftの測定です。自社の材料で測るまで、どちらが上かは分かりません。当社の15件は、人との一致で差が出なかったと言えるだけの数で、質問の版も違います。モデル間の精度の差は、この記事からは判断できません。
Clef-flashの価格とWorkers AI上の文脈は10月9日に変わりました。 Clef-flashは0.09ドルから0.038ドルに下がり、Workers AI上の文脈は64kから24kに縮みました。Clefの価格は0.24ドルのままです。発表から1週間あまりで条件が変わっています。この記事の数字は10月20日の確認で、導入のときは価格表を見直してください。
エラーで判定できない件が出ます。 当社の15件のうちClefは1件がHTTP 429(呼び出し制限)、Clef-flashは15件全部がHTTP 422(リクエストの内容の不備)で判定できませんでした。原因は別で、前者は時間を置いて再判定、後者は呼び出し側の直しが要ります。比較運用の仕組みには、エラーの件を記録して後で再判定する手順が要ります。
英語が主な学習言語です。 TypeSafe AIの公式ドキュメントは、英語が主な学習言語で、他の言語は扱えるが同じ精度ではない、と書いています。当社の材料は日本語で、15件の一致には差が出ませんでしたが、日本語が原因の誤りを見分ける試験はしていません。自社の材料で確かめるのが先です。Clefの土台のQwenは多言語で学習されていますが、Clefの追加学習の言語は発表に書かれていません。
互換は、同じ答えを保証しません。 Jev-API互換は、同じ形の質問を受け取り、同じ形の答えを返す、という意味です。この記事の実測のとおり、確信度の出方は違います。互換を「移すだけで同じ結果になる」と読まないでください。
Microsoft-Decision-1は当社の未検証です。 この記事の数字は発表によるもので、当社は呼び出していません。Microsoftは土台をMAIやOpenAIのモデルに置き換える予定だと書いていて、置き換わると確信度の分布も変わります。
KOIYALの見解
Jevが出たとき、当社は「判断だけを返すAI」を自社の週次処理に組み込みました。1か月以内に同じ型のモデルが2社から発表され、公開されている価格は入力100万トークンあたり0.038ドルから0.24ドルの幅に収まり、重みが公開されたものも出ました。当社の件数では、判定をAIに渡す費用は、提供元を選ぶ理由になりませんでした。
残るのは、自社の判定を文章にする仕事です。選択肢の名前、迷ったときの規則、人の確定判定の記録、線を引いた理由。これは提供元を変えても持っていける資産で、当社がClefに同じ材料を渡したときも、質問のJSONは1文字も変えていません。変わったのは接続先と鍵と、応答の取り出し方です。しきい値は取り直します。
当社は、インハウス経営(AIを活用し、自社で業務を改善し、自社で仕組みをつくる経営)を自社の中心に置いています。判定モデルは、その中で最初の費用が小さい仕組みの1つです。読者の会社が自社でできるようになることを1つ挙げるなら、繰り返している判定を1つ選び、選択肢と規則を1枚に書き、2つのモデルに同じ材料を渡して一致率を数えることです。誰が判定の基準を決めるかは自社の中に置き、モデルは差し替えられるものとして扱う。そうすれば、来年また新しい判定モデルが出ても、判断基準の文章は書き直さずに済みます。接続としきい値の調整は、そのたびに行います。
次の行動
- 社内で繰り返している判定を1つ選ぶ。問い合わせの仕分け、申請の一次確認、記事の分類のように、答えが数個の選択肢に収まり、人の判定が後から付くもの
- 選択肢の名前と迷ったときの規則を1枚に書き、直近の20件に人の判定を付ける
- その20件を2つの提供元に渡し、一致率と確信度の分布を並べる
3つ目まで自社でやって、仕組みに組み込む人手が足りない会社には、FDE型支援があります。社外の推進チームが社内に入り、質問の大もと、比較運用の記録、しきい値の表を自社の中に作って、運用を社員に移して離れます。お問い合わせの本文に、繰り返している判定を1つ書いていただければ、初回の前に質問の形に直してお持ちします。
参考
- Introducing Clef: our open-source decision models, and new RL fine-tuning platform(Cloudflare・2026年10月1日。確認日2026年10月20日)
- Introducing Clef-omni with full multimodality, plus a faster Clef and a cheaper Clef-flash(Cloudflare・2026年10月9日。確認日2026年10月20日)
- Cloudflare/clef(Hugging Face。Apache 2.0・Jev/SystemOne互換の記述。確認日2026年10月20日)
- Clef(Workers AI モデルページ。価格・文脈・画像の上限。確認日2026年10月20日)
- Microsoft-Decision-1(Microsoft Command Line・2026年10月9日。確認日2026年10月20日)
- Models(TypeSafe AI 公式ドキュメント。Jev 1.14の提供日・価格・別名。確認日2026年10月20日)
- Cloudflare tries to outplay Jev with open-weight Clef models(The Register・2026年10月1日。確認日2026年10月20日)
- Jevとは何か。文章を書かず判断だけを返すAIの使いどころ(KOIYAL・2026年9月19日)
- Jevの導入手順。自社の4択判定に組み込んで分かったこと(KOIYAL・2026年9月19日)
- Jevの質問はこう書く。基準を4通り試して分かった書き方(KOIYAL・2026年9月25日)
- Jevの確信度しきい値をどう決めるか(KOIYAL・2026年9月26日)
- Jevで問い合わせを振り分ける(KOIYAL・2026年9月29日)
- AIの費用を誰が見るか。3社に1社がトークン予算を使い切る(KOIYAL・2026年10月22日)