

AIエージェントを業務で使っていると、育ち続けやすいファイルがあります。指示書です。
Claude CodeならCLAUDE.md。Codexをはじめ多くのエージェントが読む共通の形式ならAGENTS.md。
GitHub Copilotなら.github/copilot-instructions.md。名前は違っても中身は同じで、「毎回これを守って動いて」というルールを書き溜めるファイルです。
最近は、Claude Codeも作業ディレクトリとその上位にCLAUDE.mdが無い場合はAGENTS.mdを読み込み、GitHub CopilotもAGENTS.mdを使えるなど、ファイルの共通化も進んでいます。
うまく動かなかったら1行足す。事故が起きたらルールを足す。好みを伝えたくなったらまた足す。こうして指示書は増える一方になります。
では逆に、最近その指示書から何かを消したのはいつでしょうか。この質問に、すぐ答えられるでしょうか。私たちKOIYALの指示書も増える一方で、意識して消しにいかない限り、自然に減ったことはほとんどありません。
この「増える一方」に、名前を付けた研究が出ました。この記事では、その研究の中身と、指示書を痩せさせるために私たちがやっている5つの運用、そして棚卸しで確認したい不備まで書きます。
これからエージェント運用を始める方が、最初から同じ穴に落ちないための記事です。
この記事の要点
- AIエージェントの指示書は、平均的な推移で最初の版の3倍以上に増え、古い指示ほど消されにくくなる(1,867リポジトリの研究)
- 消せなくなる原因は、指示を入れた理由が失われること。理由と日付を残せば、消すかどうかを判断できる
- 対策は、理由と日付の記載、索引と本体の分離、手順書への切り出し、機械検査への移行、定期的な棚卸しの5つ
- これから始める会社は、指示書の分担と書式、棚卸しの周期を導入初日に決めておく
「破滅的記憶」という名前がついた
2026年8月11日にarXivに投稿された研究「Why Does CLAUDE.md Keep Growing? Catastrophic Remembering in Agentic Coding」(Kushal Chakrabarti、arXiv:2608.11095・査読前のプレプリントです)は、GitHub上の1,867リポジトリを対象に、AIエージェント向け指示ファイルの中の247,694件の指示について、追加されてからの経過(消えるまでの履歴)を追跡しました。
個々の指示が「いつ生まれ、いつ消えたか」を24万件規模で追った調査は、私の知る限り初めてです。
結果を3つ紹介します。
第一に、指示ファイルの指示の数は、平均的な推移で最初の版と比べて最大226%増えていました。最初の3倍以上に太る、ということです。複数の版があるリポジトリのうち、指示が増えたのは64.3%、減ったのは26.6%でした。
第二に、コミット(変更の記録)ごとの指示の増減を追うと、大規模な書き直しを除いて、1コミットあたり平均4.9本の純増でした。
足される指示は多く、消される指示は少ない。ファイルが太るのは、書き手が怠慢だからではなく、出入りの収支が構造的に黒字(増える側)だからです。
第三に、古い指示ほど消されにくくなっていました。入って時間が経った指示は、触られにくくなる。地層のように下に溜まっていきます。
一括で書き直せば解決する、というわけでもありません。研究では、消えた指示の76.8%は、1回のコミットで指示の半数以上が失われる一括の書き直しに伴うものでした。
そして、書き直しの時点をそろえた52ファイルの平均では、書き直しの後の10コミットで、書き直す前の91.5%まで戻っていました。書き直しで分量は減っても、太る仕組みは残るということです。
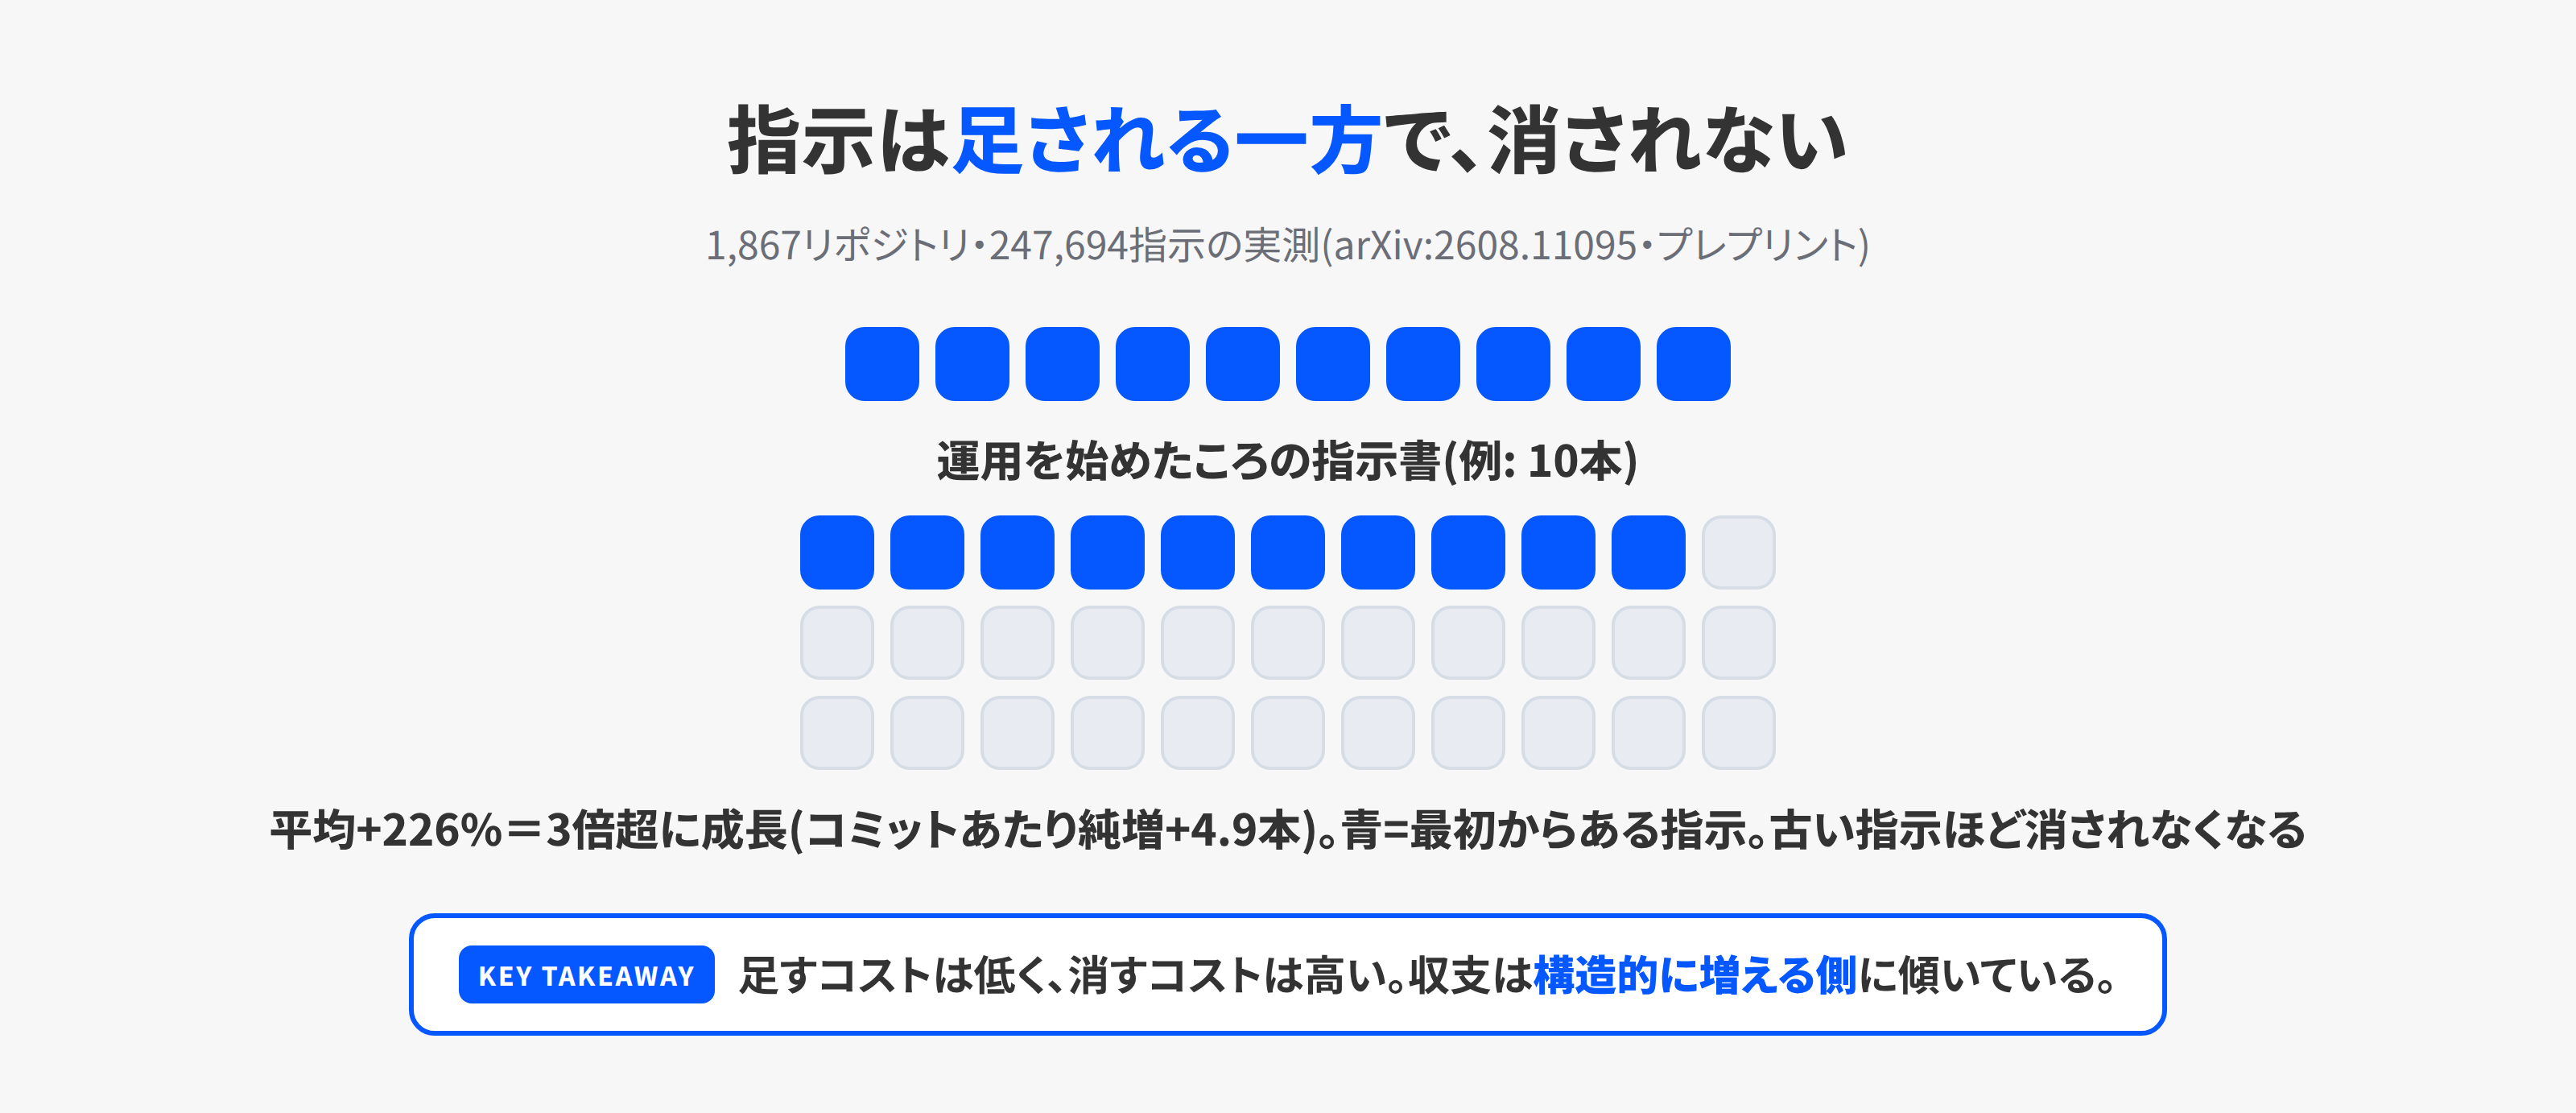
研究はこの現象を「破滅的記憶」(catastrophic remembering)と呼んでいます。機械学習には、新しいことを学ぶと古いことを忘れてしまう「破滅的忘却」という有名な問題がありますが、その逆です。
忘れられなくて困る。人間が管理する指示書は、覚えすぎて壊れていくというわけです。
なぜ消せなくなるのか
理屈は単純で、追記と削除でかかる頭の使い方が違うからです。
指示を1行足すときは、目の前の問題だけ見れば済みます。「表記ゆれが出た。だから表記ルールを足す」。これで終わりです。かかる時間は1分です。
ところが消すときはそうはいきません。この指示、なぜ入れたんだっけ。今も必要なんだっけ。消したら何が壊れるんだっけ。
他の指示と組み合わさって効いていたりしないか。指示が増えるほど確認すべき組み合わせも増えるので、削除の確認コストは指示の数に対して爆発的に増えていきます。
研究はこの非対称を定式化しています。研究のモデルでは、理由が失われた指示を誤動作の危険なしに消すには、指示の数をDとすると2のD乗の規模の検証が必要になると論じています。
一方で、指示を書くときに理由を記録しておけば、その手間は一定で済みます。実感としても分かる話だと思います。足すのは1分、消すのは半日、です。
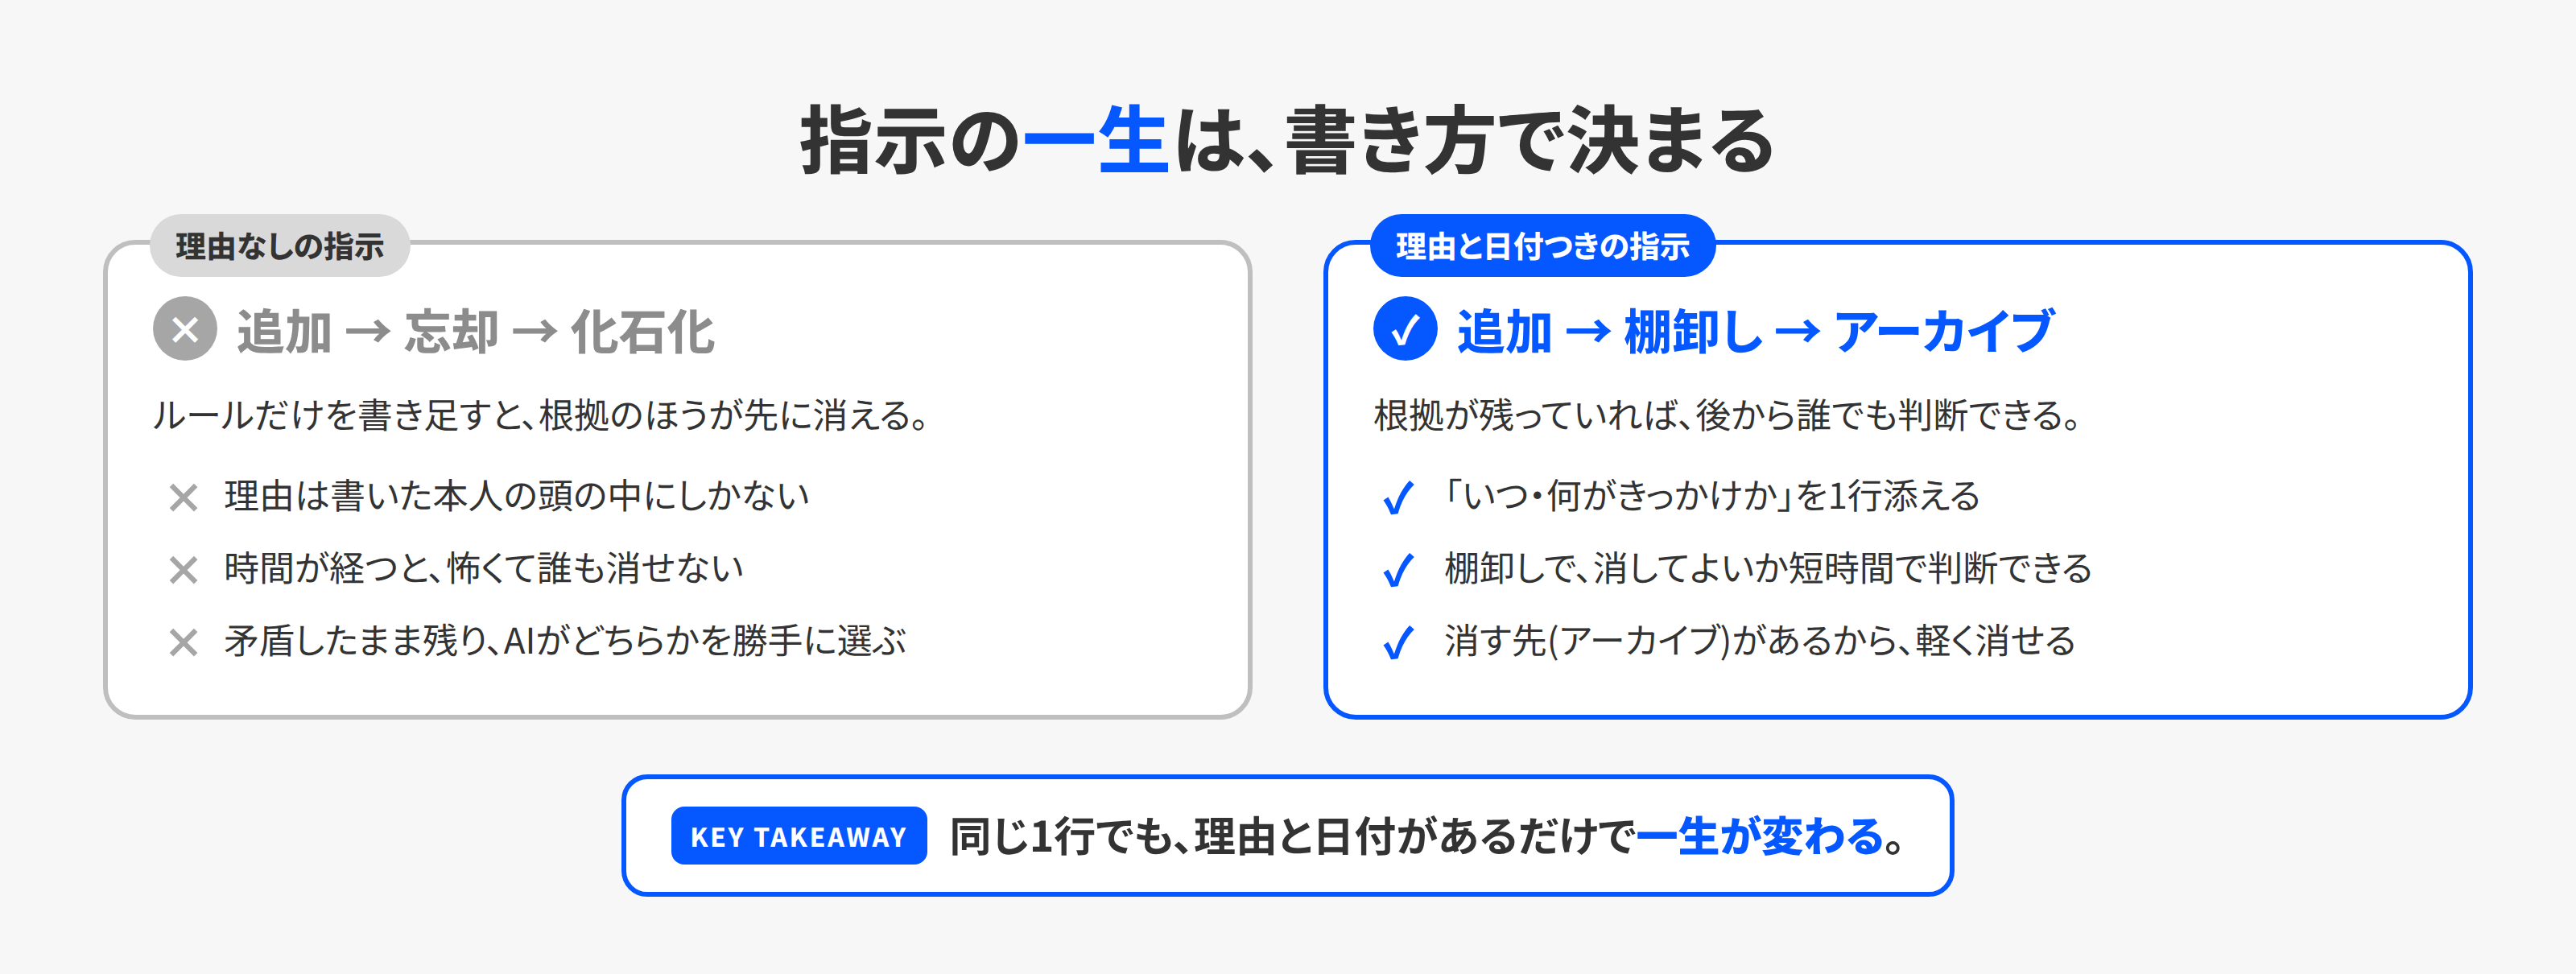
そして決定的なのが、根拠の消失です。指示を入れた理由は、入れた本人の頭の中にしかないことが多い。時間が経つか担当が変わると、理由だけが先に消えます。
理由の分からない指示は怖くて消せません。こうして指示書には、誰も理由を説明できないルールが化石のように積もっていきます。
これはAIの指示書に限った話ではありません。社内規程やマニュアルで昔から起きてきたことと、まったく同じ構造です。ただ、AIの指示書には昔のマニュアルと決定的に違う点が1つあります。読者が毎回、指示書を読み込むことです。
太った指示書は、静かに実害を出す
人間の読者は太ったマニュアルを読み飛ばせますが、AIは指示書を毎回読み込みます。Claude Codeの公式ドキュメントでも、CLAUDE.mdはセッションの開始のたびに読み込まれると説明されています。だから太り方がそのまま実害になります。
まず、コストと速度です。指示書はAIへの入力として毎回送られるので、太った分だけ処理量が増えます。1回あたりはわずかでも、エージェントを使う回数が増えるほど積み上がります。
次に、記憶の圧迫です。AIが一度に扱える情報量(コンテキスト)には上限があり、指示書が太るほど、本題の作業に使える残りが減ります。
長い作業の後半で品質が落ちる問題はセッション管理の記事で詳しく書きましたが、太った指示書はその劣化を早める要因になります。
Claude Codeの公式ドキュメントは、CLAUDE.mdを1ファイル200行未満にする目安を示し、長いファイルはコンテキストを多く消費し、指示が守られにくくなると説明しています。
そして一番怖いのが、矛盾です。「昔決めた表記ルール」と「先月変えた表記ルール」が両方書いてあれば、AIはどちらかを選ぶ場合があります。
Claude Codeの公式ドキュメントにも、2つの指示が矛盾していると、Claudeがどちらかを任意に選ぶ場合があると書かれています。
今日はこっち、明日はあっち、という揺れ方をすることもあります。指示を足したのに挙動が安定しない、と感じるときは、指示が少ないのではなく、矛盾した指示が多い可能性を疑ってください。
ちなみに、太るのは指示書だけではありません。AIが自動で書き溜めるメモや記憶ファイル、作業のたびに生まれる下書きや中間ファイルも、まったく同じ構造で増えます。
作るのは一瞬、消すには確認がいる。この記事は話がぶれないように指示書に絞りますが、「AIまわりのファイルは放っておくと太りやすい」は全部に共通すると考えています。
KOIYALでやっている5つの対策
対策をしていても、指示書が太る圧力は消えません。私たちの指示書も純増側です。狙いは太りを止めることではなく、いつでも消せる状態を保つことにあります。
消せる状態さえ保てていれば、定期的な棚卸しで痩せさせられる。消せない状態のまま太るのが破滅的記憶で、そこには落ちない、という守り方です。
第一に、指示には理由と日付をセットで書きます。「ダッシュを使わない(2026-07-22・表記の統一のため)」のように、いつ、何がきっかけで入ったかを残す。
これだけで、後から見た人が「この状況はもう無いから消せる」と判断できるようになります。
研究も、指示の理由をコメントとして残す方法を提案しています。正解の指示の数が分かる実験の環境では、理由をコメントとして書いた条件で、最適な指示の数に対する超過が、コメントなしの条件の211.3%から1.4%に下がりました(超過分の99.3%の削減)。
Claude Codeでは、CLAUDE.mdが自動で読み込まれるとき、コードブロックの外にあるブロック単位のHTMLコメント(<!-- メモ -->)は取り除かれます。
人間の保守担当者向けの理由のメモを、毎回のコンテキストを消費せずに残せます。
第二に、記憶の本体と索引を分けます。詳細は個別ファイルに書き、毎回読み込まれる場所には1行の索引だけを置く。2026年8月の時点で、私たちの記憶は88ファイルありましたが、AIが毎回読むのは84行の索引だけでした。
指示書そのものをデータベースにしないことで、記憶が太っても読み込みは壊れません。Claude Codeの自動メモリも同じ設計で、索引にあたるMEMORY.mdの先頭200行か25KBのうち、先に達するほうまでが会話の開始時に読み込まれ、詳細は別のトピックファイルに移されます。
第三に、繰り返す手順は指示書から手順書へ切り出します。指示書に書くのは原則だけにして、「画像を作るときの手順」「記事を公開するときの手順」のような工程は、必要なときにだけ読み込まれる別ファイル(スキルや作業手順書)にします。
指示書は憲法、手順書は業務マニュアル、という分担です。Claude Codeの公式ドキュメントも、複数の手順からなる内容や、コードの一部だけに関係する内容は、スキルやパス別のルールに移すよう案内しています。
2026年8月の時点で、私たちの指示書は、グローバル・プロジェクト・エージェント共通の3枚を合計しても約240行でした。これは数十本の手順書を外に切り出しているからです。
第四に、機械で判定できるルールは、文章からスクリプトに移します。表記ルールのような機械的に判定できる決まりは、指示書に書き続けるのではなく検査プログラムにして、指示書からは消します。
文章のルールは読み手(AI)の解釈に依存しますが、検査は条件に合わないものを機械的に落とします。Claude Codeの公式ドキュメントも、CLAUDE.mdは強制される設定ではなく文脈として扱われるので、AIの判断に関係なく操作を止めたい場合はフック(PreToolUse)を使うよう案内しています。
ルールを「AIへのお願い」から「機械の判定」に変えた瞬間、その1行は指示書に居座る理由を失います。
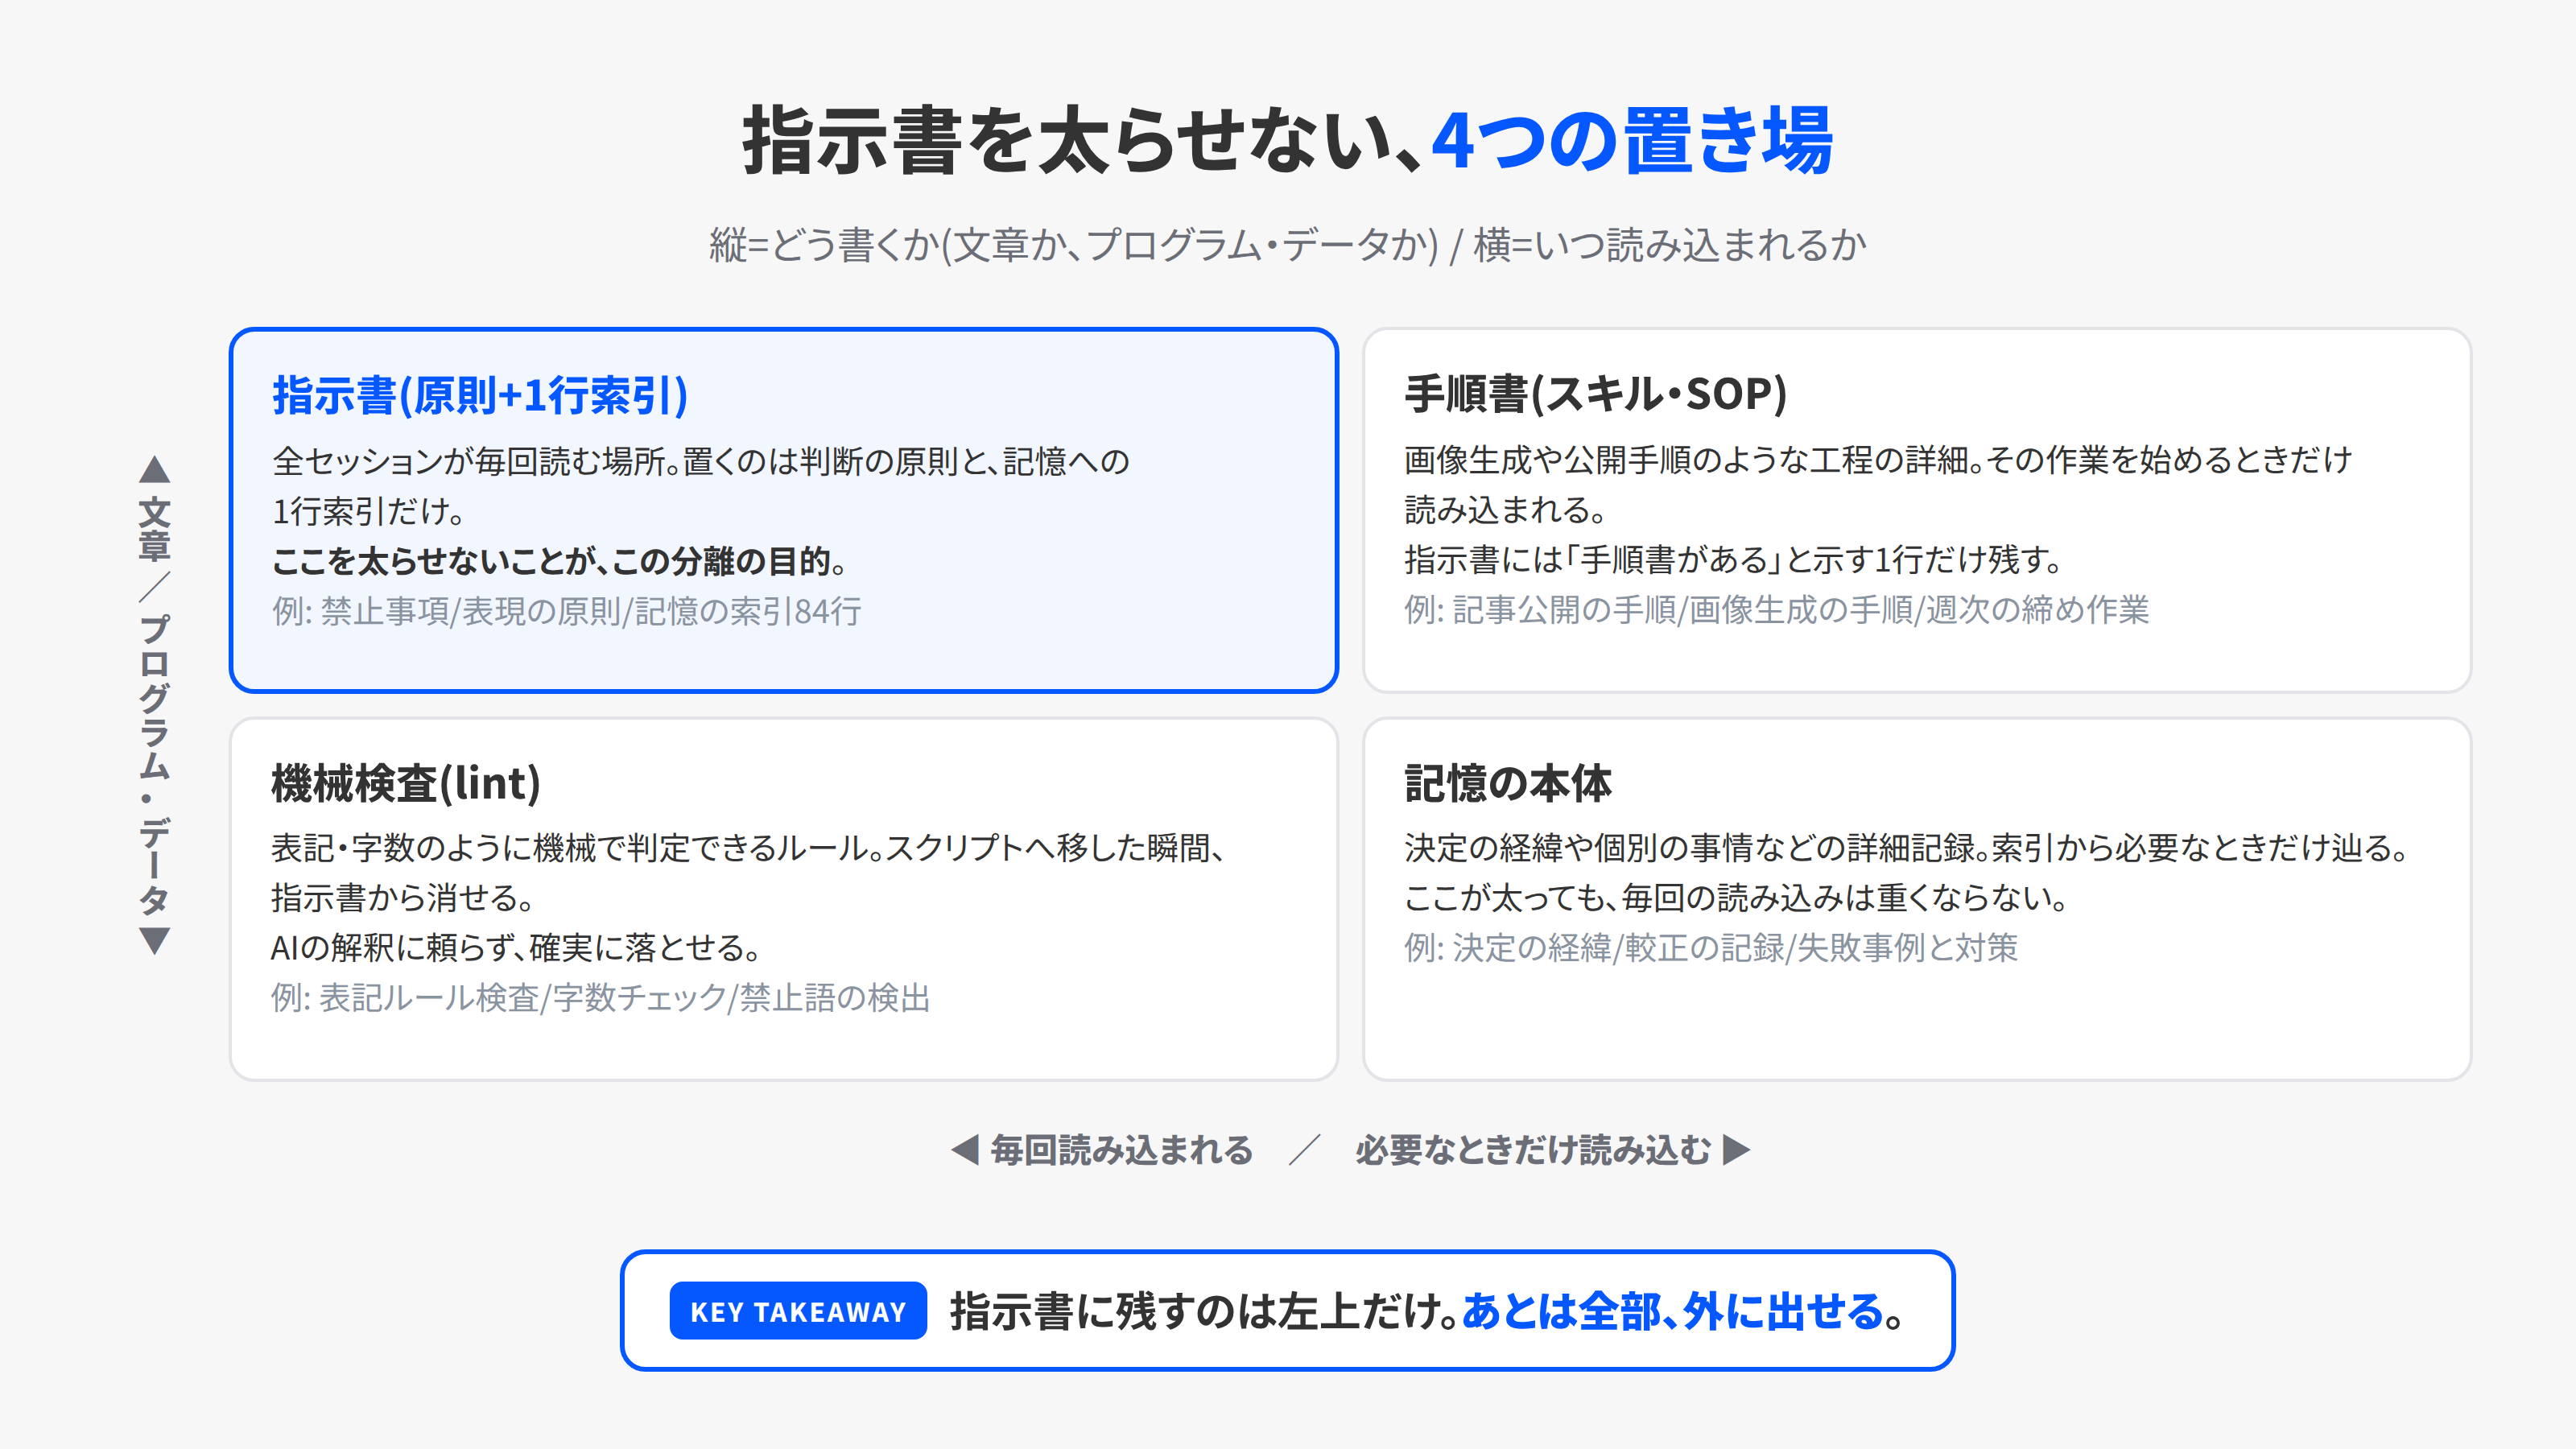
第五に、定期的な棚卸しです。チェックリストで指示書を定期監査し、理由が失われた指示や現実と合わなくなった指示を洗い出します。
このとき、いきなり削除せず一度アーカイブ用のファイルへ移します。自動で読み込まれる対象から外れるのでAIが毎回読むことはなくなりますが、記録は残るので、問題が出たら理由ごと戻せます。
削除を軽い操作にしておくことが、棚卸しを続けるコツです。逆に、実害が出た事故から生まれた指示は消しません。理由と事故の日付が書いてあれば、消さない判断も一瞬でできます。
棚卸しで確認したい3つの不備
5つの対策を入れても、運用が止まっていれば効果は出ません。棚卸しで確認したい不備を3つ挙げます。
1つ目は、ルールの本文と機械検査のずれです。たとえば、文書の文字数の規定を引き上げたのに、検査プログラムは古い基準のままになっている。第四の対策(ルールは機械へ移す)をしたつもりで、機械側の更新が漏れる例です。
2つ目は、止まっている定期チェックです。文書の鮮度を確認する仕組みはあるのに、しばらく実行されていない。仕組みがあることと、回っていることは別です。
3つ目は、切り出した手順書(スキル)の棚卸しの未処理です。指示書を痩せさせるために外に出した手順書も、放っておけば同じように増えます。1日で片付かない量なら、次回の棚卸しの日程に載せます。
ここから言えることは2つあります。対策を知っていることと、運用が回り続けていることは別だということ。そして、不備は探しにいかないと見つかりにくいということです。
棚卸しをカレンダーに入れる、機械検査とルール本文を同時に直す習慣にする。地味ですが、これしかないと思います。
チームで運用すると、消せない指示が増えやすい
ここまでは一人の運用でも起きる話でしたが、いま社内でAIエージェントに業務を任せる仕組みを作り始めている会社では、指示書をチームで触ることになります。そして複数人になると、消す判断はさらに難しくなります。
メンバーそれぞれが自分の困りごとを1行ずつ足す。ここまでは健全です。問題は削除側で、他人が足したルールは理由が分からないので、誰も消せません。
先の研究でも、2人以上が編集したファイルでは、1人で編集したファイルより、古い指示ほど消されにくい傾向が強く出ていました。
書いた本人が異動や退職でいなくなれば、そのルールは残り続けやすくなります。個人の指示書なら「なんとなく全部覚えている」でごまかせても、チームの指示書ではそれが最初から成立しない。理由と日付の記載は、チーム運用では礼儀ではなく必須の設計になります。
会社のAI利用ガイドラインも同じ構造です。事故や不安があるたびに禁止事項が1行ずつ増え、数年後には誰も理由を説明できない禁止だらけのルールが残り、現場で守られにくくなる。ルールは作り方よりも、育て方と痩せさせ方で差がつきます。
よく聞かれる2つの質問
この話をしたときによくいただく質問に、先に答えておきます。
1つ目は「整理そのものをAIにやらせればいいのでは」です。半分は正解です。重複している指示を探す、矛盾していそうな組み合わせを挙げる、理由が書かれていない行を洗い出す。
こうした候補出しはAIが得意で、私たちも棚卸しの下ごしらえはAIにやらせています。対応するバージョンのClaude Codeには、指示書の古い指示や矛盾、存在しないファイルへの参照を探す/doctor prompt-auditという機能もあります。
結果は修正案つきの報告として出され、適用を指示するまでファイルは変更されません。ただし、消すかどうかの最終判断は任せられません。
その指示にまだ価値があるかは、過去の事故や今後の計画といった、指示書の外にある事情で決まるからです。AIが挙げた候補を人間が裁く、という分担が現実的です。
そしてこの分担が成り立つのも、理由と日付が書いてあればこそです。根拠のない指示は、AIにとっても消してよいか判断できません。
2つ目は「指示書は何行までが適正ですか」です。答えは、行数だけでは決まりません、になります。Claude Codeの公式ドキュメントは1ファイル200行未満を目安にしていますが、それは読み込みの量の目安です。
100行でも全行に理由と日付があり、手順と判定が外に分離されていれば健康です。逆に30行でも、誰も理由を説明できないなら、もう破滅的記憶が始まっています。見るべきは行数だけではありません。
それができる指示書は、太っても管理できます。
これから始める会社へ。最初の1行から仕組みにする
この記事を読んでほしいのは、実はすでに指示書が太って困っている方よりも、これからエージェント運用を始める方です。
破滅的記憶は、始めてから直すより、始める前に設計で防ぐほうが、理由を後から復元する手間が少なくて済むと考えているからです。最初に決めることは5つだけです。
- 指示書の分担を決める。原則は指示書、手順は手順書、判定は機械検査、記憶は索引と本体。1枚に全部書き始めない
- 指示の書式を決める。1行ごとに理由と日付を必ず添える。書式が決まっていれば、誰が足しても消せる指示になる
- 機械に移す基準を決める。「機械で判定できるルールは指示書に書かない」を最初から原則にする
- 棚卸しの周期と担当を決める。月1回でも構いません。カレンダーに入っていない棚卸しは実行されにくくなります
- アーカイブの保存先を決める。消す先が用意されていれば、削除は怖い操作ではなくなる
導入初日にこの5つを決めておけば、半年後の指示書は同じ分量でも中身が違ってきます。全部が「消せる指示」でできた指示書は、太っても管理しやすいからです。
最後に。この記事に書いたことは、そのまま私たちの仕事です。KOIYALの伴走支援・法人研修では、次のことができます。
これから導入する会社には、指示書・手順書・機械検査・記憶の分担設計を、御社の業務に合わせて初日から一緒に作ります。
上の「最初に決める5つ」を、御社の言葉で決め切るところまでです。すでに指示書やAIルールが太り始めている会社には、棚卸しをお手伝いします。
理由と日付の復元、機械検査へ移せるルールの移行、消せる形への書き換えまで。そして運用を現場に根づかせたい会社には、メンバー自身が指示書を育てて痩せさせられるようになる法人研修を提供しています。
自分でやってみる方は、この記事の5項目をそのまま使ってください。任せたい方や壁打ち相手が欲しい方は、いまの指示書(まだ無ければ、これからAIに任せたい業務のメモ)を持ってお問い合わせへどうぞ。
現状を拝見して、どこから手を付けるべきかからお答えします。秘密情報の扱いを最初から設計する話は、1Password運用の記事も参考になります。
出典
- Kushal Chakrabarti「Why Does
CLAUDE.mdKeep Growing? Catastrophic Remembering in Agentic Coding」(arXiv:2608.11095): https://arxiv.org/abs/2608.11095 - Claude Code Docs「How Claude remembers your project」: https://code.claude.com/docs/en/memory
AGENTS.md: https://agents.md/- GitHub Docs「Adding repository custom instructions for GitHub Copilot」: https://docs.github.com/en/copilot/how-tos/copilot-on-github/customize-copilot/add-custom-instructions/add-repository-instructions