

会社サイトの記事をAIの学習に使われたくない。でも、Google検索から消えるのは困る。この2つは、Cloudflareの設定では両立しませんでした(各社のrobots.txtの指示を個別に書けば可能でしたが、守られたかどうかは分かりませんでした)。理由は単純で、GoogleやMicrosoft、Appleのクローラーは検索の索引づくりとAIの学習を1つのクローラーで兼ねているからです。学習を断るためにそのクローラーを止めると、検索からも消えます。
2026年9月15日、Cloudflareはこの二択を外す設定を入れました。名前はDisallow AI Training。検索の表示は保ったまま、学習だけを断ります。この記事は、この設定が何をするのか、既存のサイトの設定がどう移されるのか、そして自社サイトの28日分のクローラー記録から、入れるべきかどうかをどう判断したかを書きます。確認日は2026年9月29日です。
結論を先に書きます。
- 設定は4段階になりました。 Allow、Disallow AI Training、Block on pages with ads、Block。検索・学習・エージェントの3つの用途ごとに選びます
- Disallow AI Trainingは、検索と学習を兼ねるクローラーにだけ意味があります。 Apple、Google、Microsoftの3社がこの設定を守ると表明しており、学習専用のクローラー(Amazon、Anthropic、Meta、OpenAI)は検索に影響なく止まります
- AI検索に引用されたいサイトは、入れないほうがよい場合があります。 当社は入れていません。広告収入で成り立つサイトには、新規ドメイン登録時の推奨設定としてこれが提示されるようになりました(変更できます)
何が変わったか。検索・学習・エージェントの3つの用途
Cloudflareはクローラーを、何をしているかで3つに分けています。
- 検索(Search): 検索の索引を作るための巡回
- 学習(Training): モデルの学習や微調整のための巡回
- エージェント(Agent): 人の指示で、その人の代わりにページを取りに来るもの。ChatGPTやClaudeで「このページを読んで」と頼んだときのアクセスがこれです
問題は、1つのクローラーが検索と学習の両方をやっている場合です。Googlebot、Bingbot、Applebotがそうで、Cloudflareはこれを混合クローラー(mixed-use crawler)と呼んでいます。Cloudflareの数字では、検索のクローラーを止めているサイトは1%未満、学習を何らかの形で止めているサイトは17%です。検索は残して学習は止めたい、という組み合わせが確かにあるのに、混合クローラーには効かせられませんでした。
新しい設定は、用途ごとに次の4つから選びます。
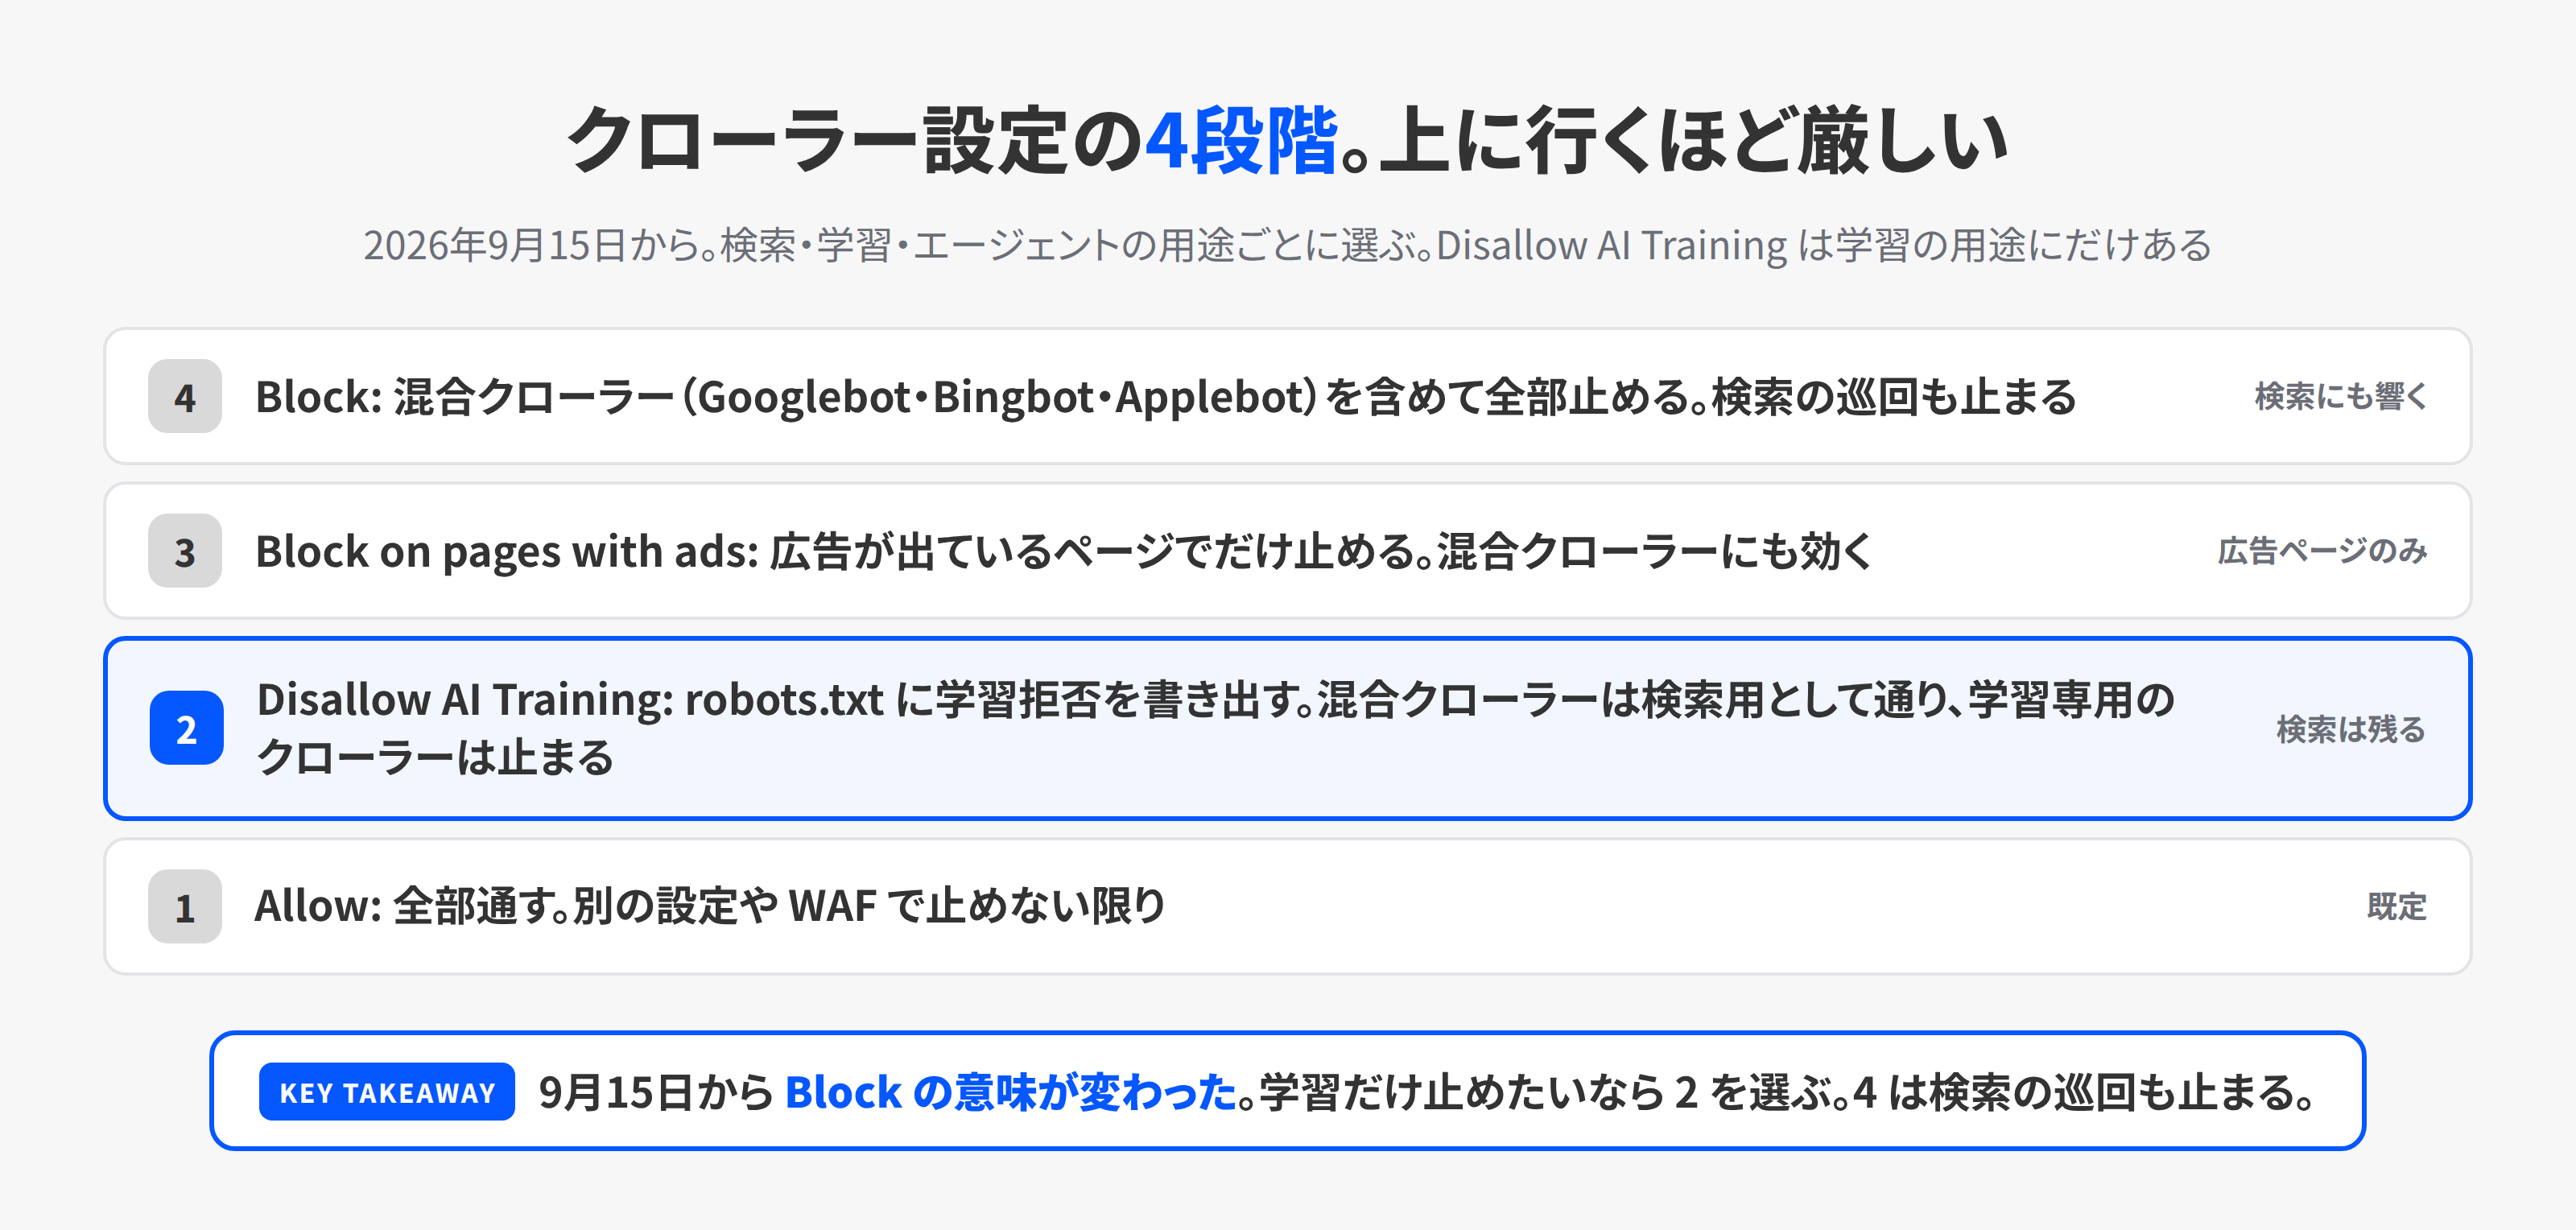
| 設定 | 何が起きるか |
|---|---|
| Allow | 全部通す(別の設定やWAFで止めない限り) |
| Disallow AI Training | robots.txtに学習拒否の指示を書き出す。Apple、Google、Microsoftの混合クローラーは検索用として通り続ける。それ以外の学習クローラーは止まる。学習の用途にだけ選べる |
| Block on pages with ads | 広告が出ているページでだけ、混合クローラーを含めて止める |
| Block | 混合クローラーを含めて全部止める。検索の巡回も止まり、検索での発見に影響する |
ここで大事な変更が1つあります。Blockの意味が変わりました。 これまでBlockは混合クローラーに効かず、検索を守る側に倒れていました。9月15日からはBlockが混合クローラーにも効き、検索の巡回まで止まります。学習だけ止めたい人はDisallow AI Trainingへ、というのがCloudflareの案内です。あわせて、旧来の「Block AI Bots」の一括設定と「Managed Robots.txt」は廃止され、新しい設定と、robots.txtに設定を反映するBot Preference Syncに置き換わります。
既存サイトの設定は、こう移される
多くのサイトは何もしなくてよい、と発表に書かれています。旧設定からの移行は次のとおりです。
| 旧「Block AI Bots」 | 新: 検索 | 新: 学習 | 新: エージェント |
|---|---|---|---|
| 未設定 | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
用途別の設定を既に使っていたサイトは、学習のBlockとBlock on pages with adsがDisallow AI Trainingに移ります。つまり、旧設定で学習を止めていたサイトは、9月15日以降、混合クローラーの学習も断る側に入ります。 検索の設定はそのまま引き継がれます。ただしBingについては、Microsoftの対応が始まるまでrobots.txt経由では伝わりません(後述)。
新しくドメインを登録するときは、広告で収益を得ているかどうかで、勧められる初期設定が変わります。
| 設定 | 広告収入なし | 広告収入あり |
|---|---|---|
| 検索 | Allow | Allow |
| 学習 | Allow | Disallow AI Training |
| エージェント | Allow | Block on pages with ads |
広告収入のあるサイトに厳しい既定が付くのは、広告は人がページを開いて初めて収益になるからです。学習はそのページの訪問を回答で置き換え、エージェントは人がいないのにページを取りに来ます。
3社がどう守るか。Bingは来年まで待つ
Disallow AI Trainingは、robots.txtに各社向けの指示を書き出す仕組みです。守る側の対応は3社で差があります。
- Google: robots.txtの
Google-Extendedへの拒否で学習から外れる。Googleは、これが検索順位に影響しないと明言している - Apple:
Applebot-Extendedへの拒否で学習から外れる。順位への影響なし。URL単位で何が使われたかを見る道具は来年の予定 - Microsoft: robots.txtでの学習拒否は2027年初頭の対応予定。それまでは
NOARCHIVEのmetaタグか、Bing Webmaster Toolsの削除機能で断る。Disallow AI Trainingを入れても、Bingには当面自動では伝わらない
Cloudflareはこの3社に加え、Amazon、Anthropic、Meta、OpenAIを、学習と検索のクローラーを分けている責任ある運営者(Accountable)として扱っています。分かれているので、学習用だけを止めても検索に影響が出ません。運営者ごとの対応状況はCloudflare Radarで公開されています。
自社サイトの28日分の記録から、入れるかどうかを決めた
当社は自社サイト(koiyal.com)のAIクローラーのアクセスを毎日Cloudflareの分析APIから取り、記録しています。2026年9月1日から28日までの28日分を、クローラーの種類と用途で集計しました。
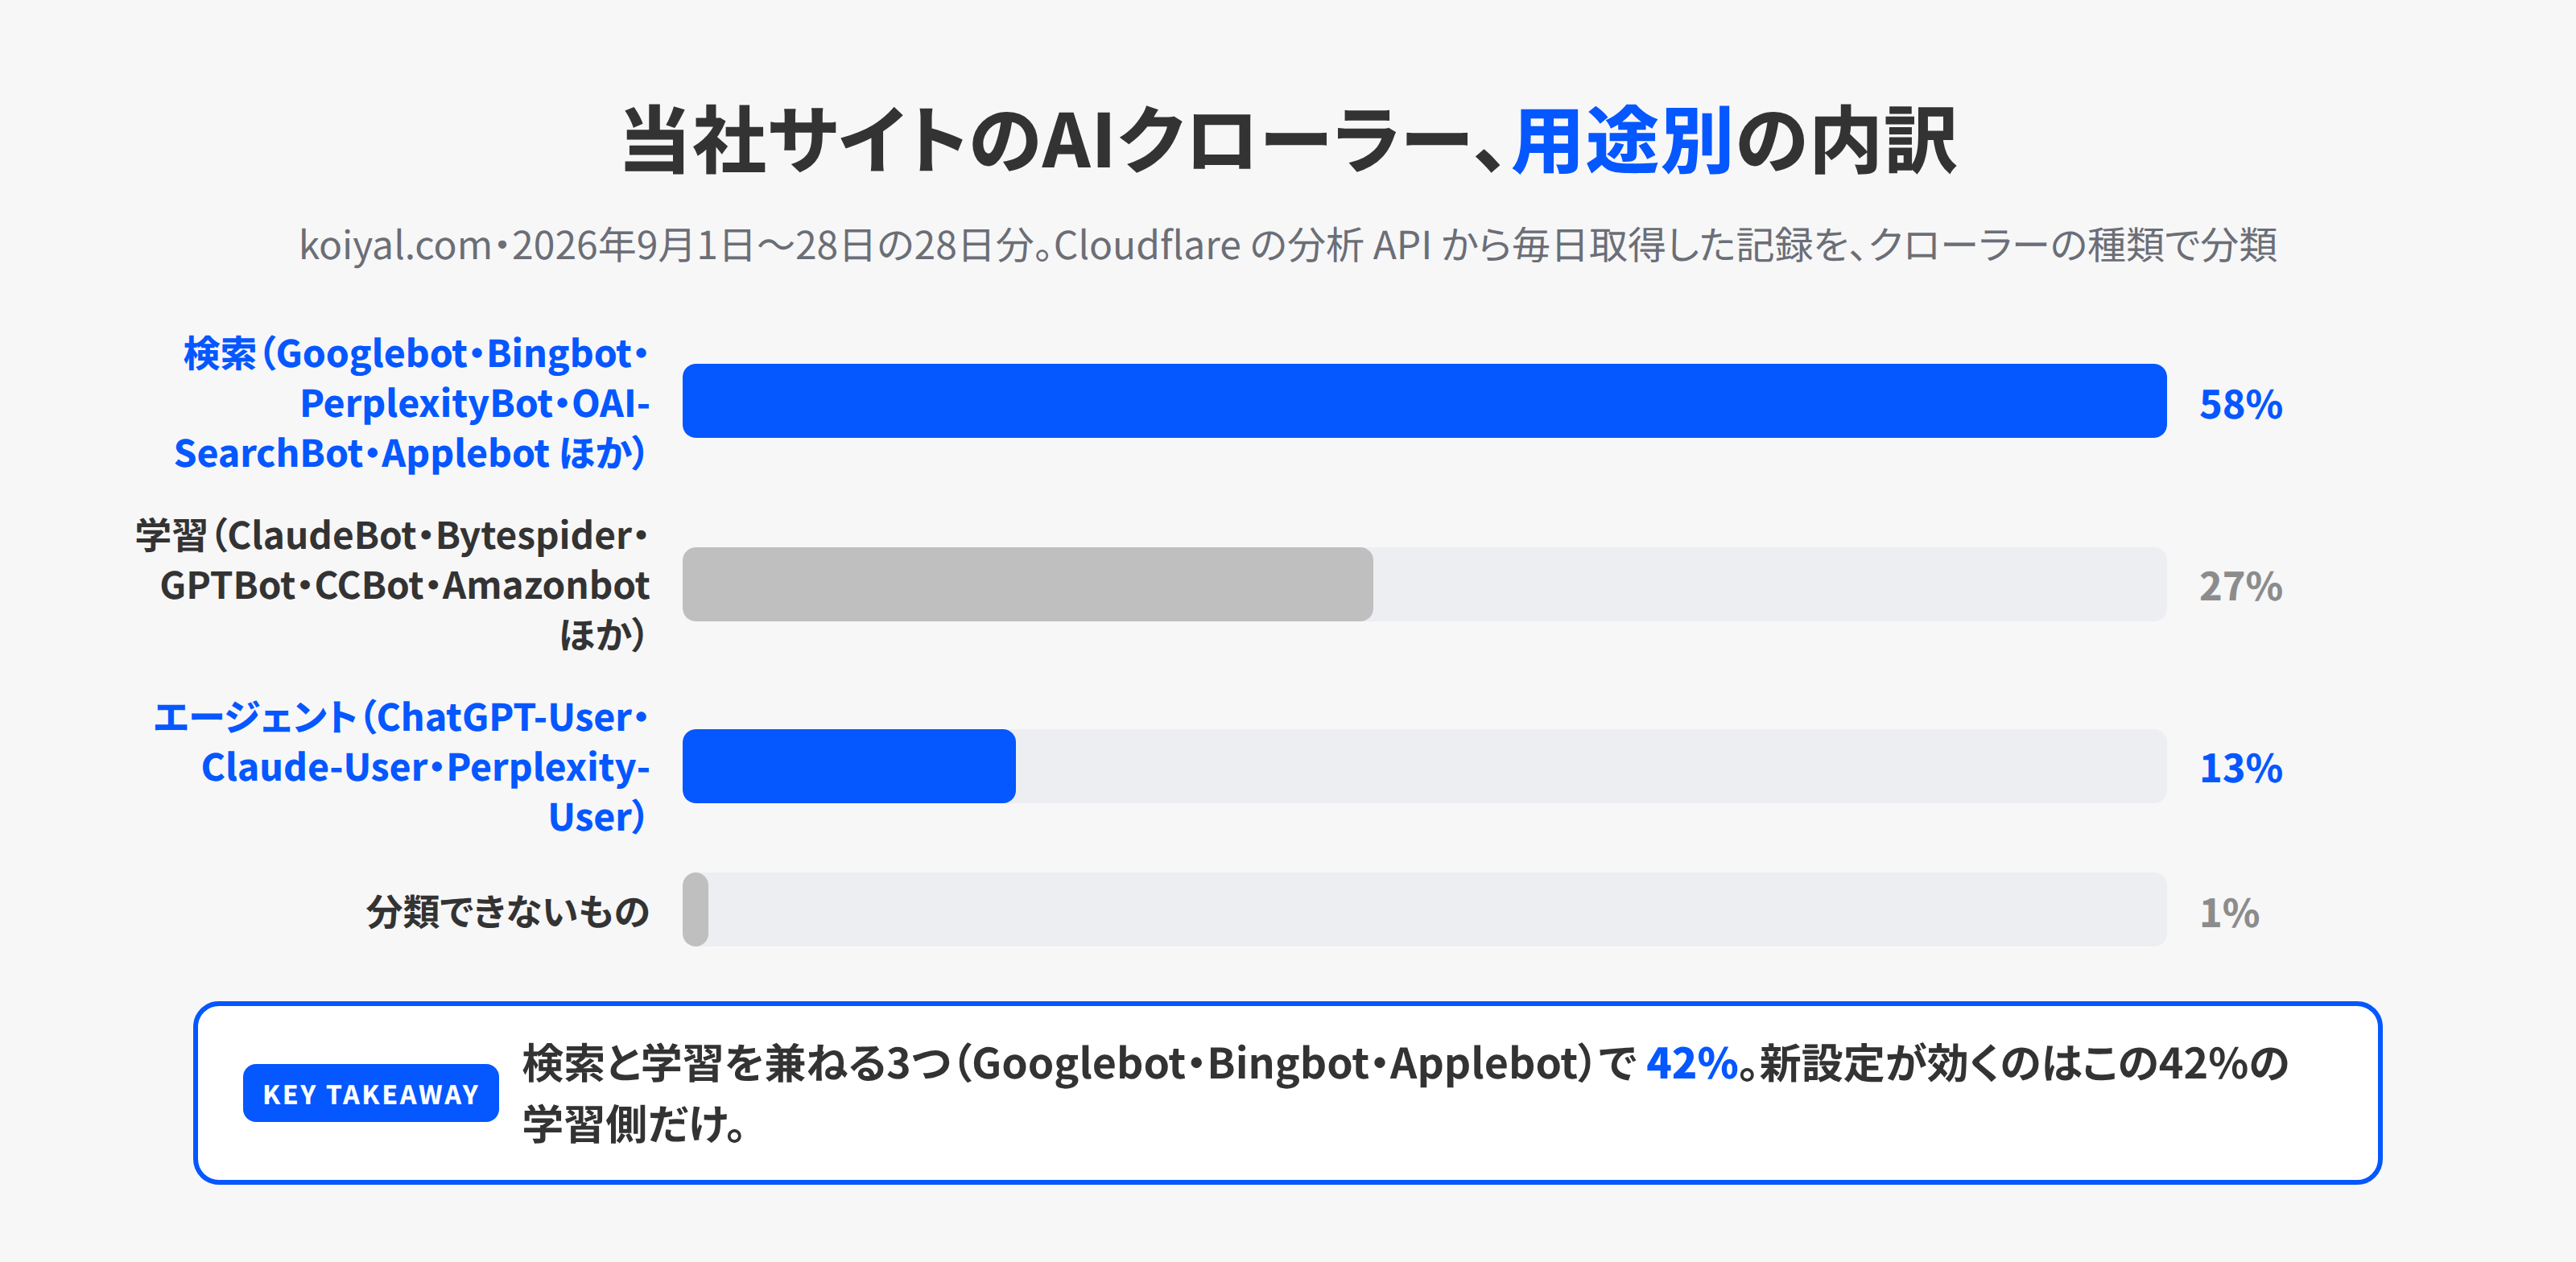
- 検索の用途が58%。 Googlebot、Bingbot、PerplexityBot、OAI-SearchBot(OpenAIの検索用)、Applebot、DuckAssistBot、Claude-SearchBot
- 学習の用途が27%。 ClaudeBot、Bytespider(ByteDance)、GPTBot、CCBot(Common Crawl)、Amazonbot、Metaのクローラー、Google-CloudVertexBot
- エージェントの用途が13%。 ChatGPT-User、Claude-User、Perplexity-User。人が「このページを読んで」と頼んだときのアクセス
- 分類できなかったものが1%
このうち、検索と学習を兼ねる混合クローラー(Googlebot、Bingbot、Applebot)は全体の42%です。Disallow AI Trainingが効くのはこの42%の学習側であって、残りの学習クローラー27%は、これまでの設定でも止められました。
当社の判断は、入れない、です。実際、当社サイトのrobots.txtには、GPTBotやClaudeBot、Claude-SearchBot、PerplexityBotを個別に名指しして許可する行を入れており、学習拒否の指示は書き出していません(2026年9月29日確認)。理由は3つあります。
- 当社の記事は、AI検索(ChatGPTの検索、Perplexity、Googleの要約)から引用されて問い合わせにつながる経路を持っている。エージェントの用途が13%あるのは、実際に読まれている印です
- 学習に使われることで失うものが、当社の場合は小さい。広告収入はなく、記事は会社の考えを広く知ってもらうために書いている
- 学習の拒否は、AI要約への露出と切り分けられていない。Cloudflareは来年、要約への露出量を別に制御できるようにすると予告している。その設定が来てから判断し直す
逆に、次のどれかに当てはまるサイトは、入れる側です。広告収入がある。有料の記事や会員限定の内容をAIに要約されると売上が減る。制作物(写真・イラスト・文章)そのものが商品で、学習に使われること自体が損失になる。Cloudflareが広告収入のあるサイトへの推奨設定をDisallow AI Trainingにしたのは、この線引きです。
設定の場所と、確認の仕方
Cloudflareのダッシュボードで、対象のドメインを開き、セキュリティの設定にある検索・学習・エージェントの各項目で選びます。反映後、https://自社ドメイン/robots.txt を開くと、Bot Preference Syncが書き出した拒否の指示が見えます。
入れた後に確認する点は2つです。
- Bingには自動で伝わらない(2027年初頭まで)。Bingでも学習を断りたい場合は、ページの
<meta name="robots" content="noarchive">を別途入れる - Blockを選んでいないか。 学習だけ止めるつもりでBlockを選ぶと、9月15日以降は検索の巡回も止まり、検索での発見に響く。旧設定の感覚で選ぶと事故になる
なお、当社の記録では各クローラーに5%から10%ほど403(拒否)の応答が混ざっています。これはAIクローラーの設定ではなく、WAFの管理ルールが特定のパスを止めているものです。クローラーの記録を見るときは、AIの設定で止めたのか、WAFで止めたのかを分けて読む必要があります。
KOIYALの見解
この設定で、サイト運営者がAIとの関係を「全部拒否か全部許可か」で決めなくてよくなりました。検索は許す、学習は断る、エージェントは広告のあるページだけ断る。3つの用途を別々に決められるのは、正しい方向です。
ただ、判断の土台は設定の知識ではなく、自社の記事が何のためにあるかです。当社のように問い合わせの入口として書いているなら、AIに読まれ、引用されるほうが目的にかないます。作品や有料の内容が商品なら、断るほうが目的にかないます。設定はその後です。
もう1つ。この記事で使った28日分の記録は、Cloudflareの分析APIを毎日呼ぶ小さなスクリプトで取っています。どのクローラーが、どのページを、どれだけ読んでいるかが見えると、AI検索での引用と問い合わせの関係を数字で追えます。設定を決める前に、まず記録を取ることを勧めます。
次の行動
- Cloudflareのダッシュボードで、自社ドメインの検索・学習・エージェントの現在の設定を見る(9月15日の移行で変わっている可能性がある)
- 自社の記事の目的を1行で書く。問い合わせの入口か、作品や有料の内容か、広告収入か
- 目的に合わせて、学習の設定をAllowかDisallow AI Trainingのどちらかに決める。Blockは検索の巡回も止まると分かった上でだけ選ぶ
- Bingの学習を断るなら、noarchiveのmetaタグを別途入れる
- AIクローラーの記録を取り始める。設定を変えた前後で、AI検索からの流入と問い合わせがどう動くかを見る
自社サイトのクローラーの記録を取り、AI検索からの引用と問い合わせを数字で追いたい。その仕組みづくりは、当社が社外の推進チームとして一緒に作ります。お問い合わせから、ドメイン数と、記事の目的を1行添えてご連絡ください。