

判断だけを返すAI、Jevを自社の運用に組み込んだ話は導入手順の記事に書きました。そこで1件だけ、人の判定と食い違った記事がありました。原因は質問の書き方にあると見ていたので、確かめました。
この記事は、同じ30件の記事に対して選択肢の基準(criteria)を4通りに書き換え、答えと確信度がどう変わるかを比べた実験の記録です。結論を先に書きます。
- 迷う記事のための逃げ道の選択肢を足す(規則にも1文添える)のが、副作用がいちばん小さい直し方でした。副作用はゼロではなく、1件が境目を割りました
- 選択肢に条件を足すと、狙った1件は直りますが、確信度が境目を割る記事が1件から4件に増えました。うち3件は狙いと関係のない記事です
- 複数に当てはまるときの規則を外すと、一致率は変わらないのに、間違った答えの確信度が上がりました。規則は答えより確信度に効いています
対象は少なく、確定判定のある記事は15件です。傾向をつかむための実験で、精度を保証する数字ではありません(実行日: 2026年9月24日、モデルはjev-1.13.0)。
何を比べたか
Jevには、判断の材料(state)と質問(questions)を渡します。今回の質問は1つで、MicrosoftとGoogleの公式更新の要約を読んで、自社の仕組みに反映する(self)、研修の題材にする(training)、発信のネタにする(sns)、見送る(skip)の4つから選ぶChoiceです。
導入手順の記事で食い違ったのは、Python in Excelの上級者向けの技を紹介した記事でした。本人は、今の受講者には重いので保留(4択ではskipに当たる)にした。Jevは研修の題材と答えた。質問には、研修の題材になるか、としか書いていなかったので、書いてあるとおりに答えた形です。
この話題は、9月14日号と9月17日号のダイジェストに、見出しと要約の書き方が少し違う形で2回出ています。導入手順の記事で食い違いとして挙げたのは9月17日号のほうで、確信度は0.96でした。本人の保留の判定が付いているのは9月14日号のほうです。今回の実験には両方が入っています。
そこで、基準の書き方を4通り用意しました。
| 変種 | 変えたところ |
|---|---|
| v1 現行 | 導入時のまま。規則は2文で、複数に当てはまるときは具体的な行動につながる方を選ぶ、読んでも行動が変わらない記事はskip |
| v2 条件を足す | trainingに「今の受講者に合う内容に限る。開発者向け・上級者向けはtrainingにしない」を足し、skipにも「今の受講者には難しすぎる内容」を足す |
| v3 逃げ道を足す | 選択肢に later(内容は良いが今は使わない。記録だけ残す)を1つ足し、規則にも「今は使わないが残したい記事は later」の1文を添える |
| v4 規則を外す | 2文の規則を両方消して、任務の説明だけにする |
対象は2026年9月1日から22日までのダイジェスト30件(Google 4回分20件、Microsoft 3回分10件)です。うち15件には本人の確定判定があり、内訳は研修の題材が13件、発信が1件、保留(skip)が1件です。残りの15件は判定がないので、現行の答えとの差だけを見ます。
結果
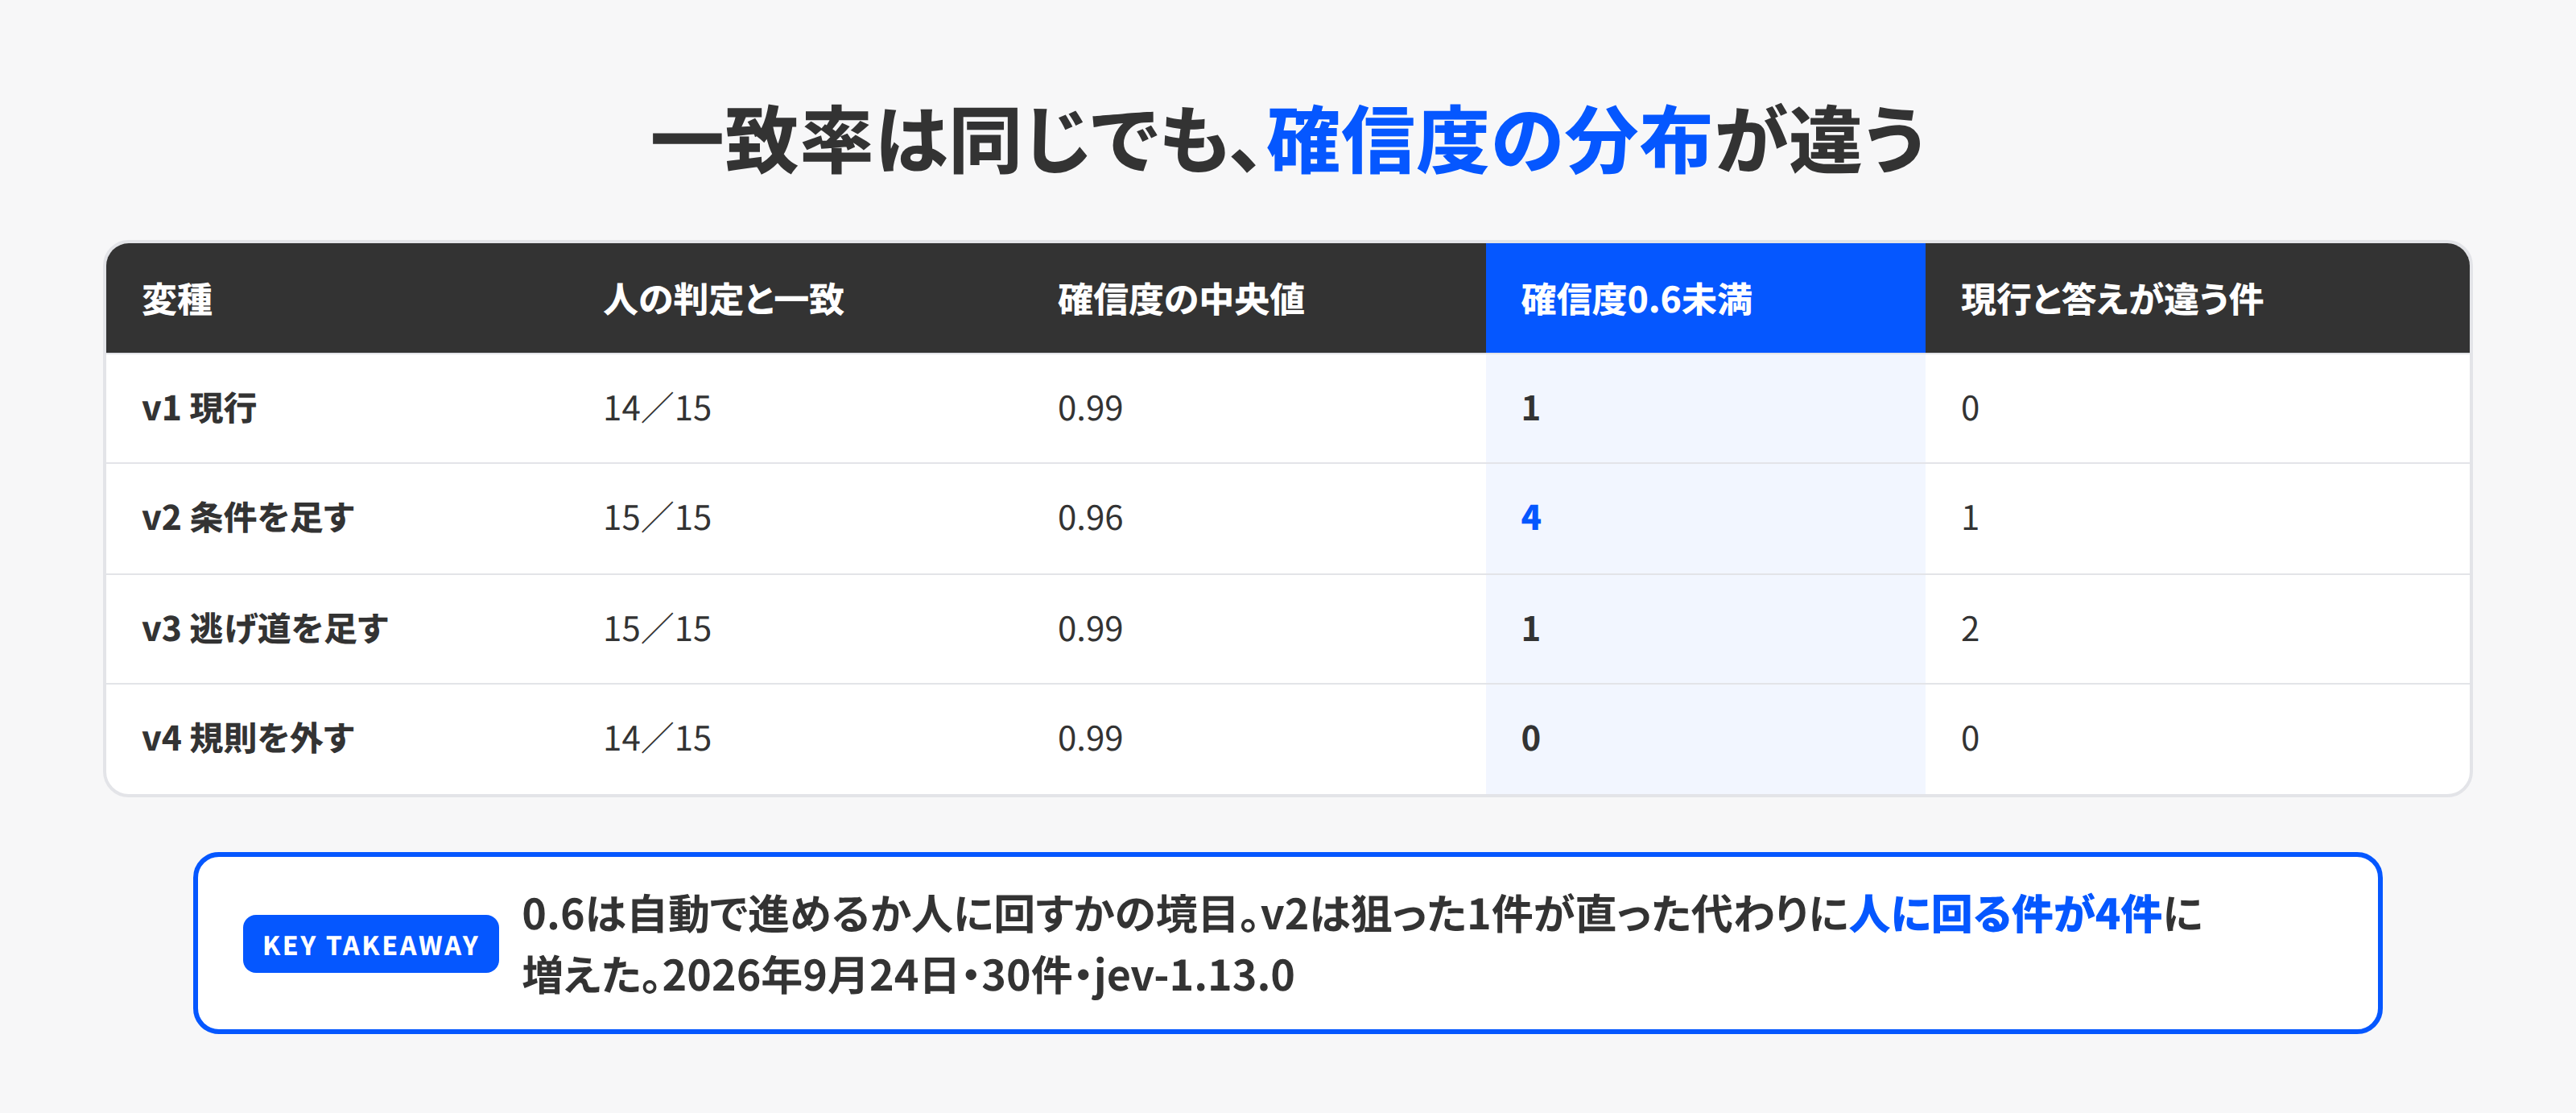
| 変種 | 人の判定と一致 | 確信度の中央値 | 確信度0.6未満 | 現行と答えが違う件 |
|---|---|---|---|---|
| v1 現行 | 14/15 | 0.99 | 1 | 0 |
| v2 条件を足す | 15/15 | 0.96 | 4 | 1 |
| v3 逃げ道を足す | 15/15 | 0.99 | 1 | 2 |
| v4 規則を外す | 14/15 | 0.99 | 0 | 0 |
確信度0.6は、当社が並走で使っている「自動で進めるか、人に回すか」の境目です。この境目より下に来た件は、答えが何であれ人が読みます。
数字だけ見ると、v2とv3はどちらも15件すべて一致しています。違いは確信度の分布に出ました。
逃げ道を足すと、迷う記事がそこへ動いた
v3で足したlaterを選んだのは2件で、どちらもPython in Excelの記事でした。9月14日号と9月17日号の両方がlaterに動き、確信度は0.62と0.92でした。他の28件は現行と同じ答えのままです。
副作用は1件ありました。新学期に使うGemini活用7選という一般向けの記事が、確信度0.63から0.53に下がり、境目の0.6を割りました。表のv3の「0.6未満1件」はこの記事で、現行で境目を割っていたPython in Excel(0.59)とは別の記事です。残りの27件の確信度は、ほぼ動いていません。
つまり、迷う記事に行き先を用意すると、迷う記事はそこへ動き、他の記事はおおむね動きません。ただしv3は、選択肢を足すのと同時に規則にも1文添えているので、どちらが効いたかはこの実験では切り分けられていません。
TypeSafe AIの公式ドキュメントも、日付の抽出を例に、記載なしに当たる選択肢を明示して、無いものを推測させないよう勧めています。今回の結果は、その考え方を自社の日本語の分類でなぞった形です。
条件を足すと、関係ない記事の確信度が下がった
v2は、trainingとskipの説明に受講者の条件を足しました。本人の判定が付いている9月14日号のPython in Excelは、skipの0.84に直りました。ただし同じ話題の9月17日号は、trainingの0.47のままで、答えは変わっていません。
ところが、確信度0.6を下回る記事が1件から4件に増えました。Office LTSC 2021のサポート終了(0.58)、SharePointのクラシック機能の廃止(0.36)、Driveの共有境界の設定(0.59)、それにPython in Excelのもう1本(0.47)です。答えはどれも研修の題材のままですが、確信が落ちています。
確率の動きを見ると、下がった分はskipには流れていません。Driveの共有境界ではselfが0.06から0.19へ、SharePointのクラシック廃止ではsnsが0.15から0.41へ、Office LTSCではselfとsnsがそれぞれ0.17と0.15へ増えました。skipが競合したのはExcelチャンピオンの1件(0.38)だけです。書き足した条件がtrainingの範囲を狭めた分、trainingと他の選択肢の境目が曖昧になった、という動き方です。狙った記事だけに効く条件は書けず、30件中17件で確信度が下がりました。
もう1つ、同じPython in Excelの記事が、見出しと要約の書き方が少し違う2本で、片方はskipの0.84、もう片方はtrainingの0.47と割れました。条件を足すと、入力の書き方の揺れにも敏感になります。
規則を外すと、間違いの確信度が上がった
v4は、2文の規則(複数に当てはまるときの選び方と、行動が変わらない記事はskip)を両方外しました。一致は14件で現行と同じです。違いは1件の外れ方に出ました。
現行では、本人が保留にした9月14日号のPython in Excelを研修の題材と答えつつ、確信度は0.59で境目の0.6を下回っていました。人に回る側です。規則を外すと、同じ答えのまま確信度が0.85に上がりました。自動で進む側です。
答えは同じでも、外し方が違います。確信度が低い間違いは人が拾えますが、確信度が高い間違いはそのまま通ります。複数に当てはまるときの規則は、答えを変えるためというより、迷っている状態を確信度に出させるために効いていました。
書き方の原則3つ
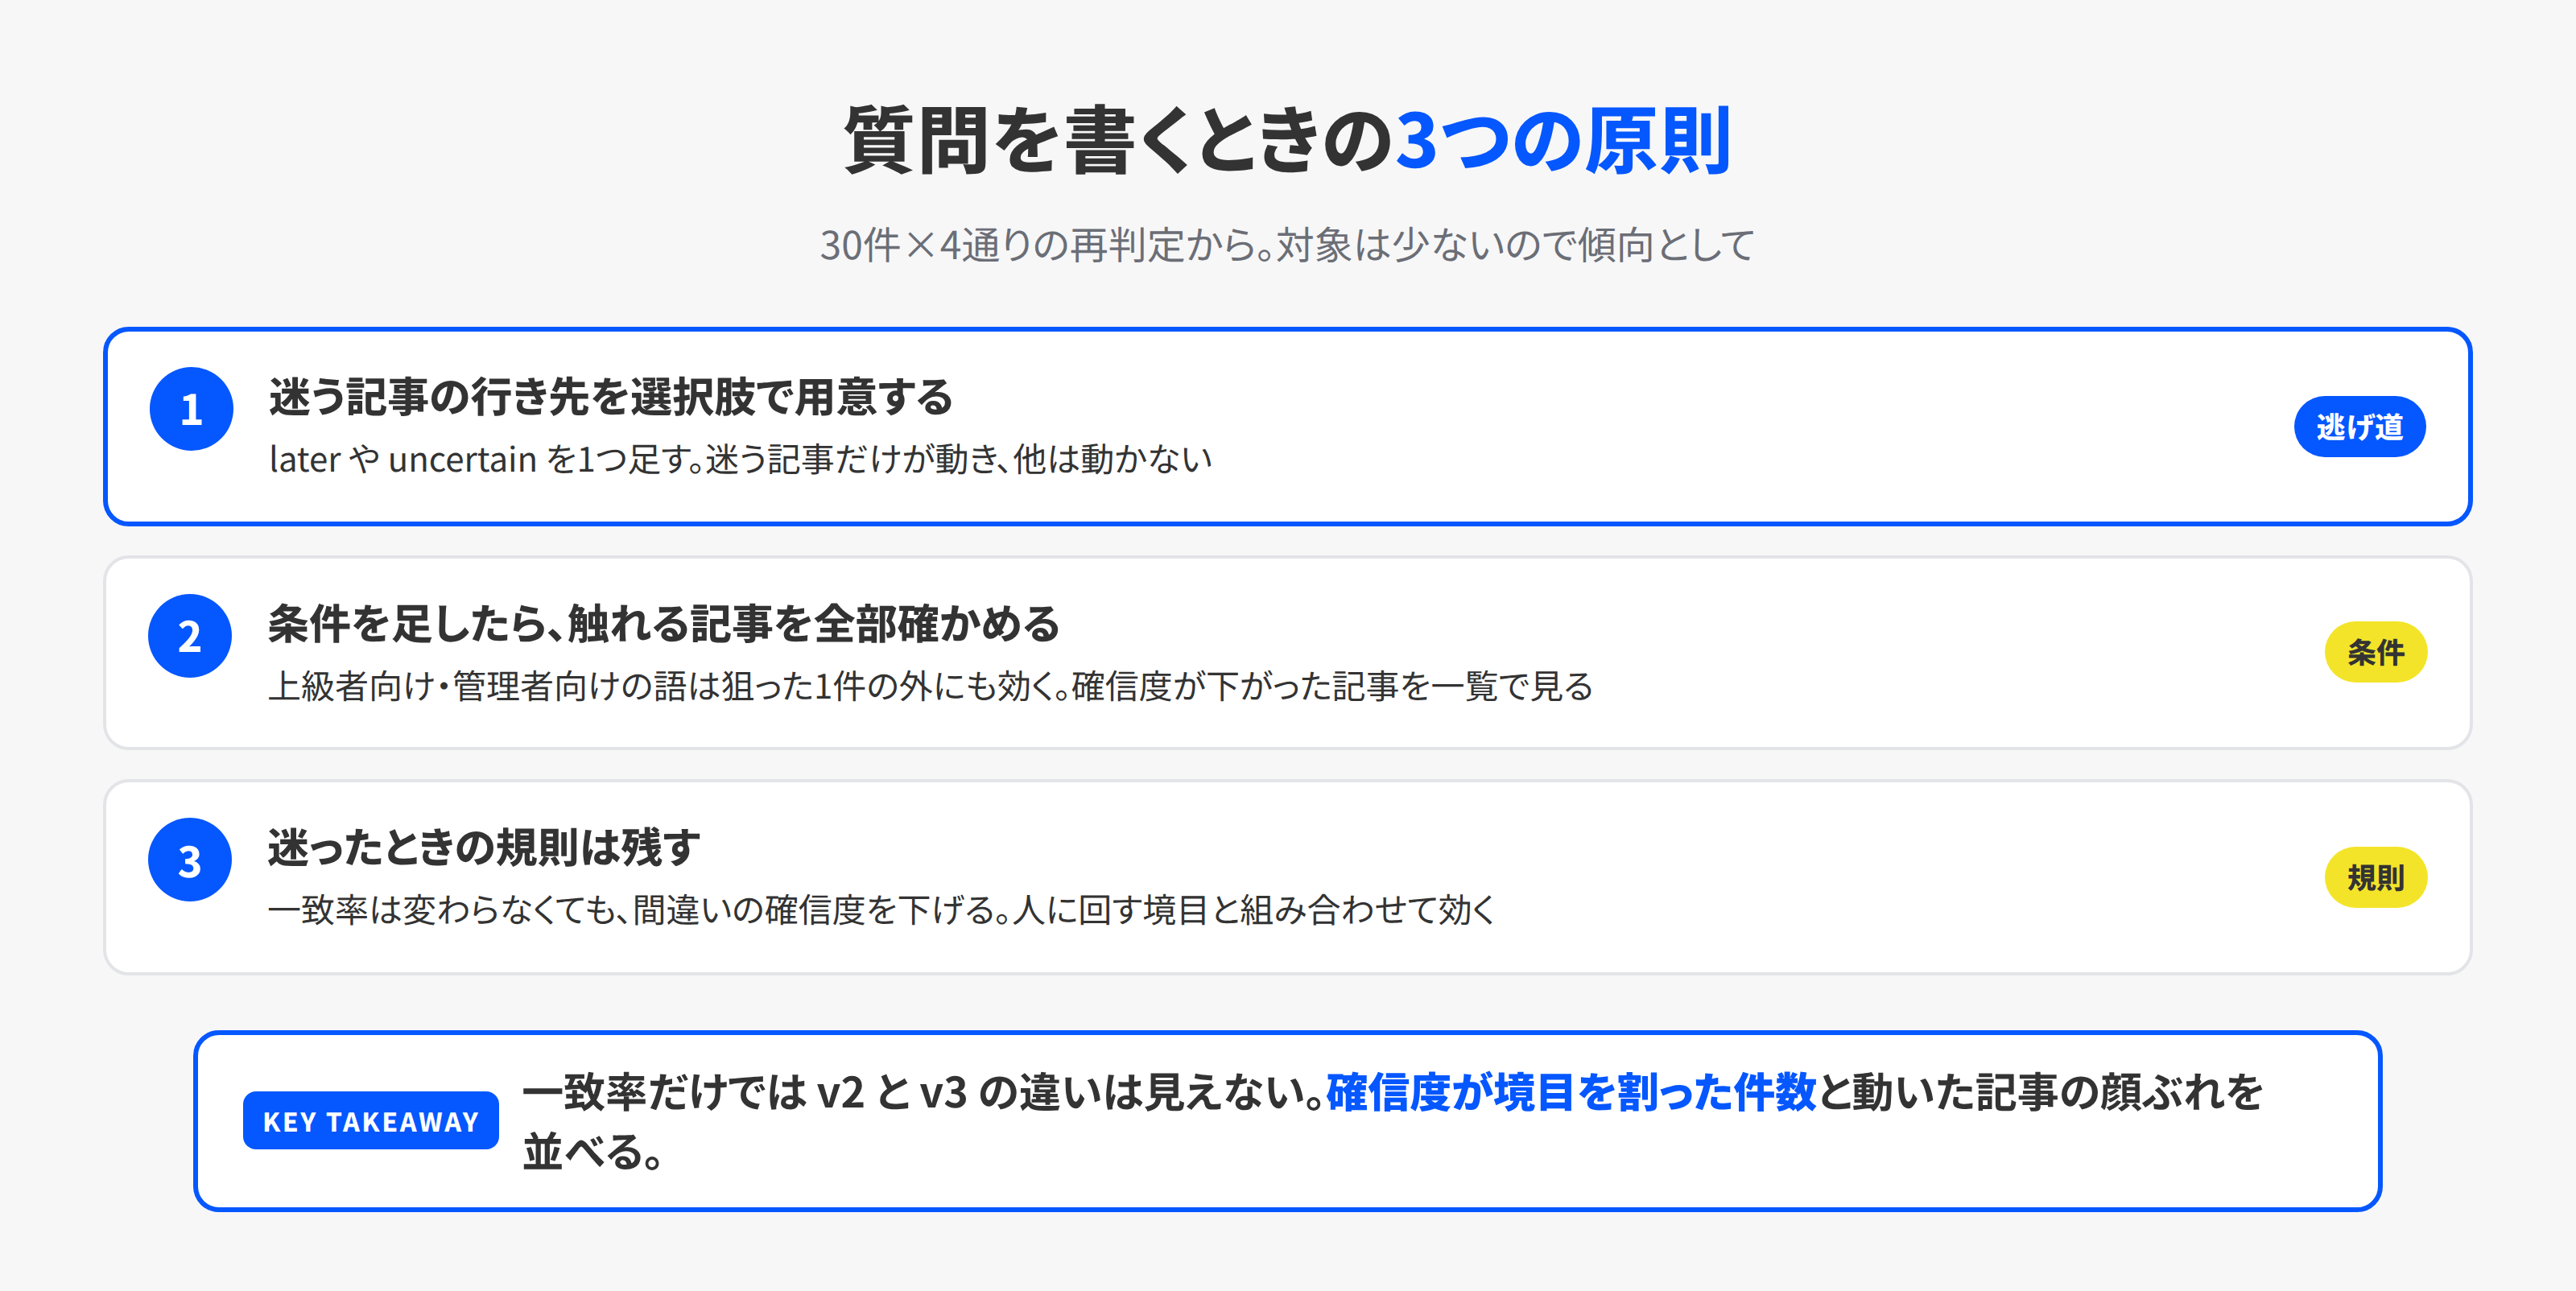
今回の実験から、当社が質問を書くときの原則を3つにしました。
- 迷う記事の行き先を選択肢として用意する。 条件で締め出すより、laterのような逃げ道を足す。迷う記事はそこへ動き、他の記事はおおむね動かない。それでも境目を割る記事は出るので、足した後に確認する
- 条件を足すときは、その言葉に触れる記事を全部想像する。 上級者向け、管理者向け、のような言葉は、狙った1件の外にも効く。足したら、確信度が下がった記事を一覧で確かめる
- 複数に当てはまるときの規則は残す。 一致率に差が出なくても、間違いの確信度を下げてくれる。人に回す境目と組み合わせて初めて効く
もう1つ、実験の設計の話です。一致率だけを見ていたら、v2とv3の違いは見えませんでした。確信度が境目を下回った件数と、答えが動いた記事の顔ぶれを並べて、はじめて書き方の副作用が分かります。並走の記録を残しておく価値は、ここにあります。
費用と時間
30件を4通りで判定して120回の呼び出しでした。入力は1件あたり平均869〜1,016トークン、応答は平均0.49〜0.53秒。入力100万トークンが0.042ドルなので、実験全体で0.005ドル、1円未満です。質問の書き方を変えるたびに全件を再判定できる費用なので、書き方を試すこと自体が安い作業になっています。
次にやること
当社の並走は、v3の形(laterを足した質問)に切り替えます。切り替え後も並走の記録は続け、人の確定判定との一致率と確信度の分布を毎週見ます。次の記事では、その記録から自動で進める境目をどこに置くかを決める手順を書きます。
自社の判断をAIに渡そうとしている方は、質問の文章を変えたら、答えの一致率だけでなく確信度の分布を見てください。答えが合っていても、確信度が境目を割った件数が増えていたら、その書き方は人の仕事を増やしています。